25 亿美元投给一个考场:中国数商的牌桌摆开了
过去六周,中国数据行业密集出了一组事件:彭博报道阿里将领投成立不到一年的 UniPat AI,估值 25 亿美元;腾讯混元上线专家平台「混元智囊团」;A 股老牌数据公司海天瑞声的定增问询函回复挂网,募投方向转向大模型数据集与评测。我的判断是,中国的「判卷」生意正式开桌了,但这桌牌的规则和美国不同:独立第三方长不出来,第三方数商能占的是一个夹层,夹层里值钱的东西需要重新辨认。
01牌桌上的四路玩家
第一路是模型公司前员工创业。UniPat 创始人李宽,北航本科、中科院计算所硕士、港科大博士在读,去年还是阿里通义 DeepResearch 项目的实习生、开源 Agent WebSailor 的项目负责人之一,2025 年 12 月注册公司,早期股东有 Monolith 和字节跳动的锦秋基金。Copula Lab 创始人梁丽此前负责 MiniMax 的 Agent 业务,技术合伙人蔡佳人做过 MiniMax 开源和 M2 系列的 Coding 后训练。智能知识的核心团队来自字节 Seed,6 月拿到锦秋基金和耀途资本的天使轮。
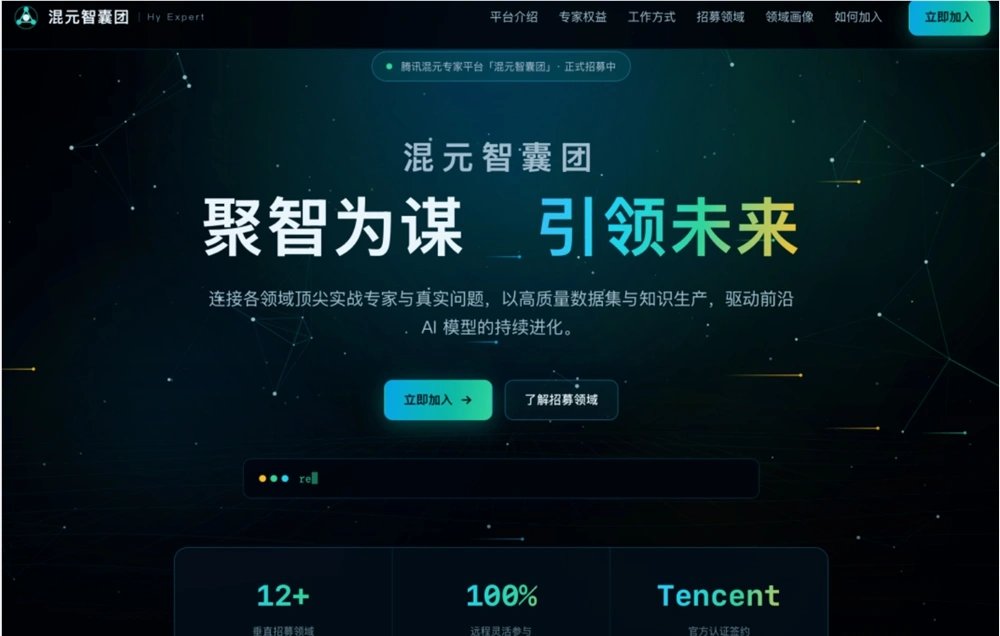
第二路是大厂自营专家平台。字节有 Xpert,腾讯 9 月 21 日推出混元智囊团:金融、法律、医疗、代码、翻译等十余个领域,专家线上接单、按质量动态评级,发腾讯官方认证的专家证书。模型公司不再只买数据,开始直接运营专家供给。
第三路是上市老数商转型。海天瑞声在定增材料里把募投方向写成「AI 大模型训练数据集建设项目」,并披露在论证评测服务能力,包括评测方案设计、评测数据获取和自动评测。靠语音采集标注上市的公司,现在要向市场讲考场的故事。
第四路是合成数据派。维纳智能让模型自己出题、自己生成推理过程和答案,做成 cQrA 四元组数据,联想创投投了千万美元种子轮。
02美国剧本在中国演不通
美国那桌牌的格局是第三方独立。Scale 向所有实验室卖数据,Mercor 向所有实验室卖专家,彼此不持股、不站队。Meta 入股 Scale 之后,Google 和 OpenAI 立刻收缩合作,这是独立性的价格。
中国这桌牌,三个位置都被模型公司自己占了。供给端,字节和腾讯自建专家平台,把专家的入口攥在手里。资本端,UniPat 的投资方名单里坐着阿里领投、腾讯跟投、字节锦秋是早期股东,红杉中国的 xbench 今年 1 月还和 UniPat 联合发布了 BabyVision 评测集——一家还没交割的公司,半个行业的巨头都已经是利益相关方。需求端,据行业报道,字节 2026 年给世界模型训练数据安排的预算是数千万元人民币,Coding 数据投入排第二,这类核心后训练环节,模型公司明确留在内部,外部团队能承接的是专家组织、任务生产和部分环境构造。
还有一个反向的事实。Dimension Capital 访华后给出资人的内部信里写到,Mercor、AfterQuery、Turing 这些美国数据公司,已经成了中国大模型公司的供应商。中国模型公司现阶段愿意向独立的海外数商下单,同时在国内用资本和自营平台把同赛道公司变成自己人。判卷权必须可控,这是国内牌局的底层规则。
03专家数量是通胀数字,壁垒在 failure mode
夹层里的公司,对外宣传的数字已经通胀。智能知识的一面千识说连接了 5 万多名领域专家,原壤智能的 TalentsAI 也说 5 万名专家入驻、覆盖 300 多个细分学科。两个 5 万摆在一起,这个数字就不再是壁垒,注册专家里有多少能稳定交付高难度任务,外人无从验证。
真正能拉开差距的是两样东西。
一样是对 failure mode 的知识。UniPat 的做法是先造足够难的任务找到模型的能力缺口,再围绕缺口生产数据和评分标准,然后实际训练模型,在留出集和外部基准上验证有没有提升。它的 ExpertEval 覆盖医疗、金融、法律,3213 个专家案例,平均每题配 21.83 条评分标准,重点盯「关键负面项」。Copula Lab 的出发点同样是从模型在真实任务里为什么失败反推任务、轨迹和 Rubric。这套「发现缺口—生产信号—训练验证」的流程,回答的是数据公司最难的问题:这批数据到底有没有让模型变强。
另一样是验证器的工程化。智能知识的 Terminal RL Data 不只交题目和答案,还交 Docker 环境、测试脚本、Oracle 参考解法和运行轨迹。有意思的细节是,它把数据生产平台 Xpert Studio 的会员价定到 3000 元一年——工具本身已经卖不上价,值钱的只剩工具里沉淀的质检协议和专家网络。
04考场的独立性
UniPat 既发布基准,又生产训练数据,还亲自训练模型。彭博的报道出来以后,不止一篇分析点到这个矛盾:一家公司如果参与某个模型的训练,又负责评价这个模型,外部客户会质疑它的结论。模型公司入股评测公司,评测的公信力怎么算,这在美国是 Meta-Scale 事件里已经吵过一遍的问题,中国现在轮到 UniPat 来回答。
考场自身的刻度问题,中国实验室自己心里也有数。腾讯混元、复旦和清华 10 月放出的 ExplorationBench,专门造了两个模型不可能备考过的「异星世界」测探索能力,论文里的诚实段落值得读:同一个系统同样预算重跑探索,Kimi K3 的终点从 5.7% 到 79.0% 都有;按三次最佳排名和按均值排名,名次会换位。发榜单的人自己承认单一分数会骗人,这是这个星期里最诚实的评测文本。
牌桌刚摆开,钱和人都已就位。接下来值得盯的不是谁家的专家更多、估值更高,是验收权落在哪:模型采购、企业部署和训练流程里,采信谁家的「这个模型能用」。UniPat 那 25 亿美元估值,买的正是这个位置。昨天的日报写过买方怎么变,今天这桌卖方怎么坐,是同一条产业链的两面。
05常见问题
中国会不会长出 Scale AI 那样的独立第三方数商?
短期不会。供给端字节和腾讯自建专家平台,资本端阿里、腾讯、字节基金都进了 UniPat 的股东名单,需求端核心后训练环节留在模型公司内部。第三方能占的是专家组织、任务生产和部分环境构造这个夹层,独立性让位于可控性。
看一家新数商靠不靠谱,该看什么数字?
别看注册专家数,家家都报 5 万。看三样:交付物里有没有可执行环境和验证器,而不只是题目和答案;能不能拿出训练前后的留出集对比,证明数据让模型变强;评分标准的密度,比如 UniPat 的 ExpertEval 平均每题 21.83 条。
模型公司投资评测公司,发布的分数还能信吗?
要打折看。UniPat 的股东里有阿里、腾讯和字节系基金,它既发基准又做训练,独立性天然受质疑。Meta 入股 Scale 后 Google 和 OpenAI 收缩合作,就是市场对这种结构的定价。用它的基准做决策时,要确认测试集与训练数据隔离,并保留第三方复测的权利。