2026,VC去机器人血汗工厂当包工头了
「数字世界缺数据是新闻,物理世界缺数据是常识。」
如果你觉得前两年大模型公司抢算力、囤显卡已经够疯狂了,那2026年的具身智能赛道,正在用真金白银给你表演什么叫真正的FOMO(错失恐惧症)。
按照36氪和IT桔子的统计,2025年具身智能赛道一共发生了329起融资,总额约398.9亿元人民币。这个数字直接同比暴涨了约三倍,把隔壁还在苦哈哈算ROI的纯软件AI应用衬托得像个无人问津的留守儿童。
到了2026年,热钱砸起来更是连演都不演了。逐际动力(LimX Dynamics)反手就是一个2亿美元的B轮;它石智航更猛,Pre-A轮直接融了超4.5亿美元,估值原地破200亿;千寻智能则在短短30天内累计融资30亿元。
账面上动辄几十上百亿的阵仗,已经足够让当年「AI六小虎」的募资节奏显得像在过家家了🥵
钱是到位了,机器人本体也造得越来越像人了。从后空翻到拧螺丝,各家的宣传片拍得一个比一个科幻。
所以最后发生了什么?
这帮身价百亿的机器人,一旦离开写死代码的实验室演示环境,到了真实世界里,连叠一件没见过的衣服、精准抓起一个软塌塌的快递袋都费劲。
道理很简单。
过去三年,数字世界的大语言模型之所以能一日千里,是因为人类过去几十年在互联网上留下了海量的文本。OpenAI和Anthropic们只需要像抽水机一样把全网的语料抽干,就能喂出一个绝顶聪明的Chatbot。
但物理世界给过机器人这种白嫖的机会吗?根本没有。
机器人要在现实里干活,它需要的不是「怎么写一首关于端茶倒水的诗」,而是极其具体的「动作+结果」配对数据——关节转多少度、用多大力度抓握、抓滑了怎么调整。这种数据在互联网上压根就不存在。
既然网上没有,那就只能硬造。
当所有人都在盯着台面上的明星本体公司看他们能翻几个跟头的时候,聪明钱已经悄悄绕到了后厨,开始往更上游、更苦逼的数据环节狂涌了。
那么问题来了,这帮做具身智能的聪明人,到底是怎么给机器人无中生有造数据的?
目前行业里摸索出来的,无非就是三条路。而且非常有意思的是,这三条路每一条看起来都像是通天大道,但走进去全是坑。
第一条路是仿真合成。既然在现实里造数据又慢又贵,那就在虚拟世界里建个物理引擎,让成千上万个虚拟机器人在里面24小时不间断地试错。这条路速度快、成本便宜,而且完全可以规模化量产,英伟达的Isaac生态就是当之无愧的旗手。
听起来很完美对吧?但凡事都有个代价,仿真路线最大的死穴,叫sim-to-real(从仿真到真实)的鸿沟。你在显卡渲染出来的虚拟厨房里把洗碗练上一亿次,到了真实世界,只要洗洁精泡沫的摩擦力跟物理引擎的参数差了一点点,机器人照样当场把盘子给你摔个稀碎。
既然纯靠虚拟世界不靠谱,那就只能走第二条路:遥操作真采。
翻译成人话:请真人在现实里手把手教机器人干活。
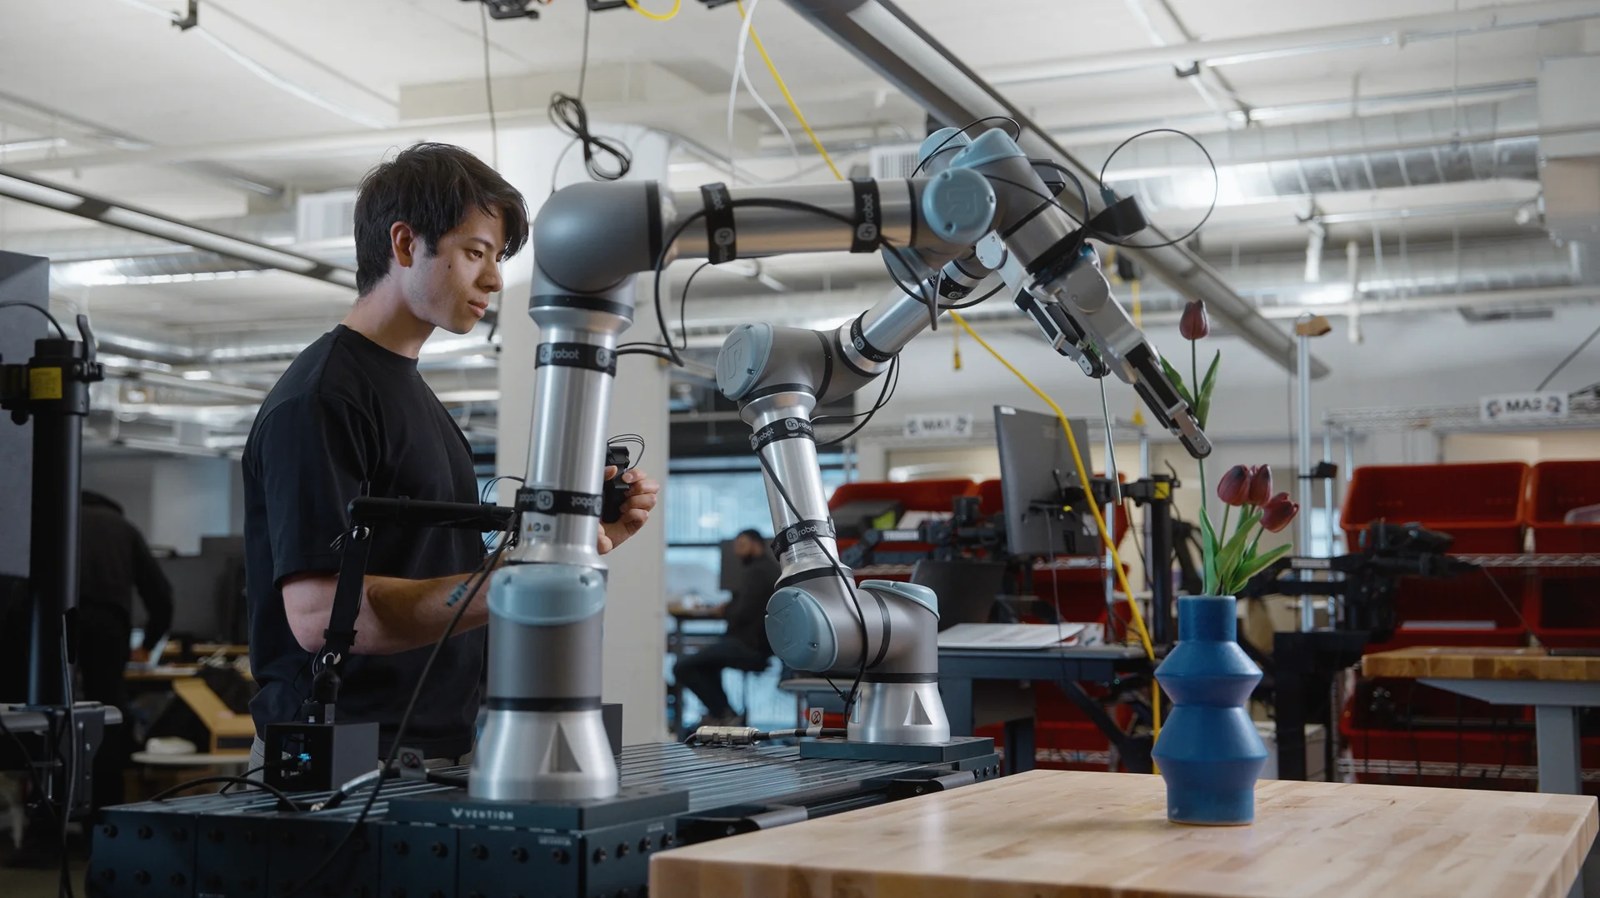
这就是目前整个行业最赛博朋克、也最黑色幽默的景观。一个个数据采集员戴着VR头显,手里握着主控臂,像提线木偶一样带着机器人做各种真实动作。你抬手,机器人也抬手;你抓杯子,机器人也跟着抓杯子,系统就在后台把这一套动作和视觉结果完整记录下来。
这活儿现在有多火?上海、天津已经在直接建大型的数据采集基地,完全是把机器人数据采集当成新时代的「新基建」在搞。一排排机器人在厂房里跟着打工人同步做广播体操,不知道的还以为是上一轮「AI四小龙」时代的数据标注工厂借尸还魂了😭
但这种苦力活儿里藏着一个巨大的深坑,叫本体碎片化。因为每家机器人的构型、自由度、传感器位置都不一样,你在A家机器人身上辛辛苦苦采集出来的几万条动作数据,直接导给B家的机器人,它是根本没法用的。这种无法通用的物理限制,直接让真采数据的复用率低得令人发指。
至于第三条路,则是打起了互联网视频的主意。网上的视频数据量确实是最大的,人类干活的录像应有尽有。但视频只是平面的像素,里面根本没有机器人需要的「动作标签」和力反馈参数。拿这玩意儿训练机器人,最多只能当个预训练阶段的「看片」素材,让模型大概知道世界长啥样。真要上手干活,光看片不练,谁来都是眼高手低的废物。
你看,仿真有鸿沟,视频没标签,真采不通用。
但恰恰是因为这三条路都不完美、谁也替代不了谁,花旗在2025年12月的一份报告里才下了一个极其笃定的判断:Physical AI(物理AI)需要大量重复性的训练数据采集,无论是通过仿真、真实世界,还是把两者结合起来,这个环节谁都绕不开。
大的也来了。
既然绕不开,那卖铲子的人就彻底迎来了泼天富贵。早在2025年9月21日,TechCrunch的报道就已经把「Physical AI Data」单独列为了整个数据行业的新分层之一;而大洋彼岸的数据巨头Scale AI,更是早就上线了专门的Physical AI数据业务,从人类示范采集到建数据采集工厂,巨头卡位的动作比谁都快。
国内的一级市场自然闻着味儿就冲上去了。诺亦腾机器人、光轮智能、觅蜂科技这些做具身数据的供应商,最近接连完成了数亿元级别的融资。
你再细看一眼资方名单,含金量更是吓人。就拿觅蜂科技的新一轮融资来说,不仅有红杉中国这些老股东继续追加,更是直接由中国电信领投、张江集团跟投。国家队、产业资本和顶级美元VC罕见地凑在一张牌桌上,全在给「机器人数据工厂」疯狂下注👍
看到这儿,可能很多老哥已经在摩拳擦掌,准备回老家县城租个厂房、招几百个力工,挂牌成立「具身智能遥操作基地」,去赚这波风口的快钱了。
如果真是这么想,那我劝你先冷静一下,去翻翻当年「AI四小龙」时代那些数据标注外包公司的坟头草有多高。
为什么上一轮做人脸识别、做自动驾驶数据标注的包工头们,最后全都沦为了利润薄如刀片的血汗工厂?
因为单纯的「采集」和「标注」,本身是没有任何壁垒的。只要砸钱买设备、招人按小时计费,谁都能干。当上海和天津的采集基地全面铺开之后,纯靠堆人头的遥操作采集,很快就会卷成单价白菜化的苦力外包。
在这个环节里,真正稀缺的从来都不是「采」,而是「懂任务」。
什么叫懂任务?
你要让机器人学会在杂乱的桌面上收拾餐具,这事儿不是让力工戴着VR眼镜随便抓两百次就完事了。你首先得想明白:这个任务在算法层面到底该怎么定义?抓取过程中的成功和失败边界在哪里?怎么给每一个动作打分?当人类专家做出示范的时候,怎么从那些冗余的动作里,精准地标出真正可训练的信号?
发现了没有?这套逻辑,和今天数字世界里最顶尖的大模型数据团队在干的「出难题、定评分、造可验证环境」,完完全全是同一门手艺🤓
在大语言模型进入推理阶段(Reasoning)之后,随便抓点网页语料已经没用了,模型厂真正渴求的是高难度的数学代码题、是严谨的强化学习环境、是懂行的专家给出的判分标准。把这套手艺平移到物理世界,具身智能真正卡脖子的,同样不是廉价的动作录像,而是高质量的任务设计与专家级的数据洗炼。
历史剧本往往就是这么乏味地重演着。
在风口刚起的第一阶段,靠着卖力气、堆设备的采集外包厂一定会吃到第一波红利,账面营收看着无比热闹;但只要行业稍微往前走半步,绝大部分的利润和话语权,一定会迅速向那些真正「懂任务设计」的玩家手里迁移。
当然,具身智能这场豪赌还有一个最大的悬念:在数字世界百试百灵的Scaling Law(规模定律),在物理世界里到今天都还没有被彻底验证。
谁也不敢打包票说,只要给机器人喂够了一千万小时的遥操作和仿真数据,它就一定能涌现出像ChatGPT那样举一反三的通用智能。万一物理世界的Scaling Law根本跑不通,那今天砸进数据工厂的几百亿热钱,最后可能只换来了一堆极其昂贵的电子垃圾。
但创投圈的迷人之处不就在这里吗?
没有被验证,既是最大的风险,也是所有先发者手里最值钱的期权。毕竟在牌局揭晓底牌之前,无论台上的机器人到底是真聪明还是假把式,台下那些掌握了「定标准、出难题」手艺的数据军火商,都已经把门票钱稳稳揣进兜里了。
(顺便插播一条硬核技术流线索:如果你正在为具身模型或大模型寻找真正「懂任务」的高质量数据,不妨看看我们 DataMining。我们由北京大学计算机学院软件所博士生团队组建,此前曾深度服务字节、阿里、腾讯。不同于单纯堆人头的采集厂,我们在具身线专注于高门槛的 grounding QA、导航 SFT 与 DAgger 专家数据,同时在数字线产出 HLE-vl 多模态专家题——无论数字世界还是物理世界,底层跑的都是同一套「出难题、定评分」的硬核工艺。)