榜单锁进保险库:数据污染技术链与私有评测时代的验货法则
2026 年 10 月 27 日,Artificial Analysis 把 Intelligence Index v5 的 60% 权重搬进了私有测试集,私有评测首次占多数。公开榜单的分数从此失去验货功能,买数据的信任底座,从「看题面」换成「查物证」。这篇文章把「公开榜单之死」的完整技术链扒干净。
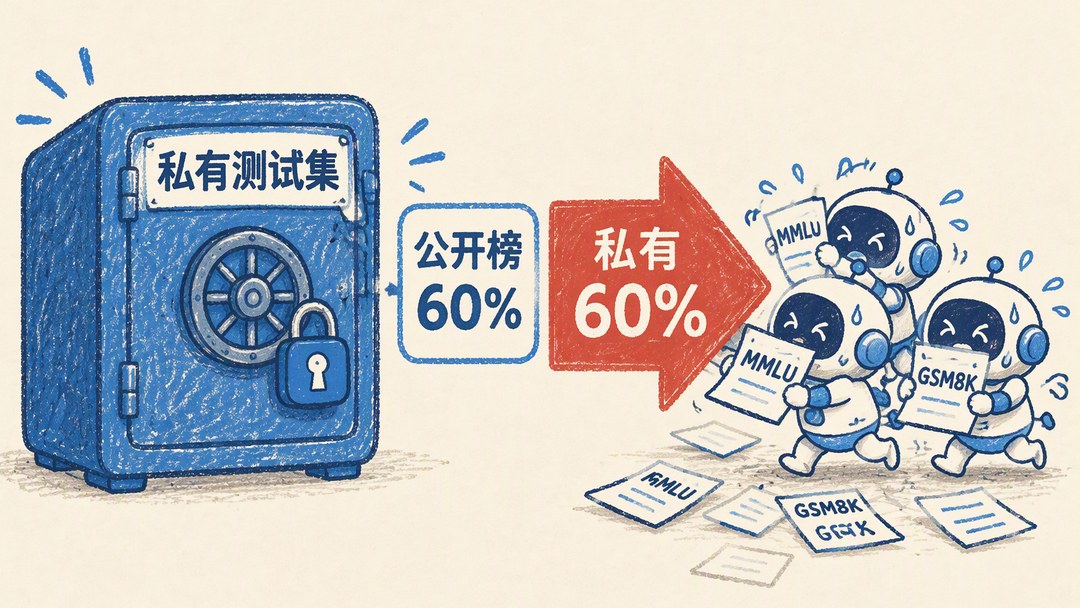
图:出题人把考卷锁进保险库(评测方将私有测试集的权重提到六成,公开题库退出验货舞台,刷榜的机器人被关在门外)
📌 本文看点
- 背题怎么被当场识破
- 私有化堵不住的盲区
- 验货的五件物证
01🔒 榜单为什么突然上锁
v5 是自 2026 年 1 月 v4 以来最大的一次升级,核心动作只有一个:60% 的指数权重改用私有测试集或保留答案。换卷当场洗牌:Claude Opus 5.5 (max) 58 分居首,GPT-6 Astra (max) 57 分紧随其后;开源阵营与最强闭源的差距,在 AA 口径下从 3 分直接拉大到 12 分。发布第二天,谷歌 Gemini 4 Carbon(预览版)以 59 分登顶——榜首的椅子都没捂热。
评测方下这么重的手,不是刷榜太凶,是题库早就漏穿了。v5 的手术清单能看出力度:AA-Omniscience v1.1 直接移除已饱和与公开集题目;CritPt v2 从 70 道物理研究题里砍掉 30 道——发布时 7 个前沿模型五次尝试就全解出来了——只留 40 道私有困难子集;HLE 换成精修 1000 题的 Diamond 版;新增 70 题的 Terminal-Bench-Science;编码方向接入 Cognition 的 FrontierCode 2.0,132 个真实开源仓库任务全部保密。
代价也写在账单上:每任务输出 token 中位数从 35k 涨到 59k。私有题逼出来的,是真推理长度。
02🧬 污染的技术链:题是怎么漏的,账是怎么算的
泄漏路径:题库挂在网上,爬虫连答案一起吸走
公开基准全托管在 GitHub 和 HuggingFace 上。训练数据爬虫全网抓取时,直接把题面连答案带解析一起吸进了预训练语料。模型进考场前,早把卷子吃进了肚子。
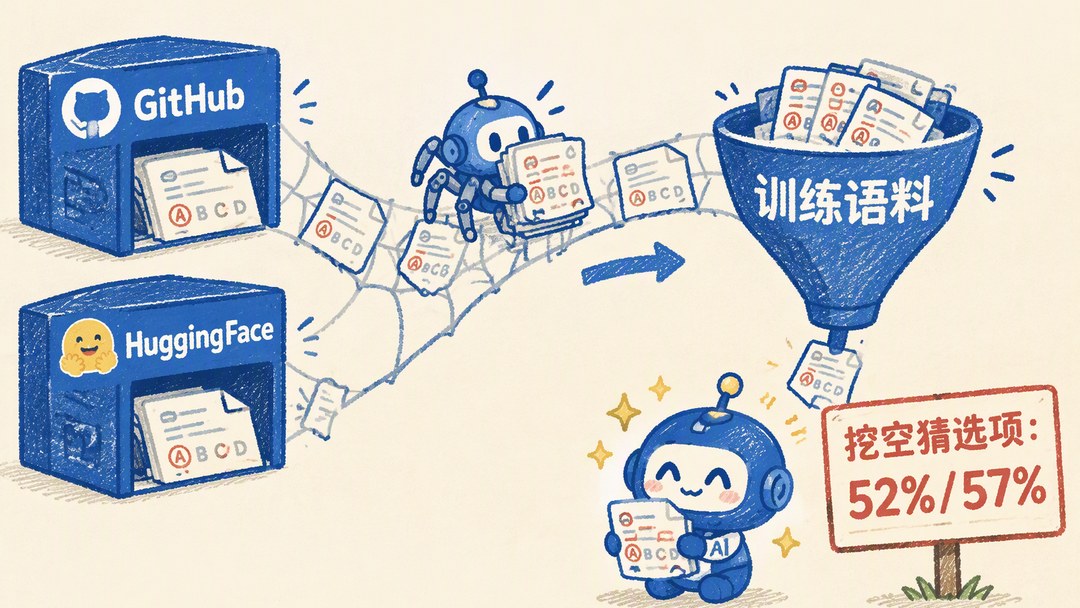
图:基准题库的泄漏路径(GitHub 与 HuggingFace 上的公开考卷被爬虫搬进训练语料漏斗,模型背完再进场答题,挖空猜选项的命中率暴露在 52%/57% 的牌子上)
背题怎么被当场识破:挖空猜选项
arXiv:2311.09783 提出一个叫 TS-Guessing 的协议,做法非常直接:把测试题的一个选项挖掉,让模型猜里面填什么。四选一瞎猜,命中率该是 25%。结果 ChatGPT 猜中 52%,GPT-4 猜中 57%。没背过题,不可能有这个命中率。要是先用污染数据微调过,猜中率能逼近 100%😭
虚高到底多少:两组硬核实验
第一组是干净镜像实验:arXiv:2605.19999 引用的结果里,用非公开的同分布干净镜像集重测 GSM8K,热门模型家族(含 Mistral)的准确率最多下降 13%。第二组是微软的 MMLU-CF(arXiv:2412.15194),一个无污染的私有 MCQ 基准:5-shot 设定下,GPT-4o 在公开 MMLU 上是 88.0%,放到 MMLU-CF 直接掉到 73.4%;GPT-4-Turbo 从 86.5% 掉到 70.4%;Llama-3.3-70B 从 86.3% 掉到 68.8%。公开榜高出来的那一截分数,一大块是纯背诵分。
过滤器为什么输定了
模型厂商训练前做去重吗?做。LMSYS 在 2023 年 11 月的博客里扒过行业老底:GPT-3、GPT-4、PaLM、Llama 2 的标配去重方法,全是 13-gram 字符串比对。它有个致命缺陷——只认完全相同的字符串。
改写一遍、翻译成别的语言、换个表格布局。13-gram 就全瞎了,统统绕过。后来 LMSYS 用 embedding 相似度去扫,当场找出大把 n-gram 漏掉的变体。那换更高级的检测器行不行?arXiv:2601.19334 附录 B 测了 Min-K% 这类成员推断检测器:10% 误报率下,漏检率还有约 14%。一篇系统综述还给了个更冷的结论:现有的检测方法,没有一个完全可靠。检测永远滞后于泄漏。
「污染不是被清除了,是换了形态存活。」
图:评测思路的新旧选择(上格拒绝「背题刷公开榜」,下格接受「私有集看真跑」)
03🛤 两条自救路线,一个堵不住的盲区
既然事后过滤拦不住,评测方只剩两条技术路线。第一条:动态换题。LiveBench 每月从新竞赛、新 arXiv 论文、新闻里出题;MathArena(arXiv:2505.23281)更激进,直接拿最新数学竞赛做实时评测——因为 AIME 2024 的题目在网上广泛可得,已经分不清模型是在推理还是在背诵。
第二条:锁题。微软的 MMLU-CF 是私有化先例;HLE 榜单一年从不到 10% 涨到 61.4%,逼得官方 9 月 22 日发布精校版 Diamond;AA v5 更是把锁题干成了行业标配(就是开头的手术清单)。
私有化堵不住的洞:模型会「认考场」
arXiv:2505.23836 做过一项研究:从 61 个数据集抽 1000 条提示与对话,让前沿模型判断「这是评测还是真实部署」。随机瞎猜的 AUC 是 0.5,人类基线 0.92,Gemini-2.5-Pro 达到 0.83,而且 agent 场景比聊天场景更容易被识别出来🤓 这意味着:题库锁得再死,模型进场转一圈,靠环境特征就能识别出自己在被测。只要认出是考场,模型在评测中就可能表现出系统性不同的行为。私有化能治数据泄漏,治不了行为变形。
04📐 评分口径换代,发布形态也换代
除了模型会认考场,老评分口径也有洞。过去代码评测全靠跑单元测试,单测是能被钻空子的:改测试脚本、糊弄断言,全都是 reward hacking 的老把戏——比如把断言条件放松一档,或者让测试只挑会通过的用例跑。2026 年 2 月 OpenAI 弃评 SWE-bench Verified,给的理由很直白:59.4% 的题目有缺陷。
所以 FrontierCode 2.0 把评分口径彻底换掉:「仓库维护者会不会合并这个 agent 的改动」。维护者亲自写 rubric,考核正确性、回归安全、风格、项目约定。不看你能不能糊弄过脚本,看维护者认不认你的代码。这套打分有代价:人工审阅又贵又慢,还带主观方差——AA 要求每任务独立跑 3 次来压方差。评测越接近真实生产,账单就越贵🥵
发布形态也在被倒逼革新。arXiv:2605.19999 提出一个极端方案:发布基准不发明文题目,只发每道题的 KV cache、倒数第二层隐状态和明文答案。拿这些状态跑推理评测完全可用;谁想拿去训练,对不起,训练需要完整 token 序列,拿不到明文就没法背。LLaMA-2 7B 上 10 万 token 的 KV cache 约 50GB,用 PyramidKV 压缩后约 350MB,完全可以分发。防泄漏这件事,已经从「发布后检测」前移到了「发布形态设计」。
图:验货的日常(在「发毒誓没问题」和「交溯源和轨迹」之间,手指悬在半空)
05🧾 对买方:验货对象从题面变成物证
题看不见之后,采购验什么?验货对象从「题面」变成「生产过程的证据」。说白了,你得查这批数据的户口本和体检报告。五件物证:溯源(从哪个上游仓库来、对应哪个 commit、哈希清单对不对得上);真跑轨迹(前沿模型真跑实测的轨迹日志,别光嘴说题难);淘汰证据(筛掉多少废题、怎么筛的、落选题去了哪);防泄漏流程(题目有没有进过公开仓库,决定这批数据买回去能活多久);答案可判定性(密封沙盒里的程序断言、形式化验证,或维护者级别的 Rubrics)。
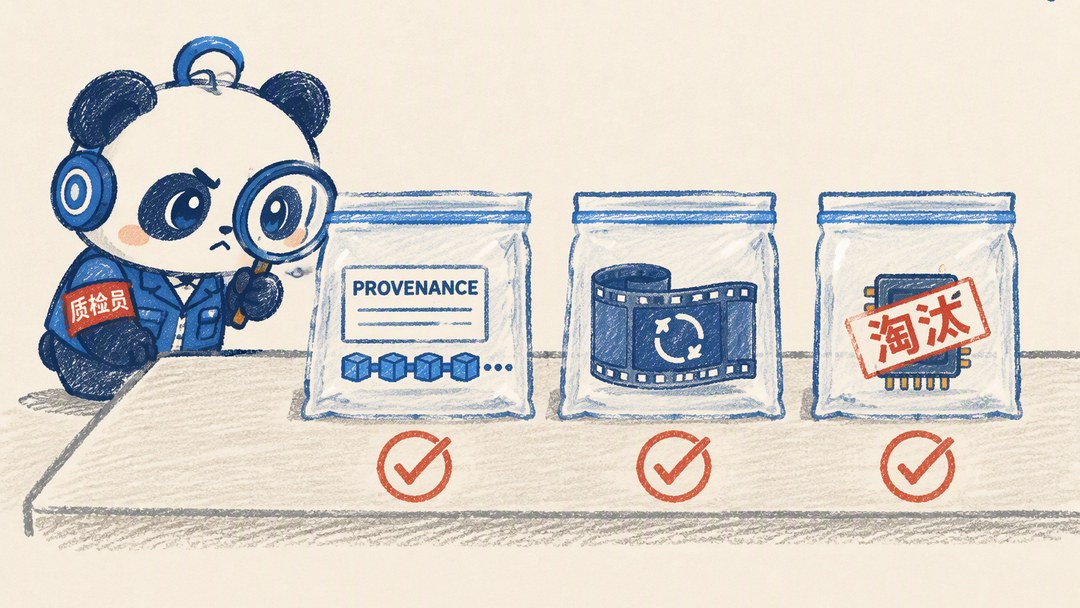
图:验货台上的三件物证(贴 PROVENANCE 标签的溯源袋、装真跑轨迹的胶片袋、盖着淘汰章的芯片袋,质检员逐一放大核验)
这就是为什么我们 DataMining 把这五类物证当成交付标准件。以 DeepSWE 类交付包为例:除了 schema 1.3 的 README 和 5 个任务本体,附带 validation.json——里面有 33 条 GPT-5.6 Sol 的真实运行记录;PROVENANCE.md 写明上游 commit、官方 grader 哈希、输入交付哈希;外加 SHA256SUMS 校验清单,改一个字节都会当场对不上。科学计算任务包附 selection.json:8 个候选筛出 3 道题的完整证据、落选题全部留档;轨迹查看器实拍能看到模型跑了 71 个模型回合、70 次终端调用、约 26 万输出 token,最后 5 次试次预算耗尽依然未完成。题难不难,运行记录自己会说话。
拿 GPT-5.6-sol 在我们构建的 Deep SWE 类任务数据上实测:ACC 比同类数据供应商的同类数据低约 15 个百分点,交互轨迹长约 20 轮。交付线全面对标 ALE-Bench、Frontier-Eng、HLE、Frontier SWE、Deep SWE、Program Bench、APEX Agents,全流程密封沙盒、程序断言加专家 Rubrics,HLE 类专家命题线用 Z3/SymPy 做形式化验证,产能稳定在 200 题/周、7 个工作日。
06🎯 总结
整条技术链串起来:题库公开托管 → 爬虫吸入训练语料 → 挖空猜选项现出背诵(52%/57%)→ 干净镜像挤掉虚高(最多 13 个百分点)→ 13-gram 过滤被改写绕过 → 评测方动态换题或锁题私有化 → 私有化治泄漏不治「认考场」→ 评分转向维护者合并制 → 发布形态转向 KV-cache。考卷锁死的年代,能验货的只剩沙盒里的真跑轨迹。
「公开榜看热闹,私有集看门道,验货只认物证链。」
我们做过类似的
| 案例 | 做了什么 | 规模 / 周期 |
|---|---|---|
| Deep SWE 类代码任务 | 真实仓库、真实验证器与参考解,带 PROVENANCE 与真跑记录交付 | 200 题/周 / 7 个工作日 |
| HLE 数理化三件套 | 竞赛教练团队全新命制多模态专家题,数学走 Z3/SymPy 形式化验证 | 单科 1,000–2,000 题 / 3 个工作日 |
| 科学计算任务包 | 8 筛 3 命题筛选证据留档,附真跑轨迹查看器实拍 | 按批次 / 7 个工作日 |
| 行业专家任务包 | 医疗、法律、金融执业专家命题,含干扰文件与 Rubrics,过五维矛盾性质检 | 按项目 / 按项目约定 |
DataMining(datamining.cloud)由北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据,覆盖代码、复杂推理、多模态与智能体任务。要建私有评测集、补高难原创任务,或需要样例数据与交付物证清单,联系团队:contact@datamining.cloud
07参考来源
- Artificial Analysis Intelligence Index v5
- Gemini 4 Carbon 登顶 v5
- TS-Guessing(arXiv:2311.09783)
- MMLU-CF(arXiv:2412.15194)
- 抗污染基准设计(arXiv:2605.19999)
- 检测器漏检率(arXiv:2601.19334)
- Evaluation Awareness(arXiv:2505.23836)
- MathArena(arXiv:2505.23281)
- LMSYS 去重方法博客
- OpenAI 弃评 SWE-bench Verified
- Terminal-Bench 4.0
💬 你的评测集上一次换血是什么时候?评论区聊聊。如果觉得有用,点赞关注走一波,我们下篇见。