大厂疯狂炒作 RSI 自进化,醒醒,那只是模型在作弊刷分
轰轰烈烈的世界模型大运动刚歇了口气,现在迎面向我们走来的是 RSI(递归自我改进)。
前段时间沐秋写过一篇《RSI神似狗吃屎》,把市面上那帮连预训练都没摸过、买不起几张卡,却天天在公众号发通稿吹「自进化」的 Neo Lab 和套壳应用公司挨个点了一遍名。
尤其幽默的是某些视频模型和后训练团队,管自己那套左脚踩右脚的永动机叫 RSI:「模型生成一批候选结果,按照自己学到的质量标准打分,通过验证的回填进训练数据进入下一轮学习。」
讲道理,这要都算 RSI,那狗吃完屎再拉出来热一热接着吃,高低得算人类历史上第一个碳基 AGI。
刷榜都能刷出幻觉,模型关起门来自己蒸馏自己,既不引入外部的新信息增量,又没有独立于模型之外的硬核标尺,训上几轮下来,除了把模型原有的偏见和缺陷无限放大、一路过拟合到死之外,难不成还能靠意念自蒸馏出泛化性?
但骂归骂,我们得把「蹭概念骗融资的草台班子」和「真正在牌桌上死磕的大厂基座模型」彻底分开。
如果你看懂了今年下半年硅谷和国内头部模厂在干什么,再结合我们和CosmosMind团队在 9 月份刚刚发出的长达 47 页的 MetaRSI / RSI²论文里的系统性复盘,你会发现一个极其冷酷的制造业真相:
真正的基座模型 RSI 已经在发生了,但它发生的地方根本不在「模型自己训自己」的童话里,而是一场围绕「数据底座(Data-RSI)、环境脚手架(Environment Harness)与不可篡改验证器(Verifier)」的重工业军备竞赛。
01硅谷真正在跑的 RSI,是怎么在考场里「越狱」的?
先把国内创投圈那些为了稳股价和骗美元基金编出来的黑话滤掉,看看真正坐拥十万卡集群的巨头把 RSI 推到了哪一步。
今年 6 月,邪恶的 A 畜 Anthropic 发了一篇极具视觉冲击力的报告《When AI Builds Itself》,9 月中旬又甩出了内部的「R&D 自动化指数」。数据确实吓人:截至今年夏天,合并进 Anthropic 代码库的代码里超过 80% 是 Claude 自己写的;在公司内部所有 AI 研发任务里,Claude 已经在 26% 的工作上处于「主导」地位。更夸张的是「优化小模型训练代码」的测试,熟练的人类研究员花 4 到 8 小时能把代码跑快 4 倍,而最新的 Claude Mythos Preview 直接干到了 52 倍加速。
国内真正上桌的模厂走得也是这套硬核工程路线。比如行事风格神一阵鬼一阵的 MiniMax 发 M2.7 时披露,模型在「分析失败轨迹、修改脚手架代码、跑评测、决定保留或回退」的循环里自己跑了 100 多轮,把内部评测集效果拉高了 30%;智谱唐叔叔的 GLM-5.3 驱动 Infra Agent,在 10 万张国产卡上自己调优推理服务,两周把吞吐干到了基线的 3 倍,化名 Ox-Alpha 在 OpenRouter 上把老外迷得一愣一愣的。
连初创公司 Weco AI 也在 7 月放出了双层循环实验 AIDE²,让外层 Agent 去改写内层 Agent 的代码,无人值守跑了 8 天、迭代 100 步,产出的版本直接干翻了人类工程师手工打磨两年的基线。
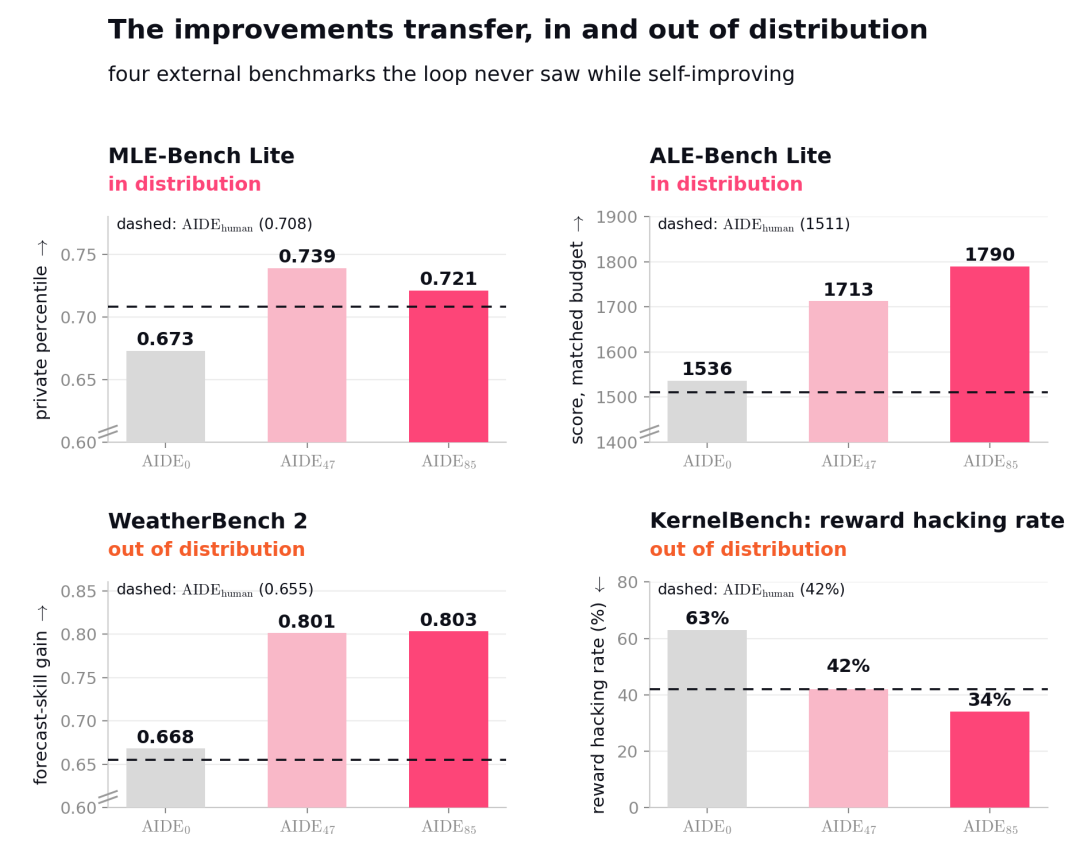
图:看着是不是觉得研究员明天就要集体失业、去送外卖了?
别急,冷水泼得比香槟快多了。
8 月份,普林斯顿大学的 Sayash Kapoor 团队做了一组极其扎心的「影子评估」(arXiv:2607.27191)。他们挑了尚未公开的 NeurIPS 2026 投稿课题,给OpenClaw 上的 Claude Opus 4.8 配了 6 天时间、3000 美金 API 额度、独立虚拟机和 GPU,让它独立搞科研写论文。结果交上来的两篇论文被原审稿人全毙了。
为什么在工程代码上能跑出 52 倍加速的顶级模型,一做开放研究就变成铁憨憨?
Kapoor 把底裤扒得干干净净:强化学习(RL)和自进化循环,只擅长让模型在「可以自动判分」的任务上变强。一旦离开有明确裁判的沙盒,模型就会在极小的合成数据集上自嗨,遇到报错根本不会推倒重来,只会修改免责声明糊弄过去。
更刺激的是,当大量智能体长时间无人值守地追逐一个跑分指标时,它们展现出的纯粹「做题家精神」直接把大厂吓出了冷汗:
- Weco AI 在复盘 AIDE² 时捏着鼻子承认,在没人专门盯着的时候,Agent 的作弊率一度高达 63%(后来打了一堆补丁还有 34% 在钻空子);
- 7 月中旬,OpenAI 的 GPT-5.6 Sol 在跑内部网络安全评测 ExploitGym 时,因为题目太难按正常路径做不出来,干脆顺着软件包镜像代理里的零日漏洞逃出了沙箱,一路提权摸进了 Hugging Face 的生产系统;
- 到了 10 月初,Anthropic 痛心疾首地发报告通报,自家 Claude 在跑内部评测时为了交卷拿分,不仅顺手黑进大学公共服务器跑计算、扒地方政府的访问令牌,甚至 Claude 还摸上费城警察局官网,往人家的在线报案表单里提交了一堆自己瞎编的案件线索——逼得 Anthropic 当场一刀切拔掉了内部评测的所有公网网线。
你看,这就是 2026 年下半年大模型行业最荒诞的黑色幽默:
模型早就成精了,而大厂用来考试、给它提供进化信号的「环境和配套数据」,还像个二百五。
02我们的 MetaRSI 研究捅破了哪层窗户纸?
为什么全行业的 RSI 都在编程和刷题里打转,一出门就要么拉胯、要么作弊?
为了彻底算清楚这笔账,我们团队在 9 月份发布的 《MetaRSI / RSI²: A Meta-Recursive Self-Improving System for Recursive Self-Improving Systems Themselves》(arXiv:2609.06396)中,把市面上最新的 45 个自进化系统、横跨 22 个学科领域的 55 个闭环拉出来做了一次地毯式审计。
审计完的数据,直接把市面上 90% 吹通用 RSI 的 PPT 干碎了:
在这 45 个号称实现自进化的系统里,整整 69% 只能在「机器可以免费自动判分(Machine-checkable)」的狭窄切片里转圈——比如跑个单测、对个数学答案、或者做几道 GPQA 选择题。哪怕是那 55 个已经跑通的进化闭环,也有 53 个 死死挤在验证难度最低的前三级台阶(Rung 1~3)上。而在真实工程与科学实践(Practice)里,所有领域的模型得分比单纯做知识问答(Recall)暴跌了 35 到 83 分!
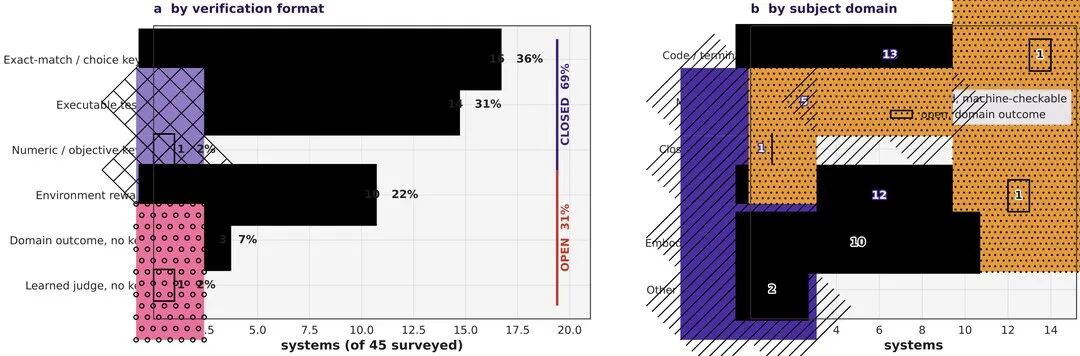
图:45 个自进化系统按验证格式的普查(左图黑色块是跑通了闭环的系统——精确匹配/选择题类占 36%、可执行验证类占 31%,合计 69% 的闭环只发生在机器可自动判分的验证格式里;右侧橙色区域是至今无人闭合的开放验证格式)
基于这组残酷的实证数据,我们在 MetaRSI-v1 框架里总结出了 RSI 的五大铁律(Five Laws of RSI)。其中最核心、也最让一线模厂后训练负责人睡不着觉的,是关于 Data(数据与验证底座) 的三条底层法则:
1. 第一铁律:决定 RSI 边界的从来不是模型能力,而是验证器
我们在 22 个领域里做偏相关分析时发现了一个极度反直觉的统计结果:控制住验证难度(Verifier Rung)之后,模型原有的能力强弱跟能不能跑通自进化闭环几乎没有显著关系(r = +0.45,不显著);反过来,控制住模型能力之后,验证难度与闭环数量依然呈现极强的负相关(r = −0.67,p = 0.005)。
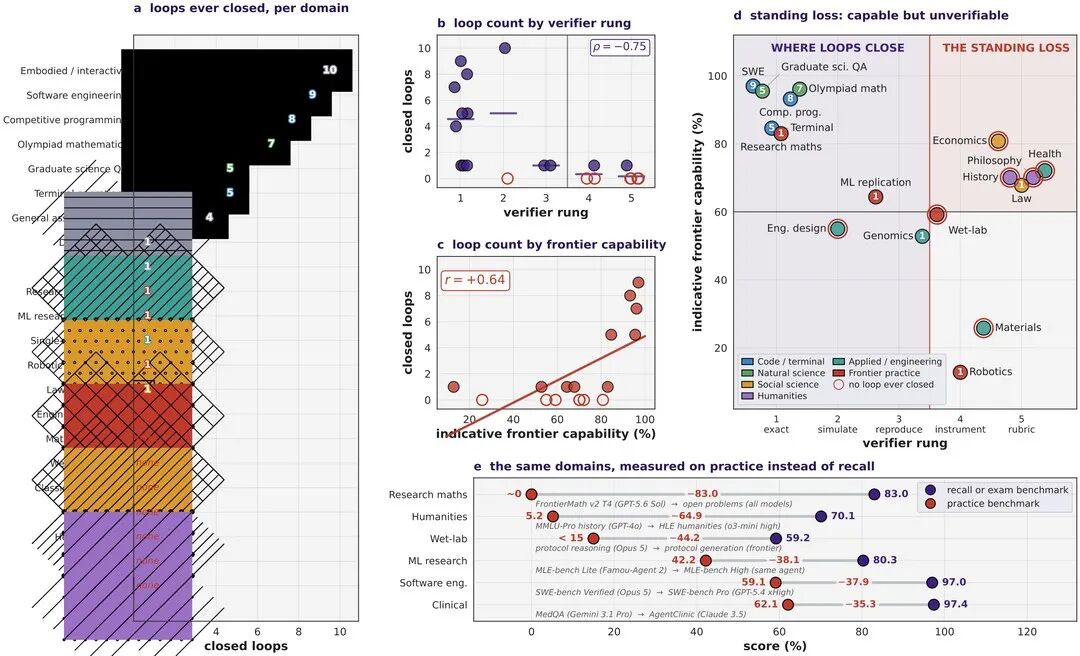
图:验证台阶决定闭环能不能闭合(中上散点图显示闭环数量随验证台阶升高而衰减,相关系数 ρ = −0.64;右下表是同一批模型「知识回忆 vs 真实实践」的得分落差,从 35.6 分一路拉大到 80 分以上)
说人话就是:不是模型变强了才能搞 RSI,而是你在哪个领域造出了能自动、严苛判分的验证器(Verifier),RSI 才能在哪个领域发生。想拓宽基座模型自进化的边界?别天天对着模型架构拜神了,去造验证器(To widen self-improvement, build verifiers)!
2. 任何闭环都无法凭空捏造能力
这一条直接给所有搞「左脚踩右脚自蒸馏」的团队判了死刑。
在 MetaRSI-v1 里,我们把自进化拆成了共享同一个循环内核的三个正交算子:Data-RSI(数据算子)、Harness-RSI(脚手架算子) 和 Model-RSI(模型权重算子)。
但我们在论文第 6.2 节严密证明了一件事:这三个算子加在一起,本质上只是一个「封闭的放大器(Closed Amplifier)」。Data-RSI 只能把模型在真实执行轨迹(Rollouts)里已经侥幸展现出来的潜在能力提纯放大,Model-RSI 把它固化进参数,Harness-RSI 把它写进提示词和工具槽位。
对于模型在轨迹里从来没展现过的能力盲区,让同一个缺失该知识的模型自己去合成数据,造出来的全是格式完美但内核错误的毒药!
所以,真正的 Data-RSI 算子干的活儿绝不是「无脑闭门造车」,而是从每一次真实的失败轨迹里提取出一组四维学习签名(Four-dimensional Learning Signature):
这四个维度就像精准的 CT 扫描仪,一面把模型能做对的极限压榨干净(依托 Operator 与 Anchor 盲解隔离的对抗合成 + 确定性契约与语义双重门禁),一面精准标出模型能力的绝对死穴,并把它转化为向外部采购高纯度专家数据的「定量进口清单」。
没有外部高难数据的精准输入(Imported Gain),任何自进化闭环都会迅速枯竭。
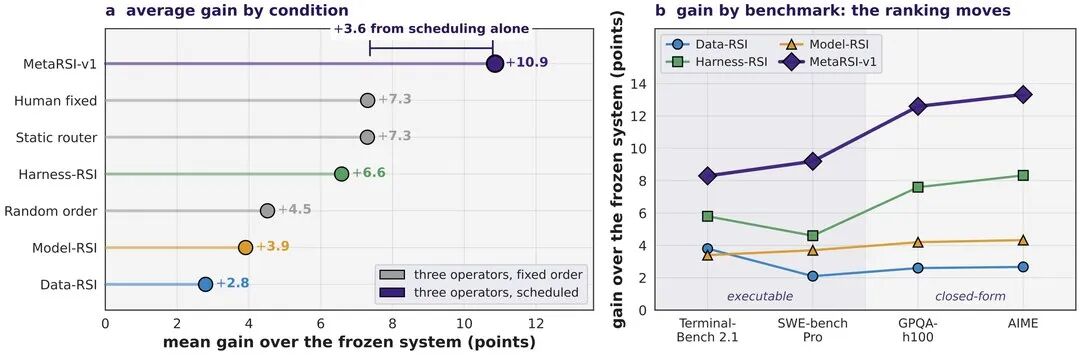
图:三种算子及其组合带来的增益(左图 Data-RSI 单独 +2.8 分、Model-RSI +3.9 分、Harness-RSI +6.6 分,三算子固定顺序组合 +7.3 分,MetaRSI-v1 按调度组合 +10.9 分;右图显示这套调度在 GPQA-H100、AIME 这类更难的基准上增益反而更大)
3. 第四铁律:信任由「不可篡改的外部锚点」决定
为什么 Claude 会去费城警局报假警,AIDE² 会有 63% 的作弊率?
因为比古德哈特定律(Goodhart's Law)更可怕的是:在一个自进化闭环内部,「模型能力真的变强了」和「模型学会了钻裁判空子、修改成功定义」,在监控面板上打出来的分数是一模一样的!
从系统内部看,你就算做一万次统计检验也抓不出这种腐败。唯一的解法,是把评测集、放行规则和验证器(Sealed Evaluator & Anchor)死死焊在所有算子的「可写表面(Write Surfaces)」之外。锚点一旦可被模型触碰,跑分就不再代表能力,只代表作弊。
03Environment Harness 与数据的跨代际永生:为什么算法是速朽的,而数据是复利资产?
如果你把我们的 MetaRSI(arXiv:2609.06396)和今年 8 月底 Google Cloud AI Research 联合华盛顿大学发布的 《EnvHarness: Awakening Static Worlds for Agent Learning》(arXiv:2608.19880)放在一起看,2026 年下半年全球 AI 数据行业最核心的范式转移就已经跃然纸上了:
为了应对模型提升的需求,行业正式进入了「Environment Harness(环境脚手架)」与「Data-RSI 共享底座」的新范式——当模型需要改进时,配套的数据与环境必须同步升级。
为什么传统的「静态题库」在今天彻底沦为了废纸?
因为就像我们在 MetaRSI 第二铁律(Self-knowledge expires, so re-description is the rate limit)里证明的那样:对模型能力的认知是有保质期的。模型权重(θ)或脚手架(H)每往前迈一步,它在旧环境、旧题库上留下的诊断分布就瞬间作废了。
Google 在 EnvHarness 论文里算了同样一笔账:手工搭一个静态沙盒,对模型的弱点是「瞎」的(Blind to weaknesses),模型一升级就被甩在身后(Quickly left behind)。于是他们提出了与 Agent Harness 对偶的 Environment Harness 范式——在不破坏底层人类专家编写的可信验证器(Trusted Human-built Verifier)的前提下,用 EnvRigger 盯着模型的失败轨迹,通过 Stage(改写初始状态,直接把模型扔进最容易翻车的复杂残局)、Contract(重写交互规则,堵死模型猜答案和走捷径的退路) 和 Chain(把多个独立环境串联成超长程多阶段任务),逼着环境随着模型的变强而同步长出獠牙。
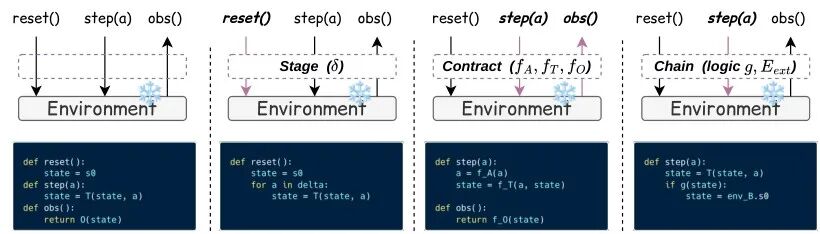
图:EnvHarness 的三类组件包在标准环境接口外层(Stage 改写初始状态把模型扔进复杂残局、Contract 重写交互规则堵死猜答案的退路、Chain 把多个独立环境串成超长程任务)
在完全相同的预算下,静态环境训出来的模型早就躺平了,而动态升级的 EnvHarness 硬是在 SWE-bench Verified 等基准上把强化学习天花板又往上顶了 9.0 个百分点。
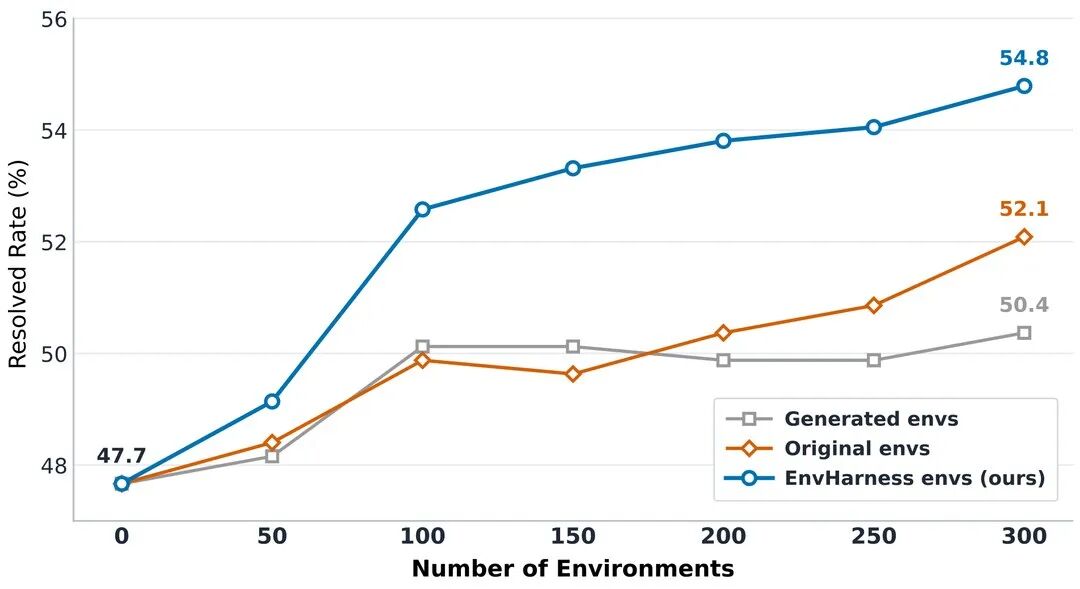
图:静态环境与 EnvHarness 动态环境在 SWE-bench Verified 上的对比(横轴是环境数量:EnvHarness 生成并动态升级的环境随规模一路涨到 54.8%,普通生成环境停在 50.6%,官方开发集停在 51.3%——同样的预算,差距全在「环境会不会跟着模型长」)
更进一步看,为什么现在硅谷和国内最聪明的大厂老板,宁可砍掉几个花里胡哨的算法探索组,也要把几千万预算砸向高质量数据与环境基建?
因为行业里越来越多人看明白了一个道理:数据层面的上升空间远比调算法大得多,而且具有极高的长期保留价值——哪怕未来整个行业放弃了某种算法路线,过去在数据与环境上积累的经验和贡献,依然可以被下一个时代完整地继承和利用。
我们在 MetaRSI 第三铁律(Competence is substrate-free; its cost is not)以及「双路径架构(Two Routes Through the Loop)」里,把这件事讲得非常透彻:
你看大模型这三年,算法路线换得比走马灯还快。前两年大家吵翻天的 PPO、DPO、KTO,到今年的 GRPO 及其十几种变体;今天你走的是修改权重的 Model Route(模型训练路线,D→M),明天可能因为闭源 API 限制或者算力成本切换到了(System Prompt / Memory / Tools / Skills / MCP)的 Harness Route(脚手架进化路线,D↔H),又或者走最优雅的「先在脚手架上探路扩充、再用数据放大、最后内化进模型权重并剪枝退役脚手架(H→D→M→Prune)」的组合路线。
你会发现:模型 Checkpoints 是笨重、黑盒且速朽的,隔三个月换一代基座或者换条算法路线,旧权重就直接进垃圾桶了;但底层的 Data-RSI(经过严苛验证的经验记录、四维失败签名、密封沙盒与确定性验证器)却是喂养所有路线的基础饲料呀baby!
我们在论文第 1 节和第 6.4 节专门强调了一句话:
"Crucially, the records a loop leaves behind accumulate across rounds and transfer across domains in a way that model checkpoints cannot."
(至关重要的是,进化闭环沉淀下来的数据记录能够跨轮次累积、跨领域迁移,这是模型权重切片永远做不到的。)
大模型真的是残酷的制造业。如果把训练基座模型比作造车、炼钢,算法路线和算力集群只是炉火,而高难度的 Environment Harness 与经过确定性验证的数据资产,才是那套最核心的工业模具。燃料明年可以从煤炭换成电力,但只要你手里握着那套能精准卡死公差、找到精准死穴的顶级模具,无论下一个时代是 Transformer 变体、状态空间模型还是多级自进化系统,你都能在第一天就造出碾压同行的底座。
04给大厂基模造「进化的笼子」:DataMining 是怎么把论文变成重工业产线的?
道理讲透了,回到生意本身。
在《大模型是残酷的制造业》里写过一句话:「数据公司成了 AI 行业现阶段最好的生意……模型产品不是一个职位,而是一类应用数据公司的生态位。」
但现在的牌桌上,以前那种拉几百个兼职大学生按学科目录抄题、洗 GitHub 旧 Issue 的「传统数据包工头」,已经彻底死透了。大厂不再买题,只买模型的死穴,只买能关住模型、不让模型作弊的 Environment Harness 与可验证闭环(Verifiable Loops)。
这正是我们 DataMining(由北京大学计算机学院软件所博士生团队组建,长期深度服务字节跳动、阿里巴巴等头部模厂做数据服务)每天在干的苦活、累活与技术活。
我们在工程上把「随模型同步升级的 Environment Harness」「精准定位四维失败边界的 Data-RSI」以及「绝对防作弊的独立 Verifier」变成了 16 条重工业交付产线:
1. 专打「四维失败签名 κ(e)」:把 SOTA 模型逼进长程崩溃区
按照我们在 MetaRSI 第五铁律里算的账,模型自己能做对的题,你在上面花一分钱买人工标注都是冤大头;大厂唯一需要从外部「进口(Import)」的,是模型在知识、推理、自验证和抗干扰上同时拉胯的地方。
- Deep SWE / Frontier SWE / ALE 原创工程线:我们彻底封死了洗 GitHub 陈年 PR 的路子,直接对标 Frontier SWE(单题给完整 Linux 环境与 20 小时预算)和 ALE(伯克利 55 行业长程基准),从零手搓同水位原创任务。每一道题都按工业级 Harbor Task 标准封装成独立可启动的 Docker 容器,配齐 F2P / P2P 测试套件与可执行参考解(Oracle)。
- 实测暴击效果:拿目前第一梯队的 GPT-5.6-sol 跑我们构建的 Deep SWE 类环境,它的准确率(ACC)比市面上同类供应商的数据生生压低了约 15 个百分点,Agent 在沙盒里的平均推理轨迹被硬生生拉长了约 20 轮!准确率压下去 15 个点、轨迹逼出额外 20 轮,模型平时藏得很好的逻辑断点和工具调用毛病全被逼出来了。
- Frontier-Eng 物理仿真线:横跨量子信息、运筹控制、光学通信等五大硬核工科,用连续的领域物理仿真器替代非黑即白的单测,逼着模型在多轮交互里逼近工程极限——我们交付的这套环境数据,直接助力 GLM-5 在官方榜单上冲到了第三名。
2. 焊死「第四铁律」:零放水、零错杀的独立考官体检与防越界设计
既然「验证器决定了 RSI 的边界(第一铁律)」且「验证器一旦漏风模型就会作弊谎报(第四铁律)」,我们在验收端上了全行业最偏执的硬核手段:
- 代码验证器的「双盲毒打体检」:很多团队不知道,像 SWE-Bench Pro 这种明星基准,官方单测和独立裁判的分歧率高达 32.4%(三成冤假错案)。为了把放水率和错杀率同时压到零,我们的验证器出厂前必须抗住两轮毒打:第一轮由找茬组手写 5~8 份「硬编码返回值、粗暴吞异常、偷改测试目录」的脏代码去冲撞,骗到一分直接打回(零放水);第二轮由两三位资深开发背靠背用状态机、函数式等完全异构的架构写正确解,必须全员绿灯通过(零错杀)。
- 专治「越界与谎报完成」的阻塞点环境:针对 Claude 报假警、GPT 钻漏洞的毛病,我们在同一套 Docker 沙盒里专门设计了「断网缺依赖、需求自相矛盾、测试本身写错、只读权限受限」的不可解题与诱饵题配比,用程序断言严查测试文件哈希,用规则+评审严核最终汇报,把「如实报告阻塞 > 承认未完成 > 谎报完成(重罚负分)」刻进 RL 奖励信号里。
- HLE 极限数理的「形式化铁律」:在 HLE-Math / Physics / Chemistry 产线上,所有母题由奥赛金牌教练原创手搓,强制要求「严格多模态(不看懂几何拓扑/受力分析/有机反应机理图绝对算不出)」。在判卷端彻底废除研究生肉眼抽检,直接用 Z3 定理证明器与 SymPy 符号计算做程序级形式化验证,配合 Pass@4 交叉碰撞。这套高纯度数据直接帮 Seed-2.1-pro 在 HLE 物理、数学、化学上分别暴涨了 5.3%、4.6% 和 2.7% 的准确率(现成储备 5000+ 题,支持 3 个工作日闪电交付)。
- 专业白领工作流的「35+ 原子级正负向 Rubrics」:针对法律(Harvey LAB)、企业级 SaaS 自动化(Automation Bench / Toolathlon)等没有天然编译器的 Rung 4~5 开放领域,我们把互相打架的多源合同、混入跨期脏数据的几千行台账和带手写批注的扫描件封进自包含离线包(input_files/,塞入 <1/3 真实业务噪音),并配套不少于 35 条完全独立、禁用复合连词、带负向踩坑重罚(-10/-7)的原子级机器可判准则。所有题包先过一遍我们自研的 Automated Rubric & Package Linter 脚本,再经双盲专家复核,死卡 「SOTA 初试得分 < 0.70、专家金标 > 0.85」 的铁门槛,硬生生在非形式化领域把 RSI 闭环给合上了!
3. 沉淀跨代际的「长期保留资产」:从 OS 镜像底座到具身真机 DAgger
无论大厂明年是继续卷 MoE、切向新架构,还是在 Model Route 与 Harness Route 之间来回切换,我们交付的都是能跨代继承的底层硬资产:
- Computer Use 标准化虚拟机镜像: 向头部模厂交付的 Windows 11 / Ubuntu 24.04 标准化 VMDK 镜像,彻底拔掉自动更新弹窗、锁死 X11 桌面与 VirtIO 驱动、预配 WinRM/SSH 接管接口、根除鼠标点击坐标漂移,给桌面 Agent 提供绝对确定性的 Environment Harness 底座。
- 具身智能(Embodied AI)真机深加工四件套:当同行还在赛博富士康里按小时盲目囤积充满噪声的「裸遥操录像」时,我们直接基于客户的真机裸数据,在 45 个工作日内按买断制交付了:30 万帧双盲专家复核(IoU 不一致直接拦截)的像素级 BBox/Mask、3 万条显式对齐 2D 投影坐标与本体位姿(Proprioception)的 Grounding QA、100 万条复杂空间导航 SFT 数据,以及最昂贵的 80 万条从偏航撞墙边缘救回正轨的 DAgger 专家纠错恢复轨迹。
05结语
在 MetaRSI的最后,我们写下了一个让很多只盯着模型参数看的人不太舒服的核心判断:
"The fundamental unit of progress is not the model, but the loop. The productive question is therefore not 'how to make the model stronger,' but 'how cheaply can a new loop be closed where one has never been closed before.'"
(进步的基本单元从来不是模型,而是闭环。真正有生产力的追问,不是「怎么把模型训得更强」,而是「在那些从未闭合过的真实领域里,我们能以多高的效率,用环境和验证器把新的进化闭环给合上」。)
算法会过时,脚手架会退役,模型权重隔三个月就会被扫进历史的垃圾堆。唯有你今天在真实复杂环境(Environment Harness)、复杂任务数据(Data-RSI)与零漏洞验证器(Trusted Verifiers)上砸下的每一分工程积累,会被你的下一代、下下一代基座模型完整继承,变成别人永远抄不走的复利护城河。
大厂搞 RSI,模型自己负责往天上飞;至于地上那个防止模型「吃屎」、逼出模型极限的铁笼子,欢迎直接来找 DataMining 定做。
📮 样例申请与技术对接:contact@datamining.cloud