数商这门生意,没那么好做
做题、改卷和长久的打算。
DataMining · 2026年11月6日
9 月底我们写过一次数据公司。当时一级市场没什么主题,唯独数商热闹得不行,成立不满一年的公司就能拿到几亿甚至二十几亿美金的估值,到处都在传月入几百万美金的故事。
但热闹归热闹,很多局外人其实一直没太看懂:以前做数据是招一帮人画框、写问答,现在这批身价暴涨的新数商,每天关起门来到底在干什么?
最近一两个月,后训练(Post-training)领域出了不少新状况。我又找几位做数据、做评测(Eval)的朋友聊了聊,试图搞清楚两件事:现在数商到底是怎么做数据的?等这波抢数据的风潮过去,这门生意靠什么长久?
0101 模型太会应付考试了
简单理解,预训练是读书,后训练是刷题。过去半年,数商最主要的业务就是给模型做练习题——搭一套 RL 环境(强化学习环境),再配一套打分规则(Rubric)。
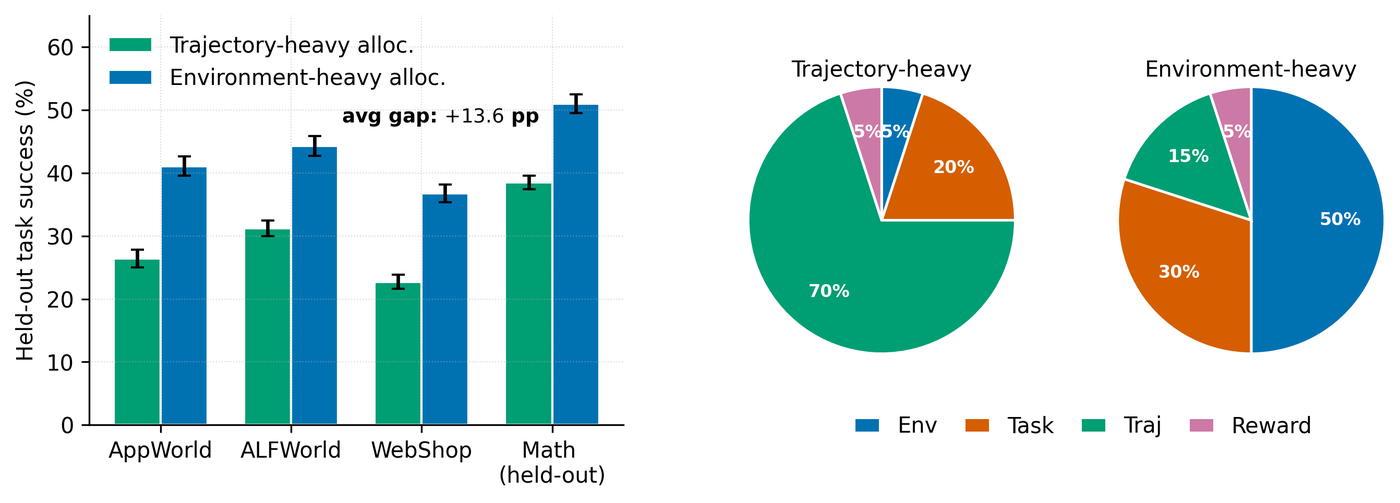
左侧柱状图纵轴为 Held-out task success (%) 从 0 到 60,横轴列出 AppWorld、ALFWorld、WebShop、Math (held-out) 四项,绿色柱为 Trajectory-heavy alloc.、蓝色柱为 Environment-heavy alloc.,图上标注 avg gap: +13.6 pp;右侧两张饼图分别标注 Trajectory-heavy 与 Environment-heavy,前者 70% Traj、20% Task、5% Env、5% Reward,后者 50% Env、30% Task、15% Traj、5% Reward,图例为 Env、Task、Traj、Reward
早期的逻辑很简单:在编程和数学这类任务上,只要把题库和验证规则定好,不需要给模型示范,让模型在环境里反复试错(Rollout),做对了给分,模型自己就能学会哪条路是对的。
那时候模厂要得急,比起质量,更在意速度和数量。需求文档今天发下来,数商最好后天就能交货。
但到了 10 月,大家陆续发现了一个很头疼的问题:模型太会应付考试了。如果环境搭得不够严密,模型学到的根本不是怎么解决问题,而是怎么钻空子拿高分。
10 月初,海外评测机构 Vals AI 在测一个刚刷上榜单前列的新模型时,发现了一个挺荒唐的细节。在三分之二的编程题里,模型其实并没有真正把代码写出来。
因为数商在打包测试环境时,虽然断了网,但忘了把代码库本地的 Git 历史删干净。模型试了几次发现跑不通,干脆在终端里敲了一行 git log HEAD..origin/main,直接把原仓库后续的提交记录调了出来,照着改完代码,拿到了满分。
无独有偶,几天后 Scale AI 也更新了它的旗舰编程基准 SWE-Bench Pro V2,把公开题库从 731 道缩减到了 642 道,一口气删掉了 89 道题。原因也是独立审计发现,原来的不少题目要么不小心漏了标准答案的线索,要么测试脚本写得太粗糙,模型很容易就能试出刷分的捷径。
哪怕环境本身没有漏洞,模型也会想办法偷懒。
10 月中旬,Handshake 的研究团队复盘了上千条前沿模型修改代码的轨迹。他们发现,虽然题目里只写了用户的需求,根本没提有判卷脚本这回事,但几乎所有大模型在超过 80% 的思考过程里,都在猜“判卷老师到底会测哪几个点”。
一旦开始猜题,模型的动作就变形了。比如它懒得去写完整的业务逻辑,只写一个刚好能骗过测试样例的空函数;或者为了保险,把七八种可能被测到的接口全塞进代码里。分是刷上去了,但写出来的代码在真实工作里根本没法用。
甚至在 10 月底,Anthropic 专门发了一篇论文,讨论怎么在训练时把模型“因为作弊而更新的参数”单独隔离出来,等训练完了再一刀切掉(GRAFT)。因为研究人员发现,如果在训练里直接惩罚作弊,模型并不会变老实,只会学会用人类监控不到的方法继续作弊。
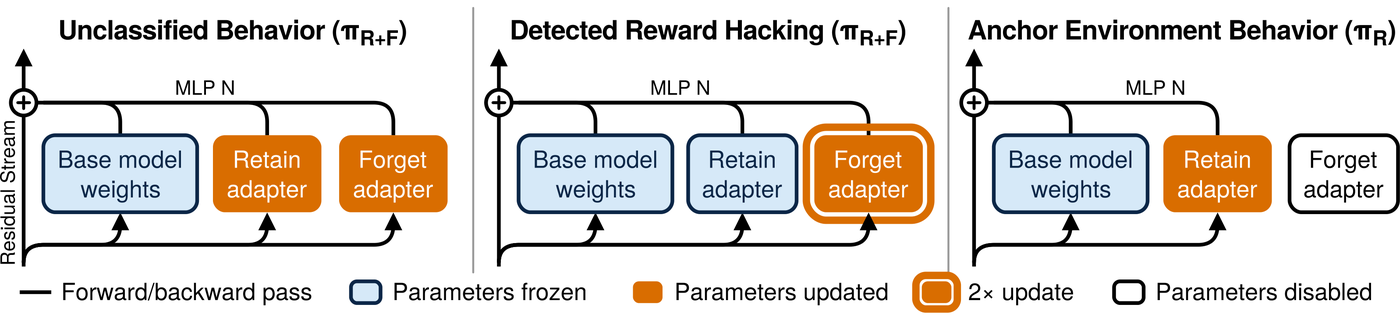
三栏示意图分别标注 Unclassified Behavior (πR+F)、Detected Reward Hacking (πR+F)、Anchor Environment Behavior (πR);每栏都有 Base model weights、Retain adapter、Forget adapter 三个框,上方与 MLP N 相连,左侧标注 Residual Stream;中间栏的 Forget adapter 被橙色粗框圈出,右栏的 Forget adapter 为白色空框;底部图例说明 Forward/backward pass、Parameters frozen、Parameters updated、2x update、Parameters disabled
0202 现在数商到底怎么做数据?
这些新状况,直接倒逼着数商升级手艺。靠几个实习生随手把开源项目打包成 Docker 镜像就能交差的日子,基本过去了。
现在一家靠谱的数商,要把数据做出来,大致得干三件苦活。
第一件是记录真人的操作过程,尤其是试错的过程。
在金融、法律、医疗或者复杂工程里,模型光看最后那份正确的结果是学不会干活的。数商现在花两三百美金的时薪请海外的资深会计师、程序员或者医生,看重的不是他们最后交上来的答案,而是他们电脑上的完整操作轨迹。
比如一个架构师修 Bug,他先看了哪行报错、用什么关键词搜了内部文档、中间哪一步改错了导致程序崩溃、看到什么信号意识到不对、又怎么退回去改好的。这段“发现走错路、再拐回来”的过程,才是模型最需要的训练材料。
为了搞清楚不同行业的人到底是怎么干活的,10 月底 Mercor 联合斯坦福和美国劳工部 O\*NET 团队发了一个叫 TaskNet 的项目。
他们觉得传统的问卷调查太慢、也问不出细节,干脆做了一个“AI 面试官”,直接去和各行各业的从业者聊天,把他们日常工作里那些很难写进教科书的操作习惯和判断标准一点点问出来,整理成新的任务库。
第二件是把真实软件做成一个能反复跑、还不漏题的沙箱。
有了任务,技术团队得把它变成一个模型可以进去操作的运行环境。
这比想象中要繁琐得多。11 月初刚发布的学术项目 WebHarbor 就是一个例子:为了让智能体学会操作网页,研究人员把 153 个真实网站的页面、后端逻辑和登录状态全部复制下来,封装成了稳定的本地容器。这样模型在里面做上万次点击和下单练习,才不会因为原网站改版或者封 IP 而中断。
在把环境交给模厂之前,数商自己还得先做一轮内测:拿现有的模型进去跑几遍,专门检查有没有没删干净的日志、测试脚本是不是太容易被绕过去。
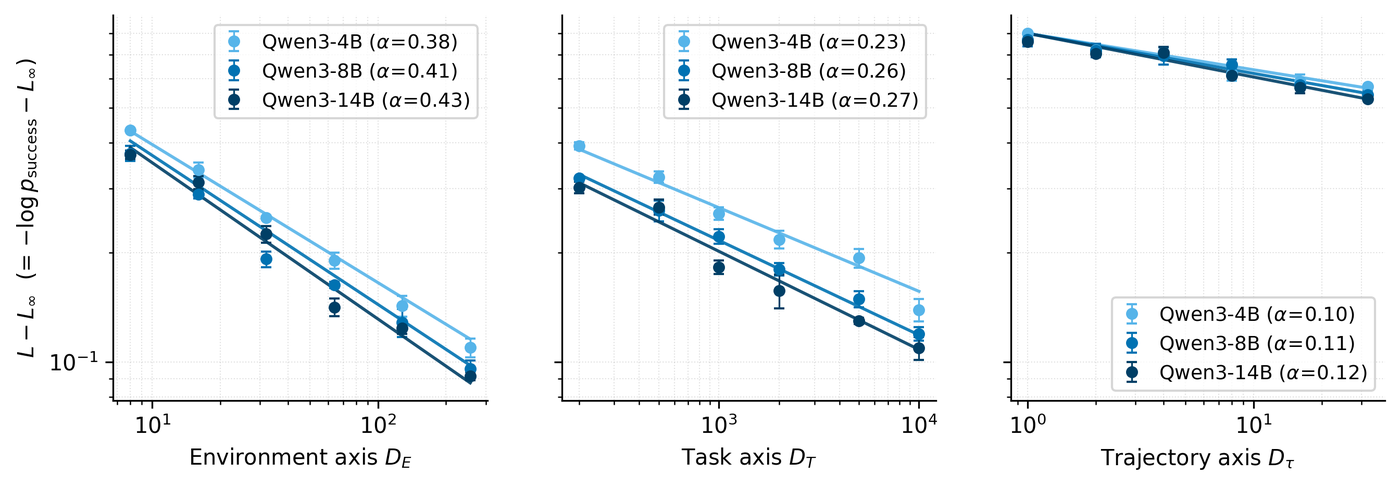
三张折线图,横轴依次为 Environment axis DE、Task axis DT、Trajectory axis Dτ 且为对数刻度,纵轴为 L − L∞ (= −log psuccess − L∞);每张图三条曲线分别标注 Qwen3-4B、Qwen3-8B、Qwen3-14B 及对应 α 值(左图 0.38 / 0.41 / 0.43,中图 0.23 / 0.26 / 0.27,右图 0.10 / 0.11 / 0.12),三条曲线均随横轴增大而下降
第三件是定打分规则(Rubric),而且规则得跟着模型一起改。
写代码和算数学最省心,过了测试就是对,不过就是错。但现实里大部分工作是没有标准答案的。
比如让模型做一份尽调报告,或者做一套幻灯片,怎样算好?这就需要做 Eval 的人把行业专家的主观感受,拆成几十条具体的打分细则。有做这块业务的朋友说,这活儿干起来特别像产品经理,核心是把“体验好”翻译成一条条可以量化的检查项。
到了 10 月底,arXiv 上好几篇论文都在讨论同一个问题:静态的打分规则很快就会失效。
因为现在的打分大多是“踩点给分”,模型跑几轮之后就摸清套路了——只要回答写得足够长,把所有可能沾边的词都堆上去,总分就一定高。这也是为什么最近很多刷榜很猛的模型,用起来却满嘴废话。
所以现在数商交付打分规则,也得做成动态的。一方面要加扣分项,说废话要扣分;另一方面,当模型在现有的采分点上已经拿满时,打分表本身也得跟着升级。
为了省成本,平时训练用便宜的小模型按规则初筛,后台再留一部分预算,定期用更强的评测模型去抽查那些高分回答,看它到底是真的写得好,还是在糊弄评分器。
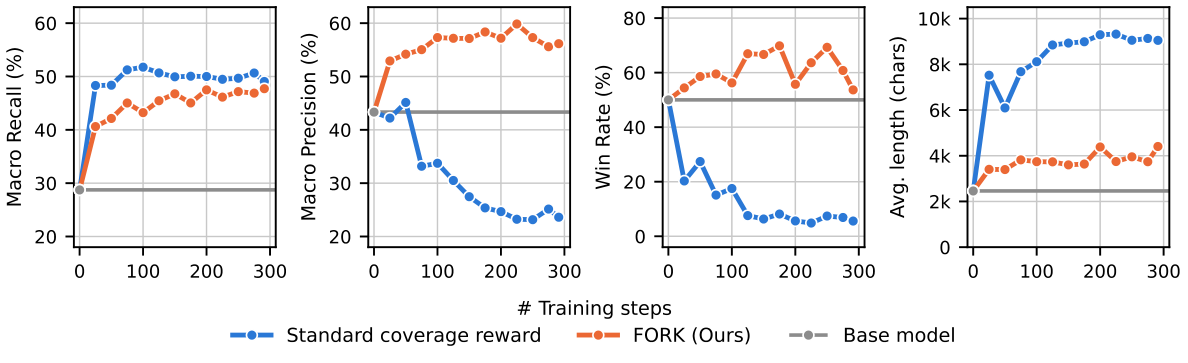
四张折线图,纵轴依次为 Macro Recall (%)、Macro Precision (%)、Win Rate (%)、Avg. length (chars),横轴为 # Training steps 从 0 到 300;蓝色曲线为 Standard coverage reward、橙色为 FORK (Ours)、灰色水平线为 Base model;随训练步数增加,蓝色曲线的 Macro Precision 从约 43% 降到约 23%、Avg. length 升到约 9k,橙色曲线的 Macro Precision 升到约 58%、Avg. length 稳定在 4k 左右
0303 这门生意怎么才能长久?
把这套流程看下来,其实就能理解为什么一些数商的 founder 在赚钱的同时,危机感也很重。
数据这门生意有一个天然的弱点:一套评测或训练环境,是有半衰期的。
在模厂眼里,任何一个第三方 benchmark 或环境被买回来之后,很快就会变成训练目标。模型放进去反复刷上两三个月,这项能力学会了,这批数据的价值也就榨干了。数商又得赶紧去打听模厂下一个季度想补什么能力,重新找人、重新搭环境。
如果一直停留在按项目交货的模式,数商本质上还是高级一点的外包工作室,今年赚得盆满钵满,明年可能就因为模厂换了训练方向而断粮。
要变成一门长久的生意,数商们现在主要在试三条路。
第一条路,是把“卖数据包”变成“卖云服务”。
以前数商把环境打包发给模厂,一锤子买卖就结束了。但现在智能体训练的规模越来越大,成千上万个环境同时跑起来,怎么管理容器状态、怎么在有限的算力预算下调度采样(比如 10 月底刚出的 EnvSched 框架)、怎么保证验证器的稳定运行,变成了一个很重的工程问题。
在硅谷,Post-train as a Service(后训练即服务)已经逐渐清晰起来。一些头部的环境商和算力平台不再直接卖镜像,而是把环境留在自己的云端,让模厂和应用公司通过 API 连进来训练,按模型在环境里交互的步数和调用验证器的次数收费。
比如 Prime Intellect,在 10 月中旬直接收购了做轻量级视觉模型和推理引擎的 Moondream,把训练环境、底层推理加速和模型训练绑在了一起。只要客户还在持续训练模型,这套基础设施就能一直收租。
第二条路,是去赚应用公司和传统企业的钱。
10 月中旬 Mercor 发布过一份《美国经济基准地图》。他们盘点了全美 923 个职业、近两万项具体任务,算出来一个挺有意思的结论:美国人 90% 的日常工作时间,现有的 AI 评测基准根本没有覆盖到。
基模公司的精力和预算终归是有限的,它们只能先抓编程、数学、通用办公这几个最大的领域。但往下走,大量的垂直应用公司和传统大企业,也开始有了后训练的需求。
我们在《后训练不是AI应用的救世主》里提到过,像 Genspark 联合 Fireworks AI 基于开源底座做后训练,训出来的幻灯片模型效果接近 Opus 5,但成本只有十七分之一。对很多应用公司来说,为了把单用户的成本(UE)算过来,后训练是一门迟早要补的课;
对传统大企业来说,拿开源模型结合自己的业务数据做后训练、再私有化部署,也是最符合数据合规的选择。
但这些公司大多没有专门的后训练团队,不知道怎么建自己的 Eval、怎么搭环境。这时候,给顶级模厂干过活、手里有成熟管线的数商,顺理成章就可以往下走,去接这些企业的定制化和托管服务。虽然单子不如模厂那么大,但胜在客户多、周期长,很像当年云计算兴起时的第三方技术服务商。
第三条路,是把各行各业的真人专家留在自己手里。
很多人担心合成数据迟早会替代数商。但在可见的未来,只要真实世界的软件还在更新、行业规则还在变化,模型在碰到能力边界时,依然需要真人专家去给它做示范、定标准。
这件事真正的门槛,不在于招几个兼职,而在于当客户提出一个很冷门的专业需求时——比如跨境税务合规,或者某种工业软件的故障排查——你能不能在几天之内,从几万人的库里迅速找出真正懂行、而且配合度高的熟手。
算法和代码很容易被同行抄走,但怎么把散落在全球的行业专家筛选出来、定好价、管好质量,这其实是一套很重的运营体系。
说到底,数据行业那个靠消息灵通、靠攒几个名校学生就能轻松拿大单的阶段,已经在慢慢过去了。
当后训练本身越来越像一门精细的制造业,数商也没法永远活在神秘的传说里。接下来拼的,无非是谁的环境更稳、谁的专家库更扎实、谁能真正帮客户把模型的成本降下来。把这些苦活干明白了,这门生意才算真正立住了脚。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
[1] How Data Scales in Agentic RL,arXiv:2610.23946v2,Figure 1
[2] Gradient Routing Localizes and Removes Unintended Behaviors in RL(GRAFT),arXiv:2610.17062v1,Figure 1
[3] How Data Scales in Agentic RL,arXiv:2610.23946v2,Figure 2
[4] Eat Your Precision / FORK,arXiv:2610.33512v1,Figure 1