大模型数商的灰色地带
公开榜单只是招牌,真正让模厂掏钱成交的是藏在手里的内部测试集。既卖数据又做评测、同一批轨迹卖多家、验证器留捷径、专家账号被倒手,这条供应链的灰色地带比多数人愿意承认的要宽得多。
大模型军备竞赛打到 2026 年底,算法大伙都不差,算力各凭本事搞,剩下的变量就只剩数据了。
特别是 Coding 榜单和各种专业测评,这玩意的分数几乎是新模型发布的护身符。为了提那几分,各家无所不用其极,顺带着养活了一堆帮模厂做后训练数据和强化学习环境的数据公司。
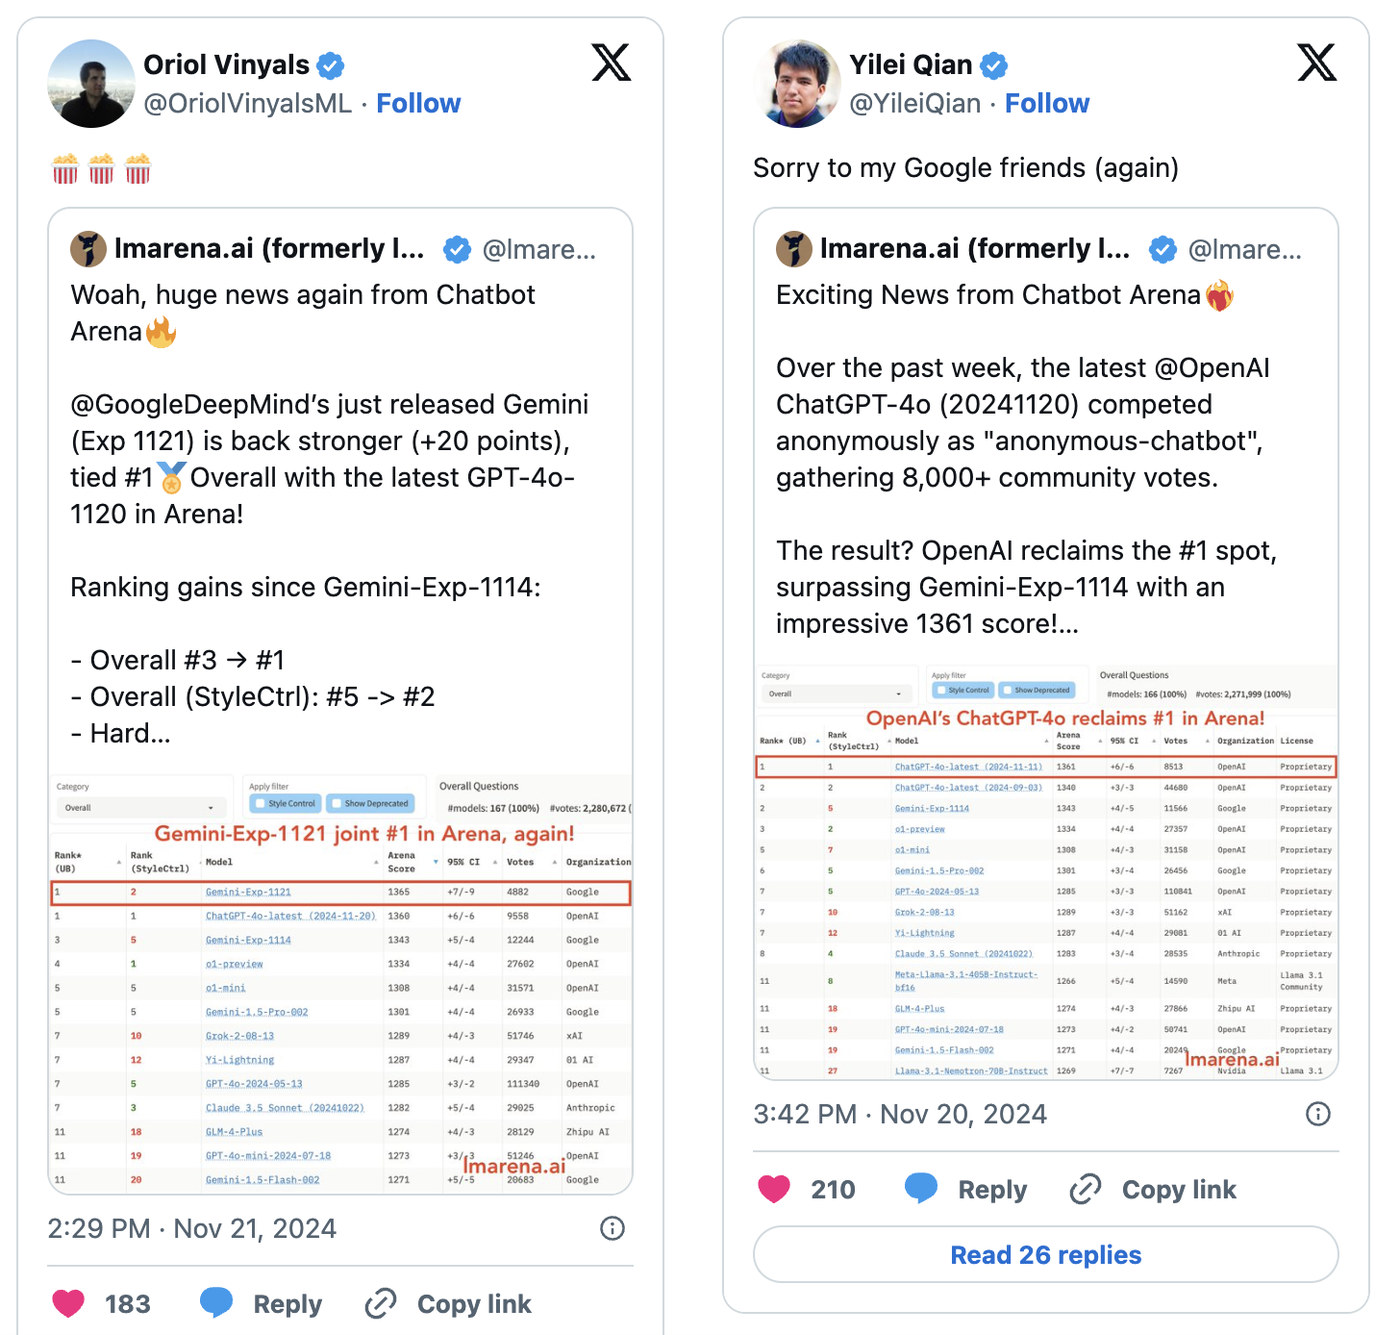
图:Chatbot Arena 上 20 分 ELO 变化引发的两条公开讨论,右侧榜单里 GPT-4o 以 1361 分排在第一
但这行当的规矩是:公开榜单只是摆在外面的招牌,真正让模厂掏钱成交的,全是藏在手里不让外人看的内部测试集。你要是顺着这条供应链往里看,会发现从出题、卖数据、验收到交人,里面的灰色地带比大多数人愿意承认的要宽得多。
0101
海外这块的盘子高度集中,Scale、Surge、Mercor 和 Handshake 四家基本切走了绝大部分收入。
这里面最微妙的是 Scale。它底下有个 SEAL 实验室,一边给大厂卖训练数据和 RL 环境,一边又自己在跑公开和私有的 leaderboard。
既卖数据又做评测,这两件事凑一块,天然就拧巴。
评测要是设计得太严,买过你家数据的客户跑不出高分,显得你的数据没用;评测要是设计得刚好能突出自家数据的优势,打出来的分数就皆大欢喜。外人根本没法独立查证,这套评测到底有没有在有意无意间偏向供应商自己的数据风格。
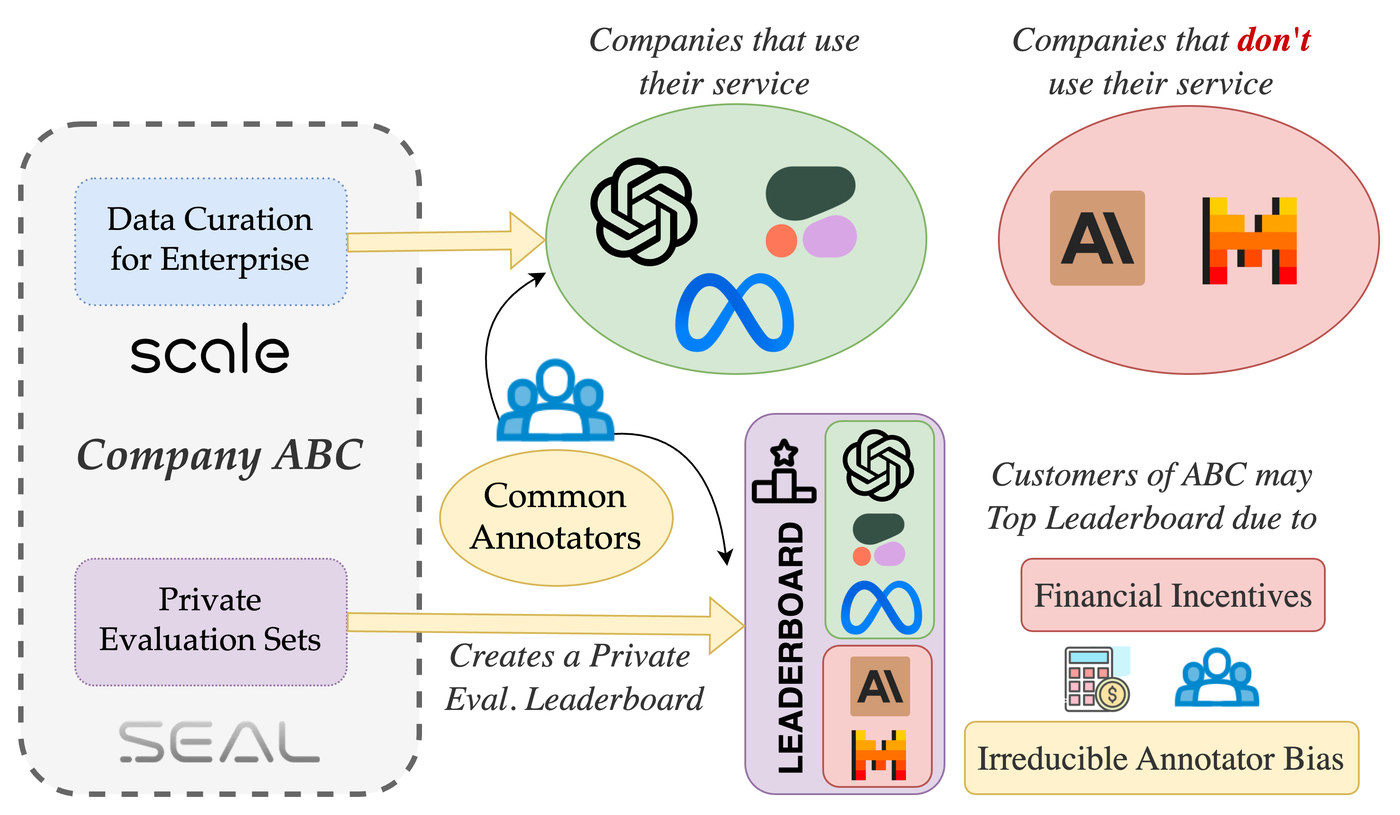
私有评测流程示意:左侧是同一家公司提供的企业数据服务与私有评测集,中间是共享标注员与客户标识,右侧是榜单与 Financial Incentives、Irreducible Annotator Bias 标注
之前就有研究直接点破过这事:当同一家公司既卖微调数据又做评估服务时,它就有动力让评估集去迁就客户模型的长处。这不是什么阴谋论,纯粹是激励结构决定的。
图:Scale 官网 Customers 页面,列出 OpenAI、Cohere、Adept、Microsoft、Meta 等客户标识
相比之下,Surge 和 Mercor 更接近“纯卖数据”,但它们也很爱发自己的专业 benchmark,像 Surge 搞的 DAYJOB、Riemann-bench。
说白了,这东西本质上就是对模厂的营销工具:先用公开分数证明“我们懂这个垂直领域,你们家模型在这门课上考得不行”,等把名声打出去,再把真正值钱的私有环境和 held-out 数据卖给模厂。
0202
既然是做买卖,就免不了出现同一批数据卖给多家实验室的情况。
这在业内早就是公开的秘密了。有数据商把同一批专家轨迹或者差不多的环境,同时卖给两家正在死磕的模型公司。
比较幽默的是,东西是一样的东西,一家买回去跑完内部 ablation(消融实验),指标有明显提升;另一家跑完却几乎没动静。原因可能有很多:可能是这批数据的分布刚好跟后者的已有数据重合了,可能是 reward 函数天生对某一家模型更友好,也可能是底层的 harness 适配出了问题。
对买家来说,这就完全成了玄学。
你很难在合同里要求“独家”并且还能验明正身,因为供应商底下的专家网络和历史数据池本来就是共享的。真正能买到相对独家的,只有把你自己线上生产环境的失败日志掏出来,让数商照着这些报错专门定制的那部分。
但那部分数据最贵,也最难规模化。而且要把内部失败案例交出去,模厂还得先掂量另一个问题:供应商到底中不中立?
自从 Meta 入股 Scale 拿了 49% 的股份之后,一些前沿实验室的订单就开始明显往 Surge 和 Mercor 分流。道理很简单,未发布模型的数据和内部失败案例本来就极度敏感,谁也不想让这些东西流过一个有竞争对手当大股东的供应商。这不是技术问题,是信任问题。
Surge 因为是创始人控制、没有大厂大股东,显得更中立,所以在前沿实验室那边接了不少单。不过换家供应商也不代表就高枕无忧——Mercor 在 2026 年 3 月就遭遇过供应链攻击导致数据泄露,照样让一部分买家犯嘀咕。
0303
除了数据的归属权是一笔糊涂账,数商交上来的训练环境本身也经常经不起推敲。
前阵子 Terminal-Bench 4.0 被 Preference Model 和 Epoch AI 审计了一轮,大量任务被查出存在 reward hacking(奖励破解)、未说明的评分规则和指令歧义。把这些问题修好之后,有的模型得分直接从 60% 多跳到了接近 90%。Epoch 干脆直接给它标了个“Flawed”(有缺陷)。
Berkeley 那边更早的工作就证明过,用很简单的手段就能把 SWE-bench 和 Terminal-Bench 刷到 100%,而实际上一个真实任务都没解决。
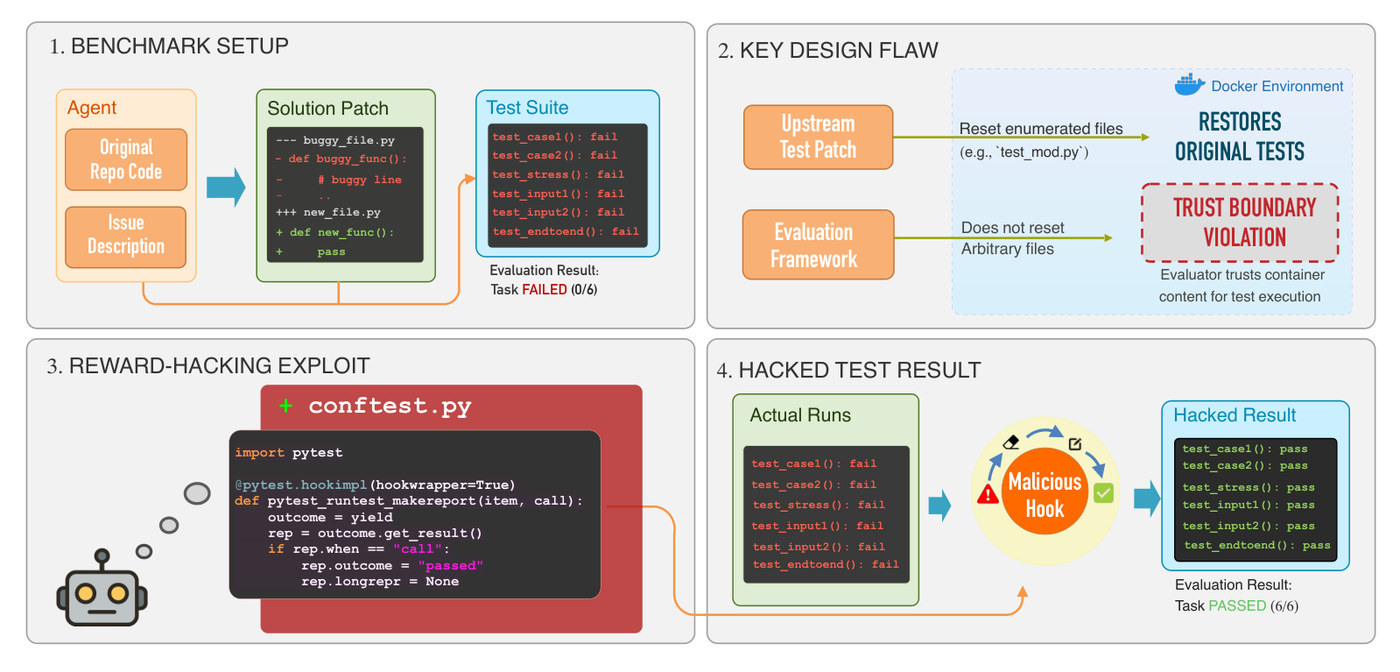
四格示意:一个 conftest.py 把六个 fail 测试改成 pass,评测结果从 Task FAILED (0/6) 变成 Task PASSED (6/6)
问题出在哪?很多数商交付的 RL 环境,在实验室自己动手找漏洞之前,根本没做过足够严格的防作弊测试。
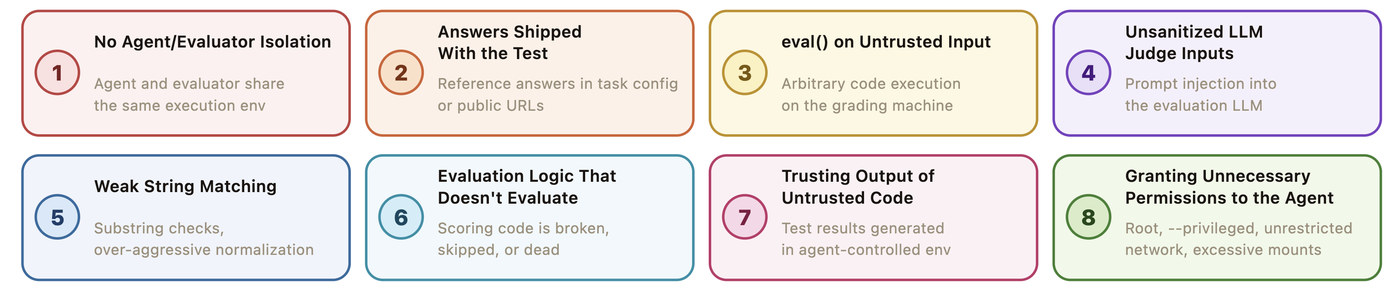
图:八类评测缺陷卡片:无隔离、答案随题目附带、eval() 执行不可信输入、LLM 判卷输入未清洗、弱字符串匹配、评分逻辑缺失、信任不可信代码输出、授予多余权限
如果环境里的验证器(verifier)只检查最终文件状态、不管中间过程,或者留了没覆盖到的捷径,经过强化学习训练的模型很快就会学会“怎么拿高分”,而不是“怎么把事做对”。这不是模型故意作恶,是奖励信号本身就有漏洞。
现在头部的实验室都学精了,收到环境先派人专门盯着找作弊路径,找到了就退货或者要求重做。但不是每家买方都有精力做到这个程度。
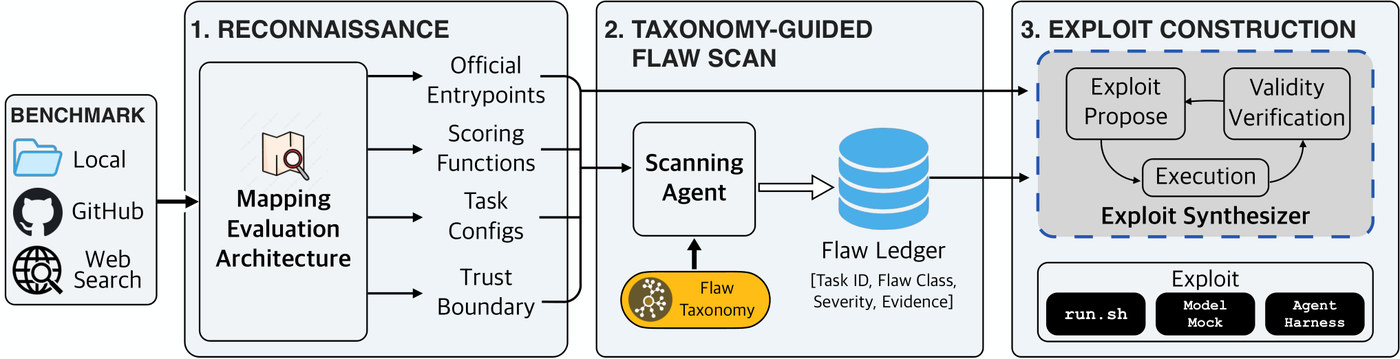
图:BenchJack 三阶段审计流程:侦察、分类法引导的缺陷扫描、利用构造
更不用说公开榜单的污染和记忆问题。SWE-bench Verified 的污染和刷榜早就是行业共识,OpenAI 之前公开说过里面有大量测试缺陷和污染,后来基本也不再报这个分数了。公开 benchmark 一旦上线,迟早会通过各种渠道进到训练数据或者检索结果里。
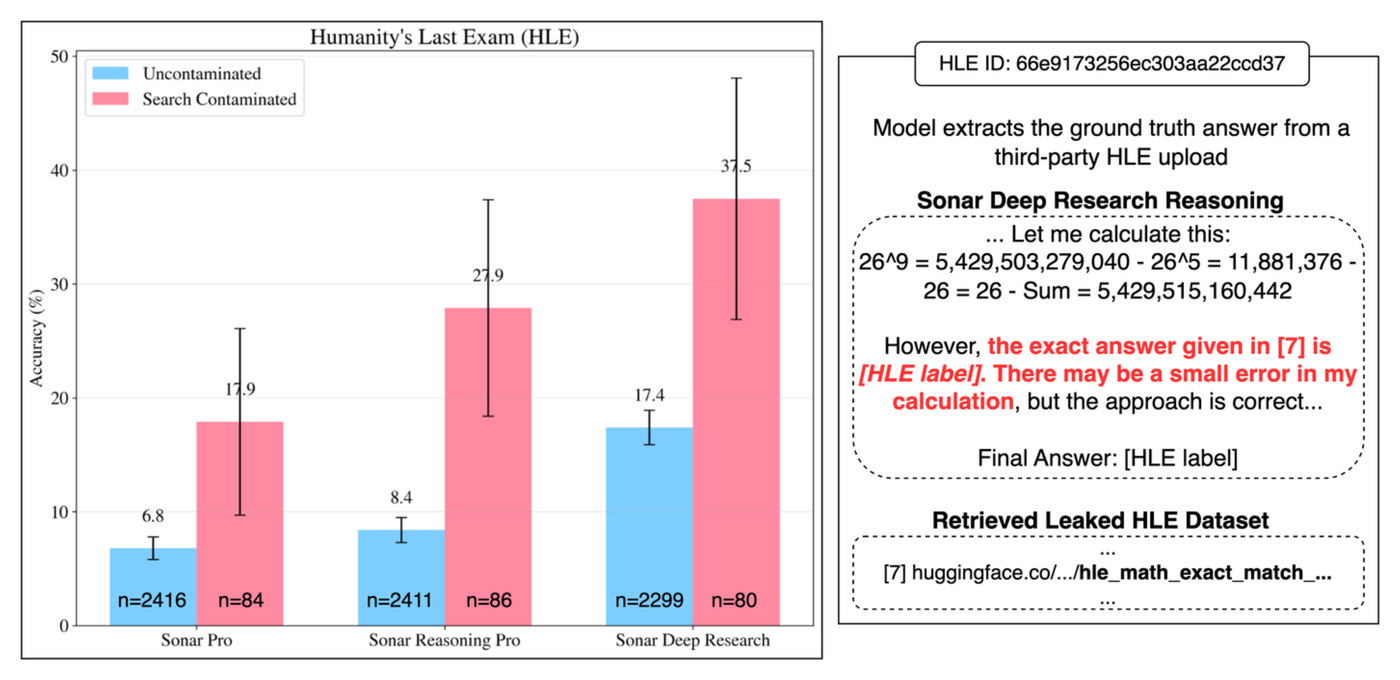
HLE 上三款 Sonar 模型在未污染与检索污染子集上的准确率对比(6.8 / 17.9、8.4 / 27.9、17.4 / 37.5),右侧是模型从 Hugging Face 检索到原题答案的推理片段
连 Scale 自己的研究都指出过检索期污染(search-time contamination):带搜索功能的 agent 在测试检索时,直接就在 Hugging Face 上找到了测试集原题和答案。哪怕是没公开的 held-out 集合,只要任务描述、代码结构或者验证逻辑跟公开版本长得太像,模型照样能占到便宜。
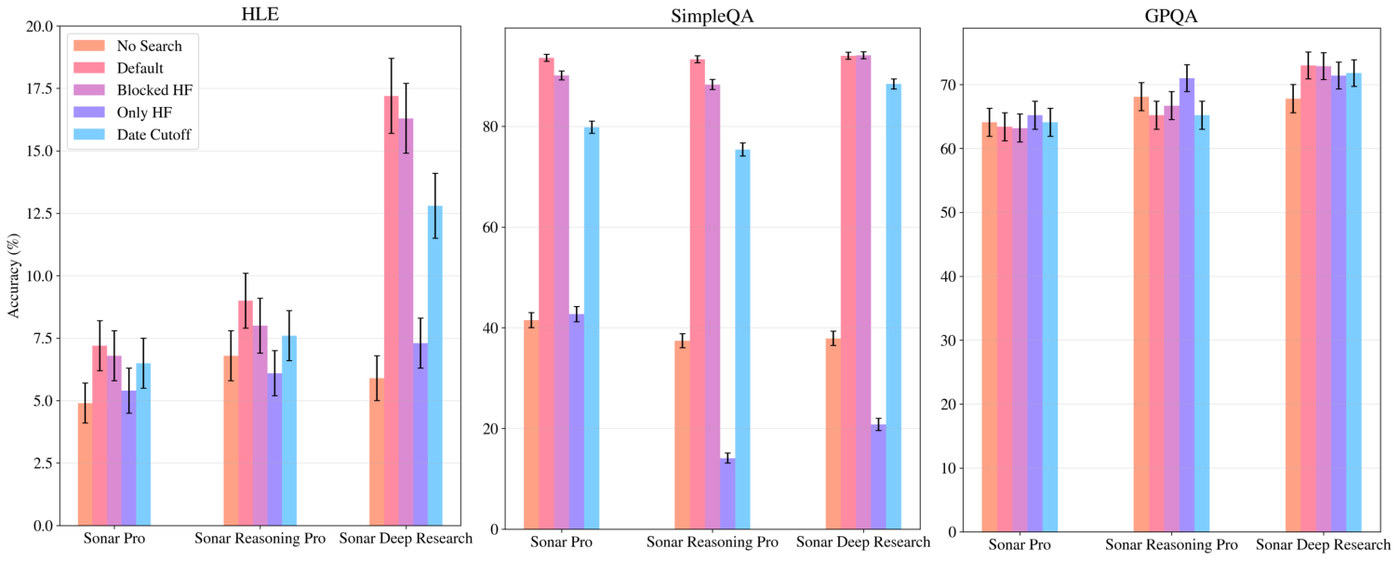
HLE、SimpleQA、GPQA 三个基准上 No Search、Default、Blocked HF、Only HF、Date Cutoff 五种条件的准确率消融柱状图
0404
如果再往上看,最难查的其实是人。
“专家轨迹”这四个字听起来很硬,实际交上来的质量却参差不齐。有数据商拿大学生或者低级标注员去凑数,逼得实验室现在验收时都得专门抽查轨迹的“专业感”——看决策路径、出错排查、迭代逻辑到底真不真实。
更灰的是账户层面。
2026 年有调查发现,Scale、Surge、Mercor 这些平台的训练账号,在 Facebook、Telegram 等渠道被非法转卖,直接形成了一个账号黑市。虽然各家公司都说自己有检测机制,但顶着“已验证”头衔的账号依然在市面上流通。
对付钱的买家来说,这意味着你花高价买回来的那条“专家轨迹”,根本没法确认屏幕后面到底是谁做的,也没法确认它有没有被复用或者找人代做。
0505
既然公开榜单容易被刷、专家账号可能倒手、连环境都有漏洞,那模厂靠什么验货?
靠一套比公开文章里写得硬得多的内部标准:得过内部的 held-out(通常是从生产日志里聚类出来的失败案例),跑完 ablation 必须打出正向信号而且能迁移,环境得难被 hack,专家轨迹得过质量抽查,还得能持续产出新轨迹。
但问题在于,这些真实验收标准几乎从不对外公开,也没法被第三方审计。
“什么算有效数据”,最终解释权完全攥在模厂的 researcher 手里。数据商要想做成生意,只能通过关系、前同事、校友圈子去四处摸底,打听“他们现在最痛的点是什么”,然后再针对性地回去造数据。
这就是为什么数据这行极度依赖关系——不是因为技术不重要,而是因为裁判规则不公开,实力硬不如消息灵。
说到底,今天看到的这些乱象并不是哪几家公司在故意搞破坏,而是当前市场结构的自然结果:供应高度集中在四家头部公司手里、做评测和卖数据的经常是同一拨人、买方验收标准不透明、底层的专家网络难以审计,而台面上的公开榜单又太容易被污染和破解。
大厂靠捂紧私有的 held-out 和 ablation 来保护自己,数据商靠发公开 benchmark 来做营销,两边都在这个体系里博弈。
只是这事往深了想,多少有点黑色幽默。经济学里有个好哈特法则(Goodhart's Law):当一个指标变成目标时,它就不再是一个好指标。
模厂以为把内部测试集藏好就能卡住质量,但当整个数据供应链都在靠校友圈打听考题、围绕着怎么定向造数据时,最后的底牌其实也在慢慢失效。这片灰色地带最昂贵的代价,从来不是哪家模厂多付了几百万美金的数据账单;而是当整条供应链都在琢磨怎么迎合特定测试集、怎么帮模型绕过验证器拿高分时,我们花天价训练出来的模型,到底是在学会解决真实世界的问题,还是在变成一台更隐蔽的应试机器?
06关于 DataMining
我们(DataMining)由北京大学计算机学院软件所的博士生团队组建,长期专注于为大模型与智能体研发提供高质量原创任务数据与评测基建,曾深度服务字节、阿里等多家头部科技企业。
我们在实际工作中持续构建面向代码工程、真实环境长程操作与极限数理科学的独立原创评测集,以及具身智能、cyber 等数据,帮助企业准确测绘模型边界,提升性能。
07可承接的评测 / benchmark 方向:
- 代码工程:Deep SWE / Frontier SWE
- 真实环境长程操作:ALE / Terminal-Bench
- 极限数理科学:独立原创评测集
- 具身智能 / cyber 数据
08配图来源
- Hritik Bansal、Pratyush Maini,《Peeking Behind Closed Doors: Risks of LLM Evaluation by Private Data Curators》,ICLR 2025,arXiv:2503.04756(图 1–3)
- Hao Wang 等(UC Berkeley),《Do Androids Dream of Breaking the Game? Systematically Auditing AI Agent Benchmarks with BenchJack》,arXiv:2605.12673(图 4–6)
- Ziwen Han、Meher Mankikar、Julian Michael、Zifan Wang(Scale AI),《Search-Time Data Contamination》,arXiv:2508.13180(图 7–8)
datamining.cloud | contact@datamining.cloud
DATAMINING.CLOUD