数据配比:固定算力下的零和博弈(下)
DataMining · 2026年11月6日
上一篇说完了洗和造,这一篇专门讲配。
配比的核心逻辑很简单:总token数固定。你给代码多一点,其他数据就一定少一点。这不是理论问题,是每天训练都要面对的现实。
0101 分阶段投放是怎么来的
早期大家基本是一次性混好就一直训。后来发现效果不好。模型最终行为受训练末期数据影响极大。学习率还大的时候,模型学得比较粗;快收尾、学习率衰减的时候,学得更细。这时候再投放最珍贵的数据,调整手感最有效。
SmolLM3就是典型例子:
- 第一阶段(大概8T–9T):基础web为主,代码10%左右,数学3%,多语言12%。先把知识面覆盖住。
- 第二阶段:引入更高质量的数学和代码(FineMath4+、MegaMath等)。
- 第三阶段(衰减期,大概1.1T):再把OpenMathReasoning、OpenCodeReasoning这类高精度推理和指令数据放进去。
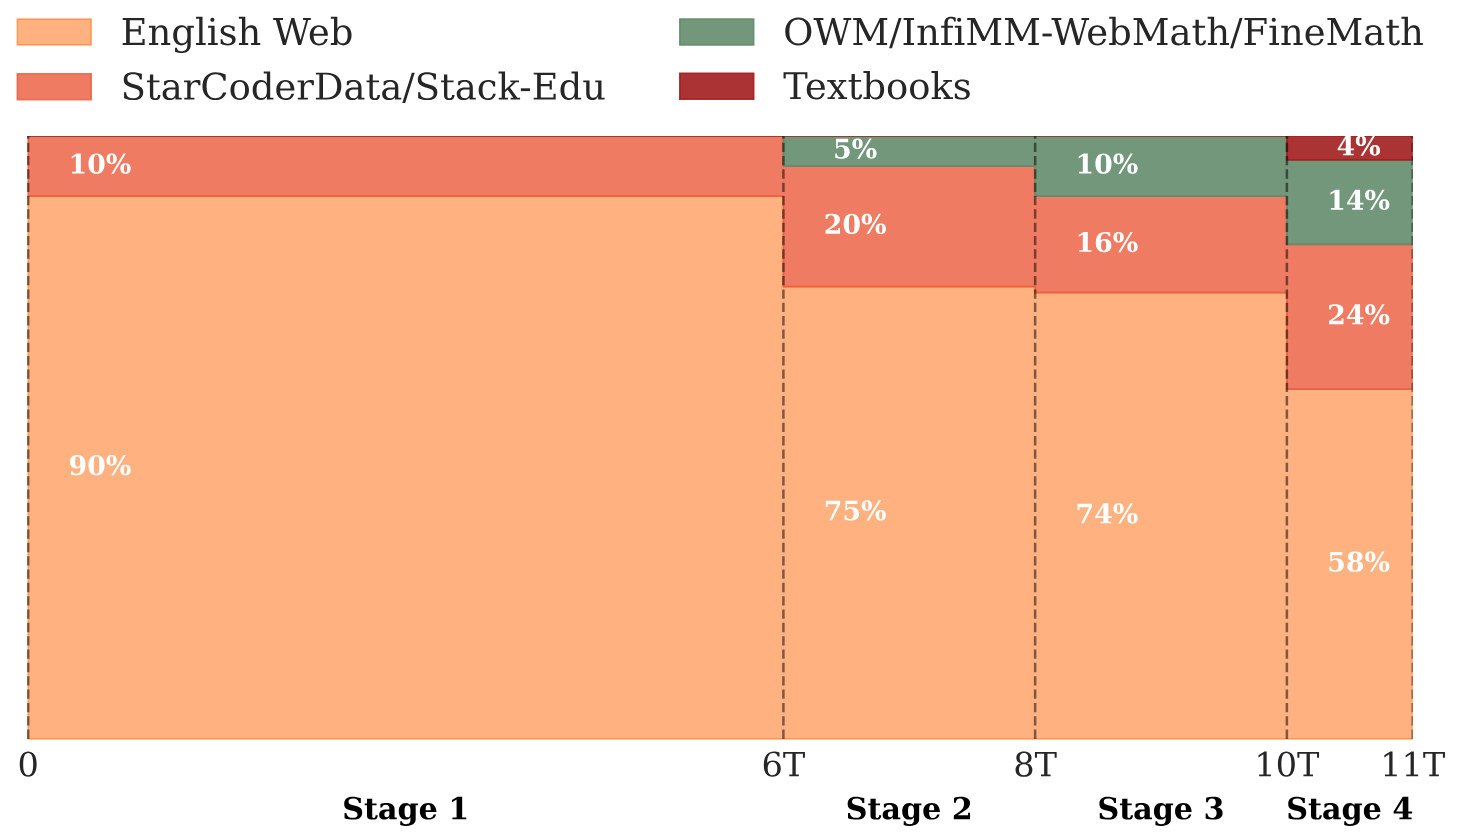
四阶段堆叠面积图,横轴是 0、6T、8T、10T、11T 训练 token,依次标注 Stage 1 到 Stage 4;图例为 English Web、StarCoderData/Stack-Edu、OWM/InfiMM-WebMath/FineMath、Textbooks 四类;各阶段分别标注 90% 与 10%、75% 与 20% 与 5%、74% 与 16% 与 10%、58% 与 24% 与 14% 与 4%
这个逻辑像复习考试。你不会第一天就把最珍贵的往年真题全做完,然后后面天天刷烂题。你会先过一遍基础知识,最后几天再刷真题调整手感。
OLMo 2也是类似思路:前期大头是web,后期退火阶段切到更高质量的Dolmino-Mix,然后再做model soup。Llama 3训练过程中也会动态上采样数学、补更新的web数据。
0202 退火消融:怎么低成本验证新数据集
每来一个新数据集就从头训11T,成本太高。所以现在普遍用退火消融:取训练到7T附近的checkpoint,用40%原有配方 + 60%候选新数据集,再跑50B tokens看看效果。几天就有答案。MegaMath就是这么测出来的。
这个方法能把验证成本从“几个月”降到“几天”,而且信号足够判断值不值得进下一阶段。
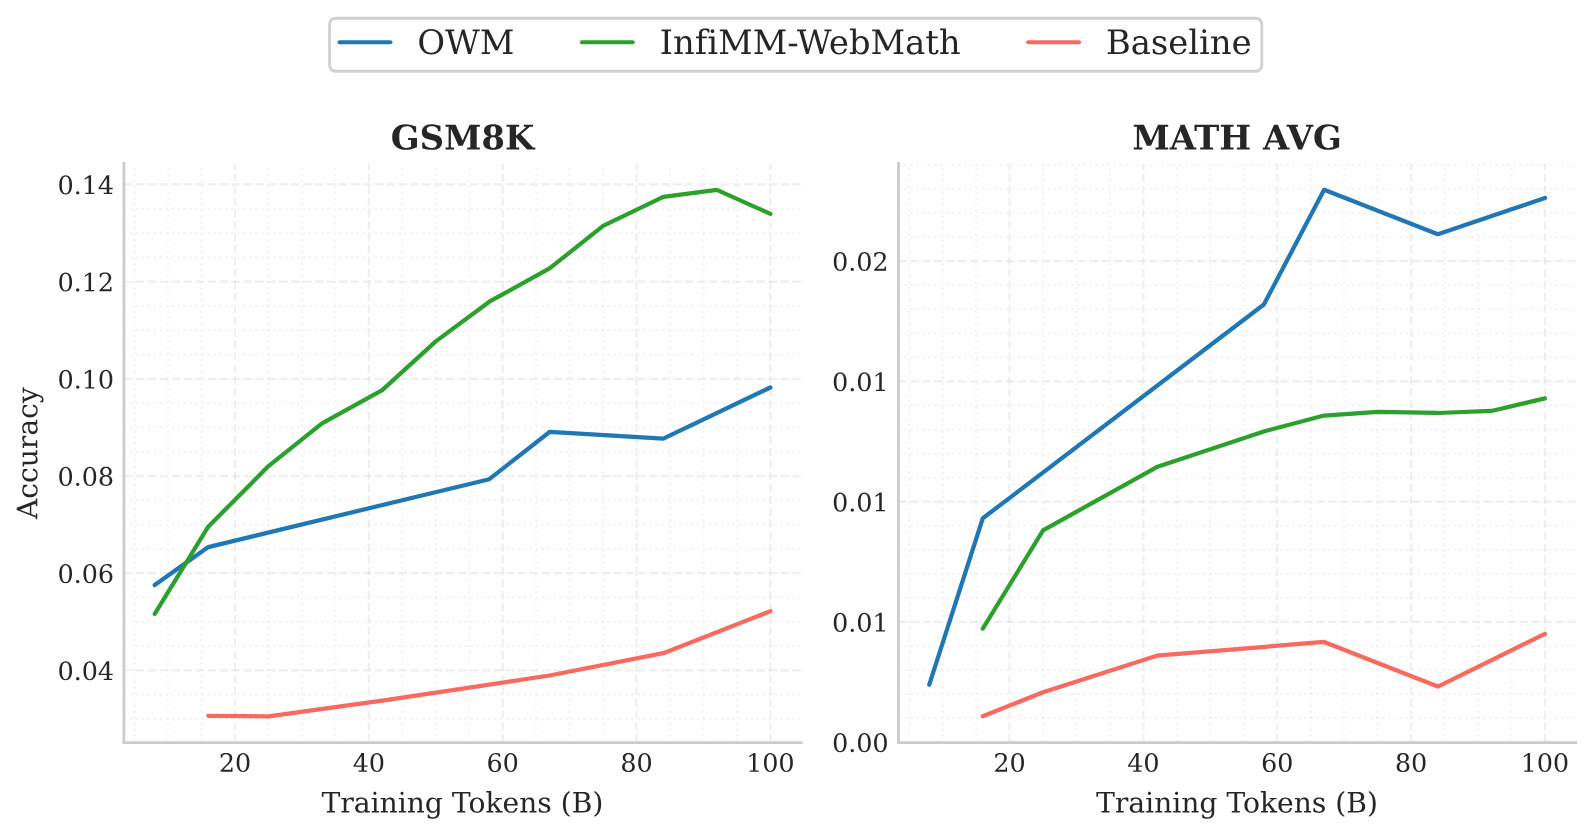
两张折线图分别标注 GSM8K 与 MATH AVG,横轴 Training Tokens (B) 从 0 到 100,纵轴 Accuracy;图例为 OWM、InfiMM-WebMath、Baseline 三条曲线
0303 自动配比算法为什么还没替代人工
DoReMi、RegMix这些方法论文里很优雅:用小模型或者回归拟合,让模型自己学每个数据域该给多少权重。听起来比人肉尝试比例科学多了。
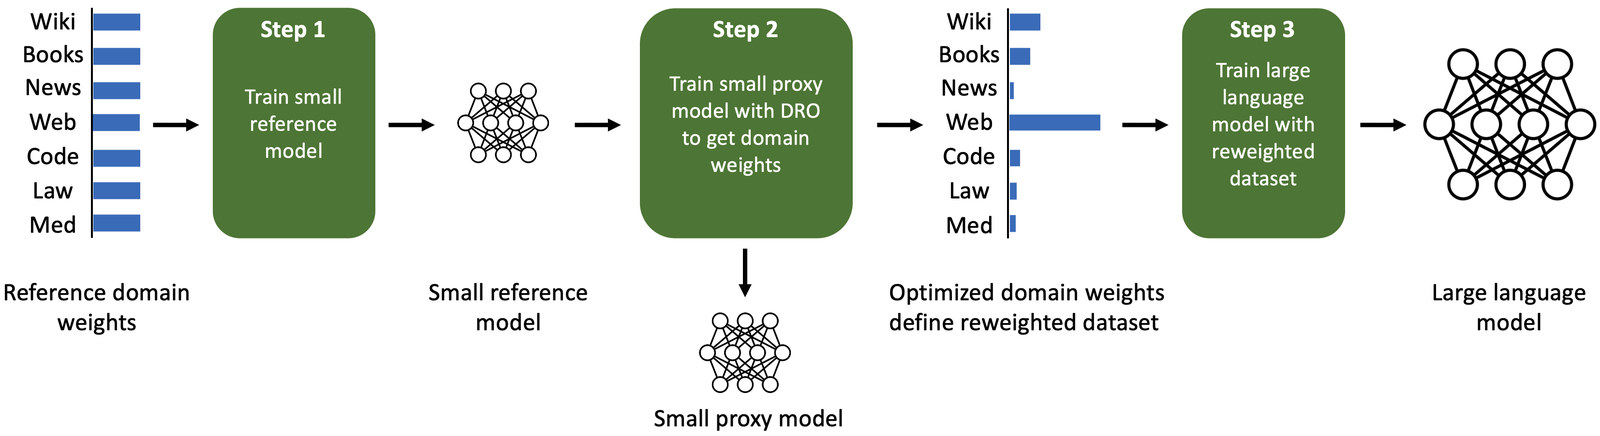
三步流程图:左侧 Wiki、Books、News、Web、Code、Law、Med 七根长短不一的蓝色权重条,标注 Reference domain weights;Step 1 绿框写着 Train small reference model,Step 2 绿框写着 Train small proxy model with DRO to get domain weights,Step 3 绿框写着 Train large language model with reweighted dataset;右侧是优化后同样七类的权重条与一个神经网络示意图
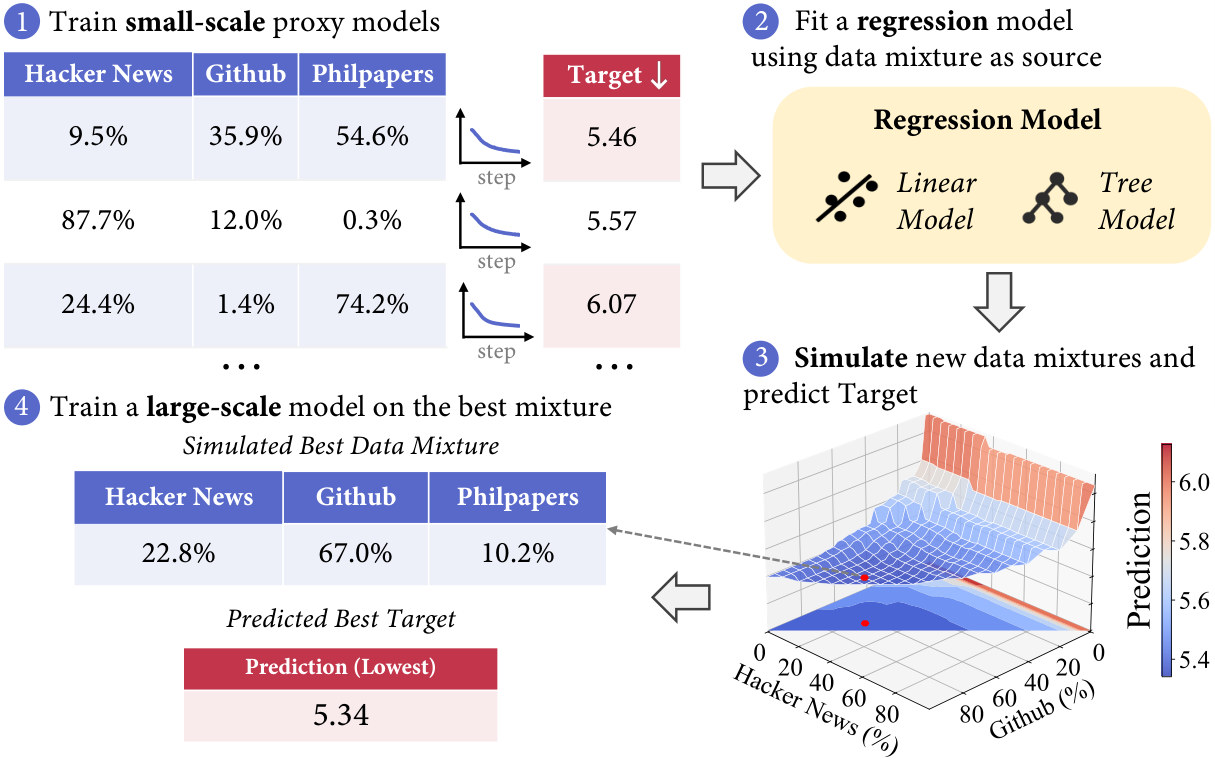
四步示意图:① Train small-scale proxy models,表格列出 Hacker News、Github、Philpapers 三列的百分比组合(9.5%/35.9%/54.6% 等)与对应 Target 数值 5.46、5.57、6.07;② Fit a regression model using data mixture as source,黄框内写 Regression Model 与 Linear Model、Tree Model;③ Simulate new data mixtures and predict Target,右侧是三维曲面图,横轴 Hacker News (%)、Github (%),色条为 Prediction 5.4–6.0;④ Train a large-scale model on the best mixture,底部 Predicted Best Target 为 5.34
但实践中,尤其是SmolLM3这种万亿token级别,这些方法最后学出来的权重,往往高度接近数据集本身的自然大小分布。说白了就是“有什么就多用什么”,最终没打过精心设计的人工消融。
原因很实际:代理模型和目标模型在规模、训练长度、评估指标上存在偏移;跨域交互和重复效应很难被简单回归完全捕捉。
现在有些新工作(比如RegMix-D)开始用整条loss轨迹去做动态混合,有人用模型合并来降低搜索成本,但在真正大规模上,核心配方还是靠“跑一组实验→看关键分数→调整比例→再跑一组”。
0404 隐藏的工程坑
就算配比定好了,数据加载细节也能把训练搞砸。
最典型的是shuffle问题。文档本身shuffle了,但batch里面的序列还是从文档里顺序读。短文档问题不大,但代码文件经常很长。如果某个长文件质量很差,它可以填满一整个batch。模型连续吃一批同源的烂数据,loss就突然跳一下。
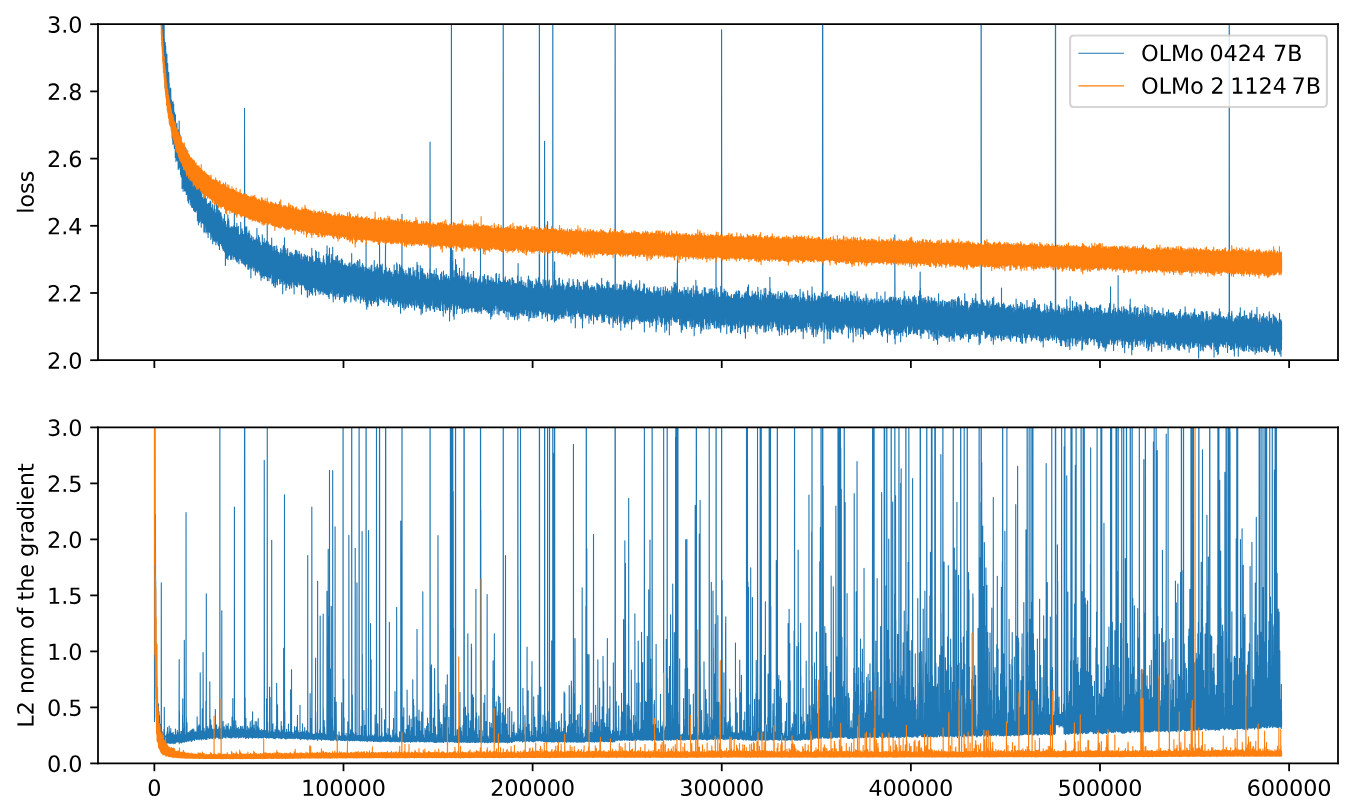
上下两张曲线图,上图纵轴为 loss(2.0–3.0),下图纵轴为 L2 norm of the gradient(0.0–3.0),横轴训练步数到 600000;图例蓝色为 OLMo 0424 7B、橙色为 OLMo 2 1124 7B,蓝色曲线在上下两图中都出现大量竖直尖峰,橙色曲线平滑
修复方法很朴素:把分词后的序列提前离线shuffle,每个epoch换一个seed;同时把内部重复n-gram特别多的文档删掉。OLMo2也验证过类似处理能明显降低spike频率。
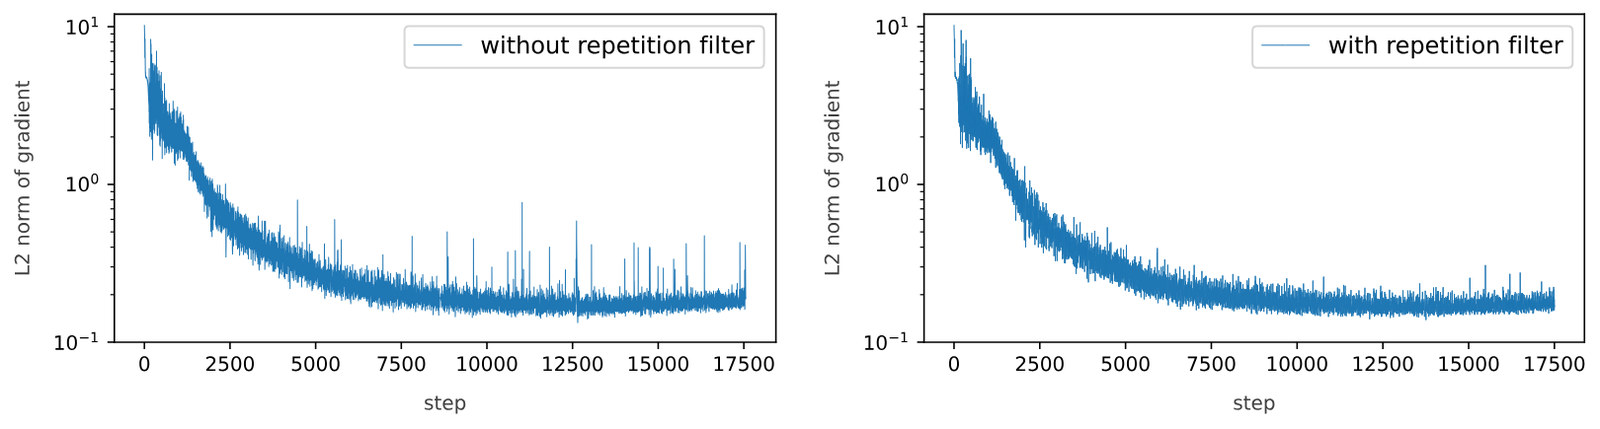
左右并排两张梯度范数曲线,纵轴 L2 norm of gradient 为对数刻度 10⁻¹ 到 10¹,横轴 step 从 0 到 17500;左图图例 without repetition filter、右图图例 with repetition filter,左图后半段竖直尖峰明显多于右图
其他耦合点还包括:去重和污染检查必须在配比前完成;质量过滤和配比会互相影响;长上下文扩展阶段的数据上采样也要单独验证。
0505 最后说点实际的
数据配比的上限从来不是“目标想要什么”,而是“手里有多少不重复的高质量数据”。盲目提升稀缺数据的占比,只会让模型死记硬背。
目前最稳妥的路径还是:库存约束清晰 + 分阶段课程 + 末期精细数据投放 + 大量小规模消融验证。自动算法可以当辅助,但还替代不了经验判断。
洗数据是减法,造数据是加法,配数据是在固定算力里决定模型每天学什么。这三步任何一步偷懒,最终效果都会打折。公开报告往往只给最终配方,真正有价值的是那些失败的实验和工程约束被还原出来的过程。
如果你正在做类似的事,建议把配比实验设计成可复用的小规模消融框架,明确库存、重复阈值和关键评估指标。这比追求“一键最优配比算法”更接近现在能落地的现实。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
[1] SmolLM2: When Smol Goes Big — Data-Centric Training of a Small Language Model,arXiv:2502.02737,Figure 2
[2] SmolLM2,arXiv:2502.02737,Figure 5
[3] DoReMi,arXiv:2305.10429,Figure 1
[4] RegMix,arXiv:2407.01492,Figure 3
[5] 2 OLMo 2 Furious,arXiv:2501.00656,Figure 2
[6] 2 OLMo 2 Furious,arXiv:2501.00656,Figure 3