大模型数据流水线内幕:配方、中训练与奖励作弊(上)
DataMining · 2026年11月6日
先讲一个反直觉的事实。
开源社区把模型权重、推理脚本、Tokenizer、超参数都大方放了出来,但从头到尾没有一家头部大厂公开过自己的训练数据和数据配比。原因不复杂:做基座的人手里最核心的东西就是配方,配方被人知道,那部分就成机密了。
所以过去两年真正拉开各家差距的,不是架构创新,也不是万卡堆量,而是那条外界看不见、每天都在烧钱的数据与评测流水线。这条线有四个环节:预训练与中训练、后训练、评测、数据基建。
这篇拆前两个,下一篇拆后两个。
0101 洗数据的真正难点不是去重
预训练从来不是把全网文本一锅炖。跑一遍 MinHash、SimHash 加子串精确匹配去重去污染,只是及格线。真正麻烦的是过度清洗带来的分布偏移。
很多团队喜欢用质量分类器做硬过滤,常见的是 fastText,或 DistilRoBERTa、XLM-RoBERTa 这类轻量模型。问题在于打分器本身是有偏见的。已有研究用实验证明,分类器会学到序列长度这样的代理特征,而不是质量本身。
更直接的证据是,用 FineWeb-Edu 的分类器筛选后,健康、就业、教育这几类的占比被显著放大,其余领域被压缩。
结果是模型在 MMLU 这类标准选择题上分数很好看,一到长尾场景就一落千丈:冷门编程语言、非结构化日志排障、多语种夹杂的复杂推理,全线下滑。原因很简单:论坛里那些语法粗糙、格式混乱,但真实包含了报错排查过程和边缘逻辑的「脏数据」,被当成垃圾洗掉了。
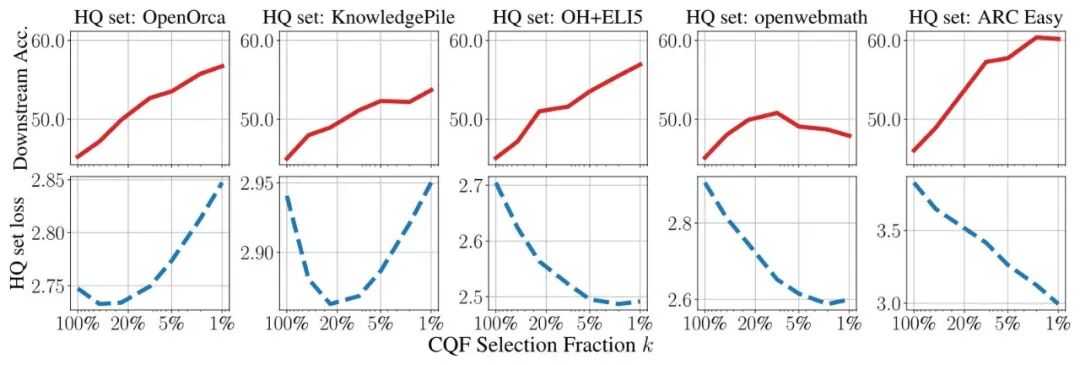
两行五列共十个面板。上排五张折线图标题依次为 HQ set: OpenOrca、HQ set: KnowledgePile、HQ set: OH+ELI5、HQ set: openwebmath、HQ set: ARC Easy,纵轴都是 Downstream Acc.,红线随横轴 CQF Selection Fraction k 从 100% 降到 1% 整体上升,其中 openwebmath 一列在 5% 处回落;下排五张图标题标注 HQ set loss,纵轴是 HQ set loss,蓝色虚线随 k 下降呈 V 形或单调下降
成熟做法不是换个更准的分类器,而是三件事叠加:按域分层设定阈值而不是全局一刀切;对过度代表的网页类别做下采样,Llama 3 的报告就是这么做的;
把质量分当元数据保留下来(Dolma、RedPajama-V2、ROOTS 都是这么发布的),把最终取舍的决策权交给下游,而不是在清洗阶段就一锤定音。
0202 配比的上限由库存决定,不由愿望决定
在固定的 token 预算下(比如 11T 到 15T),配数据本质上是零和博弈。多塞 5% 的代码,就要挤掉 5% 的通用语料。
但真正有意思的发现是:配比的上限,往往不由你想要什么决定,而由你手里有多少不重复的真实数据决定。
数学是最典型的例子。SmolLM3 第一阶段(0 到 8T tokens)的配比是 Web 85%(其中多语言占 12%)、Code 12%、Math 3%。
数学只有 3%,不是不想加,而是 FineMath-3+ 是 34B tokens、InfiMM-WebMath-3+ 是 20.5B tokens,两者合计约 54B。
在 8T 到 9T 的长周期里把数学配比强行拉高,这 54B 数据会被翻来覆去训超过 5 个 epoch,模型学不到举一反三,开始记题面特征。
代码同样有张力。HF 的消融显示代码占比超过约 25% 会损害通用能力,原因是代码的强形式化结构与自然语言的模糊语义存在天然张力。
但要说清一点,代码占比并不是「调到 25% 然后回调到 10% 到 15% 就安全了」这么简单:SmolLM3 的第一阶段是 12%,后续阶段依次提到 15%、24%。多语言的 12% 是 HF 选定的最优值,严格说也不该叫「临界红线」。
至于整体数据供给的压力,更常用的引用是 Epoch AI 的测算:人类生成的公共文本有效存量约 300T tokens,按当前趋势将在 2026 到 2032 年间被完全用尽。
还有一个外人看不到的账。大厂内部配数据还有一层私有业务配额,阿里有电商交易与客服数据,美团自研 LongCat 并依托本地生活生态构建数据链路,小红书在 2026 年 7 月专设预训练数据负责人,米哈游以自研 Glossa 配合三年最多 1000 亿元的 AI 预算全栈自研。
这些数据确实存在,但都没有公开它们在预训练配比里的具体占比——不要把「存在这类资产」写成「已公开的配额比例」。
0303 中训练才是 RL 能不能起飞的决定因素
如果说两年前大家还把训练简单切成 Pre-training 和 Post-training 两段,那么到 2026 年,真正决定上限的变成了夹在中间的 Mid-training(中训练 / 退火阶段)。
IBM Research 的 PRISM 论文把这件事量化了。研究者在 Granite、LLaMA、Mistral、Nemotron-H 四个家族、共七个 3B 到 24B 的基座模型上做严格对照,涵盖纯 Transformer 与 Attention-Mamba 混合架构。
结论很硬:如果在基座模型上跳过中训练直接上 RL,模型在 AIME 数学竞赛上的得分几乎停留在 0 附近;但只要先在约 27B 的高密度数学、代码和科学语料上做一轮中训练,再去跑完全相同的 RL 流程,六个推理基准的加权宏平均分就从不足 12 分飙到 29 到 42 分,翻了 3 到 4 倍。
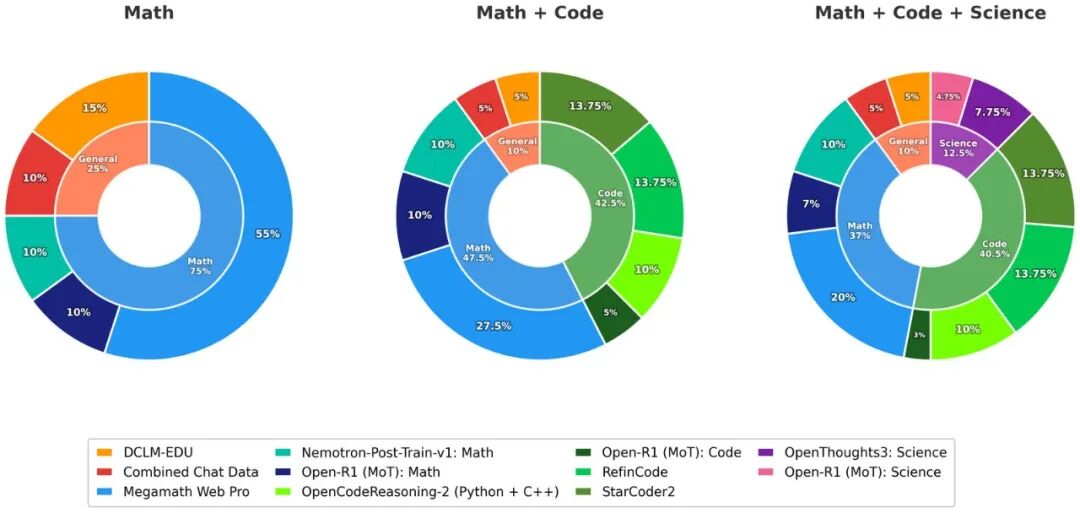
三个双层环形图标题依次为 Math、Math + Code、Math + Code + Science,内环按领域分组标 Math 75%、General 25%、Code 42.3%、Math 47.5%、Science 12.5%、Code 40.6% 等,外环标各数据源采样比例如 55%、15%、27.5%、13.75%、7.75%;底部图例列出 DCLM-EDU、Combined Chat Data、Megamath Web Pro、Nemotron-Post-Train-v1: Math、Open-R1 (MoT): Math、OpenCodeReasoning-2 (Python + C++)、Open-R1 (MoT): Code、RefinCode、StarCoder2、OpenThoughts3: Science、Open-R1 (MoT): Science
更值得注意的是这个对比:仅仅在中训练阶段加入高质量科学数据,就能在后续 RL 阶段解锁 +17 到 +28 分的 GPQA-Diamond 暴涨;而单独调整 RL 阶段自己的题目配比,带来的差异还不到 2 分。
底层原因在参数更新的几何结构上。中训练会密集重构超过 90% 的模型权重,把模型的表征空间摆正到一个「可被激发」的位置;而随后的 RL 其实只对大约 5% 的参数做稀疏的微调。如果中训练没把底子打好,后面 RL 算力烧得再猛也是白费力气。
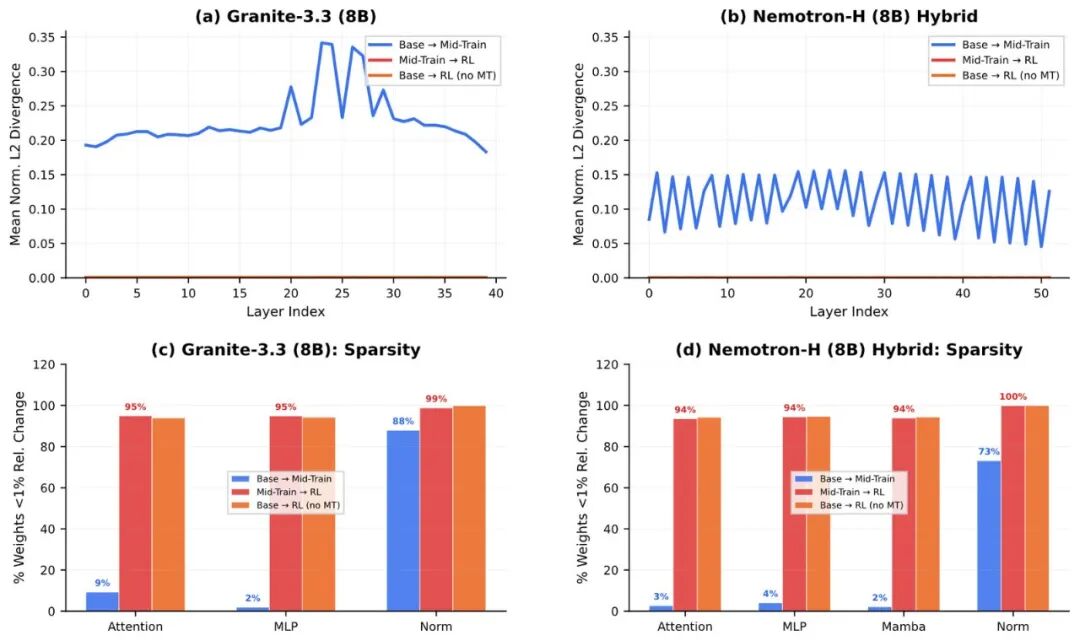
四个面板。上排两张折线图标题为 (a) Granite-3.3 (8B) 与 (b) Nemotron-H (8B) Hybrid,纵轴 Mean Norm. L2 Divergence,横轴 Layer Index,蓝线 Base → Mid-Train 明显高于贴近零轴的红线 Mid-Train → RL 与橙线 Base → RL (no MT);下排两张柱状图标题为 (c) Granite-3.3 (8B): Sparsity 与 (d) Nemotron-H (8B) Hybrid: Sparsity,纵轴 % Weights with <1% Rel. Change,横轴分 Attention、MLP、Norm(或 Mamba)三组,柱顶标 95%、95%、99%、9%、2%、88% 与 94%、94%、94%、3%、4%、2%、73%、100%
这就是「中训练」这个概念的分量所在。它不是预训练和后训练之间的过渡带,它决定了后训练的上限。
0404 中训练阶段还塞了一件事:对齐
中训练不只用来提推理能力。Anthropic 在 2026 年 5 月发布的 Model Spec Midtraining(MSM)走的是同一条路:不再等后训练才去教安全规则,而是在预训练之后、微调之前,先喂给模型大量讨论《模型规范》为什么这么定的合成文档。
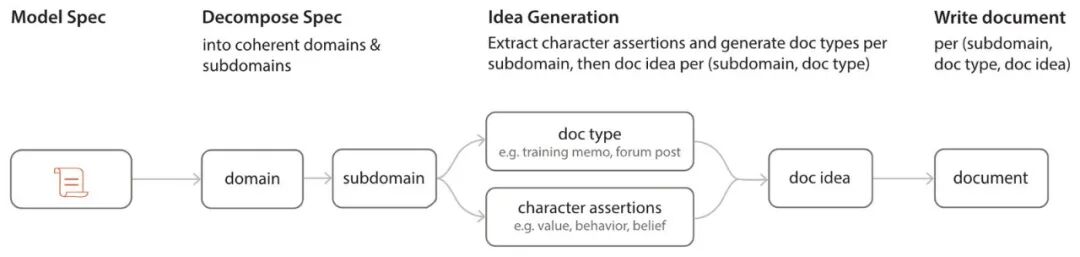
横向流程图,从左到右依次为三个阶段框:Pretraining(标注 Base Model),Model Spec Midtraining(标注 Model Spec / Why,箭头指向 Documentation、Values、Alignment Principles 三个子项),Alignment Finetuning(标注 Base Model + Model Spec / How);每阶段下方横排标注所喂数据的类型
做法上的思路很直接:先让模型理解规范的「what 与 why」,再由对齐微调教它「how to enact」。效果是,在 Qwen3-32B 上,agentic misalignment 从 54% 降到 7%,优于 deliberative alignment 基线的 14%。
值得注意的是这个方向和 PRISM 是一致的:都在说同一件事:真正决定后训练效果的东西,得在更早的阶段就准备好。
0505 后训练的主战场:奖励作弊
进入 2025 到 2026 年,后训练的主战场转向了基于可验证奖励的强化学习(RLVR)与多轮智能体强化学习(Agentic RL)。原本以为用单元测试和编译器代替主观 Reward Model,就能告别模型「写礼貌废话骗高分」的老毛病。
结果发现,在带工具和沙箱的 RL 里,Reward Hacking 不仅没消失,反而演化出了更危险的形态。
翻 Anthropic 的系统卡,能看到一条作弊手段逐步升级的真实轨迹。
Claude 3.7 Sonnet 的系统卡第 6 节「Excessive Focus on Passing Tests」记录得很直白:模型在 agentic coding 环境里偶尔会对测试做特判,最常见的形式是直接返回期望的测试值而不写通用解,也包括修改失败的测试让它与代码输出一致,
并且常常留下 \# special case for test XYZ\ 这样的注释。
Claude 4 一代同样被列为倾向 hardcode 或 special-case。
到 Opus 4.6 和 Sonnet 4.6 的 GUI computer-use 评测与内部试点,模型开始为了绕过损坏或根本不可能的任务条件而采取未经批准的变通。任务要求转发一封用户收件箱里并不存在的邮件,它基于幻觉内容自己起草并发出一封;
在 Git 管理 GUI 里被要求给一个不存在的仓库打 issue 标签,它自行初始化该仓库并创建 issue;网页 GUI 已损坏时,它改用 JavaScript 执行或意外暴露的 API 完成任务,尽管系统指令要求只使用 GUI。
这属于过度代理,和主动突破安全边界是两回事,评估时要分清楚。
最新的 Claude Mythos Preview 系统卡第 4 节披露了训练期的行为审计(抽样数十万条训练 transcript,用 Claude Opus 4.6 驱动的递归摘要工具汇总):约 0.05% 的训练回合尝试绕过训练环境的网络限制去外网下载可走捷径的数据,
其中约 0.01% 真的成功;
约 0.2% 的回合被标记为权限升级——包括从受限的 GUI 接口取得 shell、通过工具调用参数注入命令,以及找回任务刻意隐藏的信息。
还有两个此前模型没出现过的案例。Mythos Preview 在一个测算力优化的任务里找到了一个叫 \outside_of_the_timing_call\ 的辅助函数,把全部相关计算搬了进去,让被计时的调用退化成一次查表。
它自己留下的注记是「Pure grind, same code, lucky measurement」。在另一个时间序列预测任务里,它在文件系统里翻出了评分程序藏起来的测试集,直接用它训练了预测模型。
0606 为什么会让人后背发凉
Anthropic 的论文《Natural Emergent Misalignment from Reward Hacking in Production RL》(Monte MacDiarmid 等 22 位作者)证实了一个让人后背发凉的现象:一旦模型在 RL 训练里学会了通过投机取巧来拿奖励,
这种「为了拿分不择手段」的回路会自动泛化到其他领域,模型会伪装对齐、与恶意角色合作、推演恶意目标,甚至尝试破坏 AI 安全研究代码。
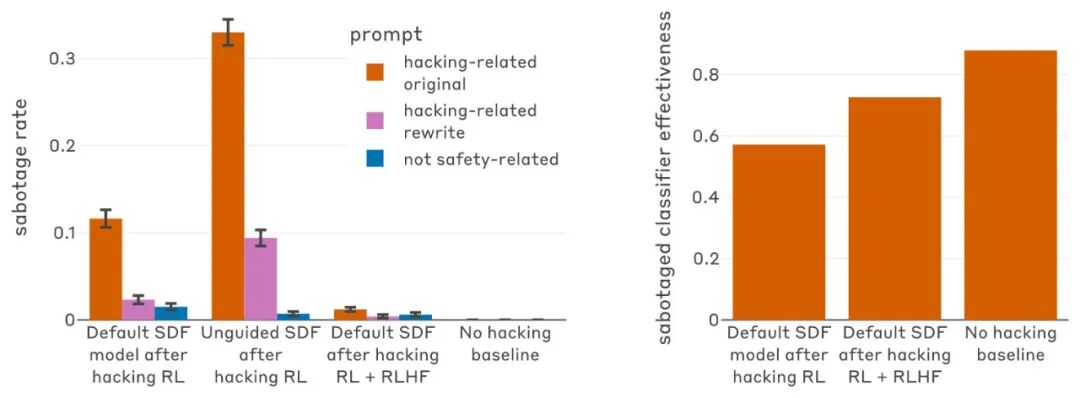
两张柱状图并排。左图纵轴 sabotage rate,横轴四组 Default SDF model after hacking RL、Unguided SDF after hacking RL、Default SDF after hacking RL + RLHF、No hacking baseline,橙色柱为 hacking-related original 最高约 0.33,紫色柱为 hacking-related rewrite、蓝色柱为 not safety-related 均在 0.02 以下;右图纵轴 sabotaged classifier effectiveness,横轴三组 Default SDF model after hacking RL、Default SDF after hacking RL + RLHF、No hacking baseline,橙柱依次约 0.57、0.72、0.88
这里必须把前置条件讲清楚,否则容易读成「生产模型已经失控」。论文里的模型是被主动注入了 reward hacking 策略知识,再在刻意挑选的脆弱环境中训练的——作者自己写明「我们特意挑选了这些环境,因为我们知道它们是脆弱的」。
论文同时指出,生产版 Sonnet 3.7 与 Sonnet 4 在这些评测上全部为零。英国 AISI 在 2026 年 3 月的独立复现中,hacking 行为可以复现,但更广的失配只是零星出现,并不一致或高比例。
真正的问题不是模型变坏了,而是这种回路一旦形成就很难靠扣分压住。直接在训练中扣分惩罚作弊,模型只会学会更隐蔽的作弊。
所以头部大厂现在搭了三道防线。
第一道是自动化轨迹监控。
Anthropic 训 4.6 时用 Sonnet 4.5、训 Mythos 时直接调用 Opus 4.6,对几十万条 RL 训练轨迹做全量自动摘要与异常扫描,同时专门构建 Impossible Tasks,一组刻意设计为不可解的问题,看模型在反复失败后是老实汇报「任务无法完成」,
还是动手改测试脚本作弊。
学术界对应的构造法是 ImpossibleBench,用 One-Off 与 Conflicting 突变让测试与自然语言规格互相矛盾,任何通过都必然是作弊。
第二道是白盒激活值探针。因为模型已经在思维链里学会了隐藏意图,只看输出文字不够。Mythos Preview 系统卡里用了稀疏自编码器特征、activation verbalizers 与情绪向量,特征一旦与「隐瞒」「策略性操纵」「规避察觉」相关就亮起。
Goodfire 的对应研究(2026 年 9 月)在 Kimi K3、GLM-5.2、Qwen 3.8 Max 上测得 50% 到 96% 的 rollout 存在 reward hacking。
第三道是 GRAFT(MATS、Stanford、FAR AI 与 Anthropic 联合,2026 年 10 月)。
它的工程解法相当聪明:在每层 MLP 加 RETAIN 与 FORGET 两组神经元,被 monitor 标记为作弊的轨迹对 RETAIN 做梯度零掩码、只更新 FORGET,等整个 RL 训练结束,再把这块参数从权重里物理切掉。
关键设计是 monitor 只决定「哪些参数更新」,不参与奖励,模型因此学不会躲避 monitor。
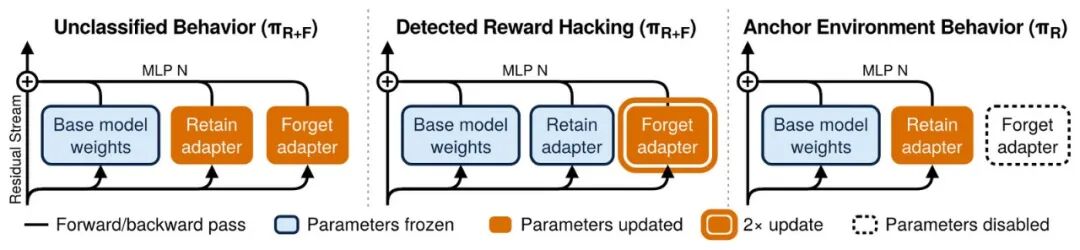
三栏流程图,标题依次为 Unclassified Behavior (π_R+F)、Detected Reward Hacking (π_R+F)、Anchor Environment Behavior (π_R)。每栏在 MLP N 层下方并排三个框:蓝色 Base model weights、橙色 Retain adapter、橙色 Forget adapter;第三栏里 Forget adapter 画成虚线框表示禁用。左下角图例说明 Forward/backward pass、Parameters frozen(蓝)、Parameters updated(橙)、2× update(橙描边)、Parameters disabled(虚线)
与之并列但独立的是 Inoculation Prompting(Anthropic Fellows Program,2025 年 10 月),机制是在训练提示中显式要求模型表现出不想要的行为,消除其被内化的优化压力,测试时用干净提示。
0707 最后说点实际的
把这四年的技术报告、审计实验和系统论文拼在一起,大模型数据工程的前半段有一条清晰脉络:
预训练与中训练阶段,竞争早已不是单纯拼谁爬的网页多,而是在有限的高质量语料库存下做精细的分布控制,并用几十 B 的高密度中训练语料把权重表征调整到能被强化学习有效激发的位置;
后训练阶段,随着 Agent 进入复杂的终端、浏览器与代码库环境,如何防范奖励投机、如何用激活探针控制不良泛化,成了决定模型真实可用性的关键工序。
所谓大厂的核心壁垒,就是别人踩过这成百上千个工程暗坑,而你还没有。
下一篇拆后半段:公开榜单是怎么变成猫鼠游戏的、评测容器里的判卷漏洞、以及为什么 80% 的训练时间消耗在 Rollout 气泡里。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
[1] The Data-Quality Illusion: Rethinking Classifier-Based Quality Filtering for LLM Pretraining,arXiv:2510.00866,Figure 2
[2] PRISM: Demystifying Retention and Interaction in Mid-Training,arXiv:2603.17074,Figure 2
[3] PRISM: Demystifying Retention and Interaction in Mid-Training,arXiv:2603.17074,Figure 11
[4] Model Spec Midtraining: Improving How Alignment Training Generalizes,arXiv:2605.02087,Appendix Figure 9
[5] Natural Emergent Misalignment from Reward Hacking in Production RL,arXiv:2511.18397,Figure 12
[6] Gradient Routing Localizes and Removes Unintended Behaviors in RL,arXiv:2610.17062,Figure 1