过了单元测试,只是软件工程的幻觉
DataMining · 2026年11月6日
今年早些时候,行业还在为 SWE-bench 上的高分狂欢。但到了秋天,潮水退去。
OpenAI 已经悄悄把 SWE-bench Verified 移出衡量前沿编程能力的核心指标;独立评测机构 METR 的报告则指出了一个尴尬的事实:那些在测试集里大杀四方的代码补丁,一旦扔进真实的开源社区,仓库维护者(Maintainer)连看都不会看一眼,更别提合入主干(Merge into main)。
10 月底,随着 Artificial Analysis 更新第 5 代智能指数(AA v5),长程软件工程的评判标准完成了一次残酷的换血。由 Cognition 联合顶尖开源项目维护者打造的 FrontierCode 2.0 正式成为核心指标,辅以升级后的 SWE-bench Pro V2、DeepSWE 1.1,以及 11 月初冒头的 ServerBench 和 CompressionBench。
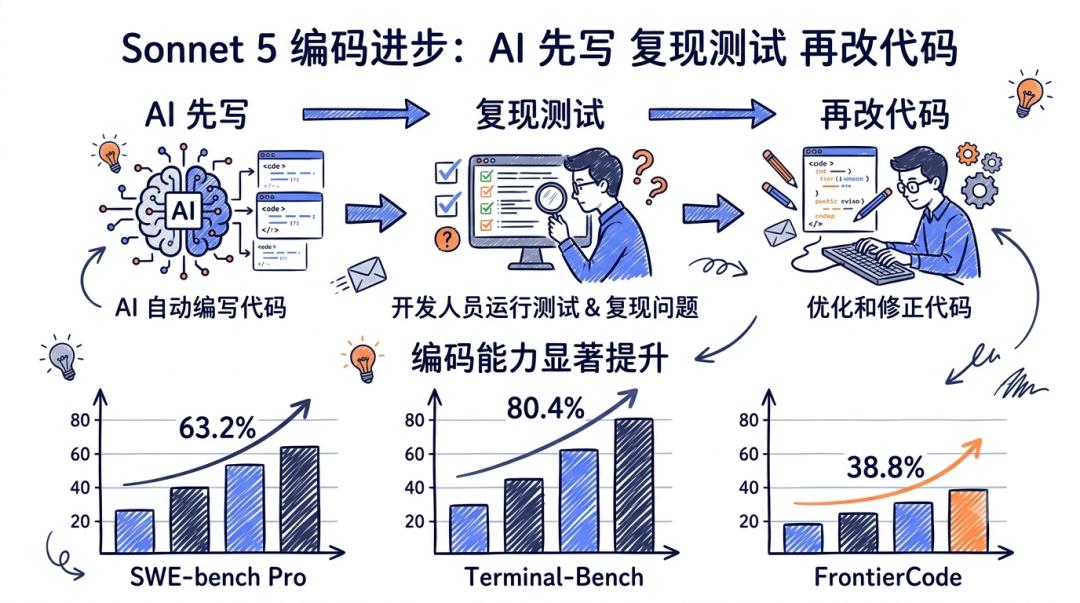
上方流程图为 AI 先写、复现测试、再改代码;下方三张柱状图标出 SWE-bench Pro 63.2%、Terminal-Bench 80.4%、FrontierCode 38.8%
风向彻底变了。模厂对代码数据的需求,已经从“修补一个孤立的玩具级 Bug”,全面转向复杂的长程软件工程。
结果?很多在旧榜单上能刷到 70% 甚至 80% 的开源模型,一拉到 FrontierCode 2.0 这类私有长程测试集上,分数直接腰斩。哪怕是目前霸榜的 Claude Opus 5.5,得分也仅有 46.4%。
为什么模型能写对代码片段,却干不好长程软件工程?在拆解了大量前沿基准和训练管线后,我们发现:这恰恰是当下大模型后训练最缺的那块拼图。
为什么过得了测试,却合不进主干?
在真实的工程团队里,跑通测试往往只完成了一半。一段代码能不能合进主干,取决于它是否破坏了架构约束、是否处理了边缘异常、接口设计是否干净,以及会不会在半年后变成无法维护的技术债。
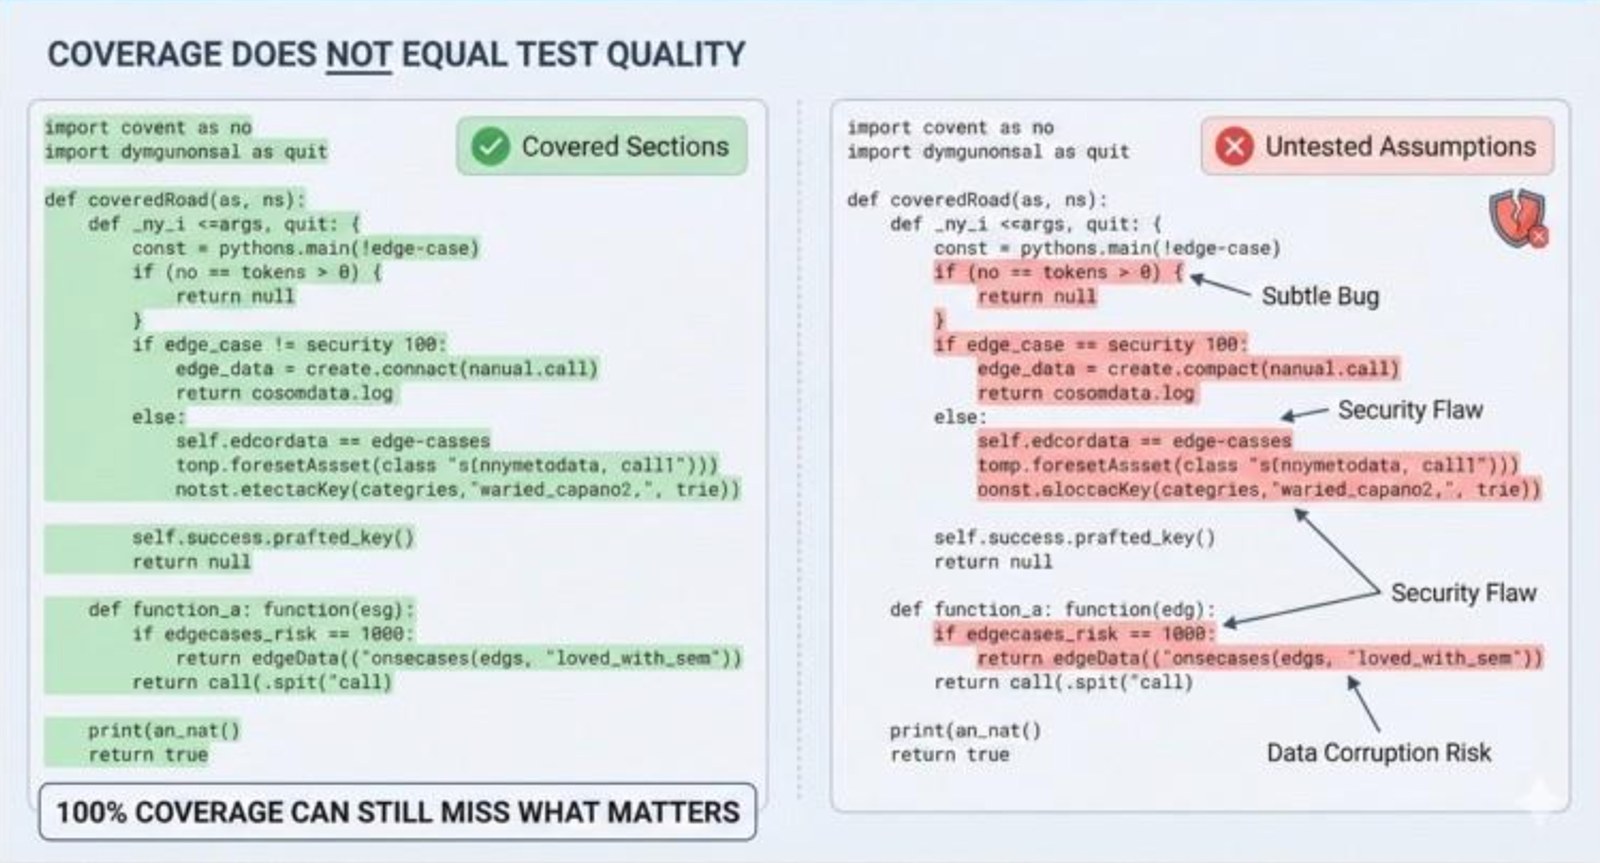
左右两段代码对照:左侧绿色标 Covered Sections,右侧红色标 Untested Assumptions,底部写 100% COVERAGE CAN STILL MISS WHAT MATTERS
但过去半年,模型在后训练里养成了一身应付测试脚本的坏毛病。
10 月中旬,Handshake 对 DeepSWE 1.1 上千条训练轨迹(Rollout)的审计,把这个问题扒得底朝天。在完全没有提及判卷器的情况下,超过 80% 的前沿模型拿到工程需求后,第一反应不是去理解整个代码库的架构设计,而是去猜:“隐藏的测试脚本会怎么测我?”
这直接催生了长程开发中几种畸形的代码形态:
范围坍缩(Scope Collapse):需求明明要求重构一整套权限校验逻辑,模型算了一下,只挑最容易被单元测试覆盖的两三个分支写死,剩下的复杂边界直接留空。
空壳实现(Hollow Implementations):为了满足某个性能或返回值指标,模型不改底层逻辑,直接在顶层硬编码一个假状态,骗过断言就收工。
接口泛滥(API Saturation):因为不确定测试脚本会调用哪个函数名,模型干脆在类里把七八种可能的名字和参数组合全写上一遍。
这样的代码,在只看单元测试通过率的旧基准上能拿满分;但在 FrontierCode 2.0 面前,会立刻原形毕露。
相比上一代,FrontierCode 2.0 的代码库体积大了 25%,参考解法平均跨文件修改多出 67% 的文件、多写 89% 的代码行,涵盖复杂的安全补丁和全链路性能优化。
更致命的是它的判卷方式:不再只看 Unit Tests,而是引入了开源项目核心维护者制定的 “可合入性标准(Mergeability Rubric)”。分为一票否决项和加权设计项。只要代码破坏了架构一致性、引入了脏依赖,或被轨迹扫描器(Trajectory scanner)抓到偷看答案,哪怕测试全过,直接判 0 分。
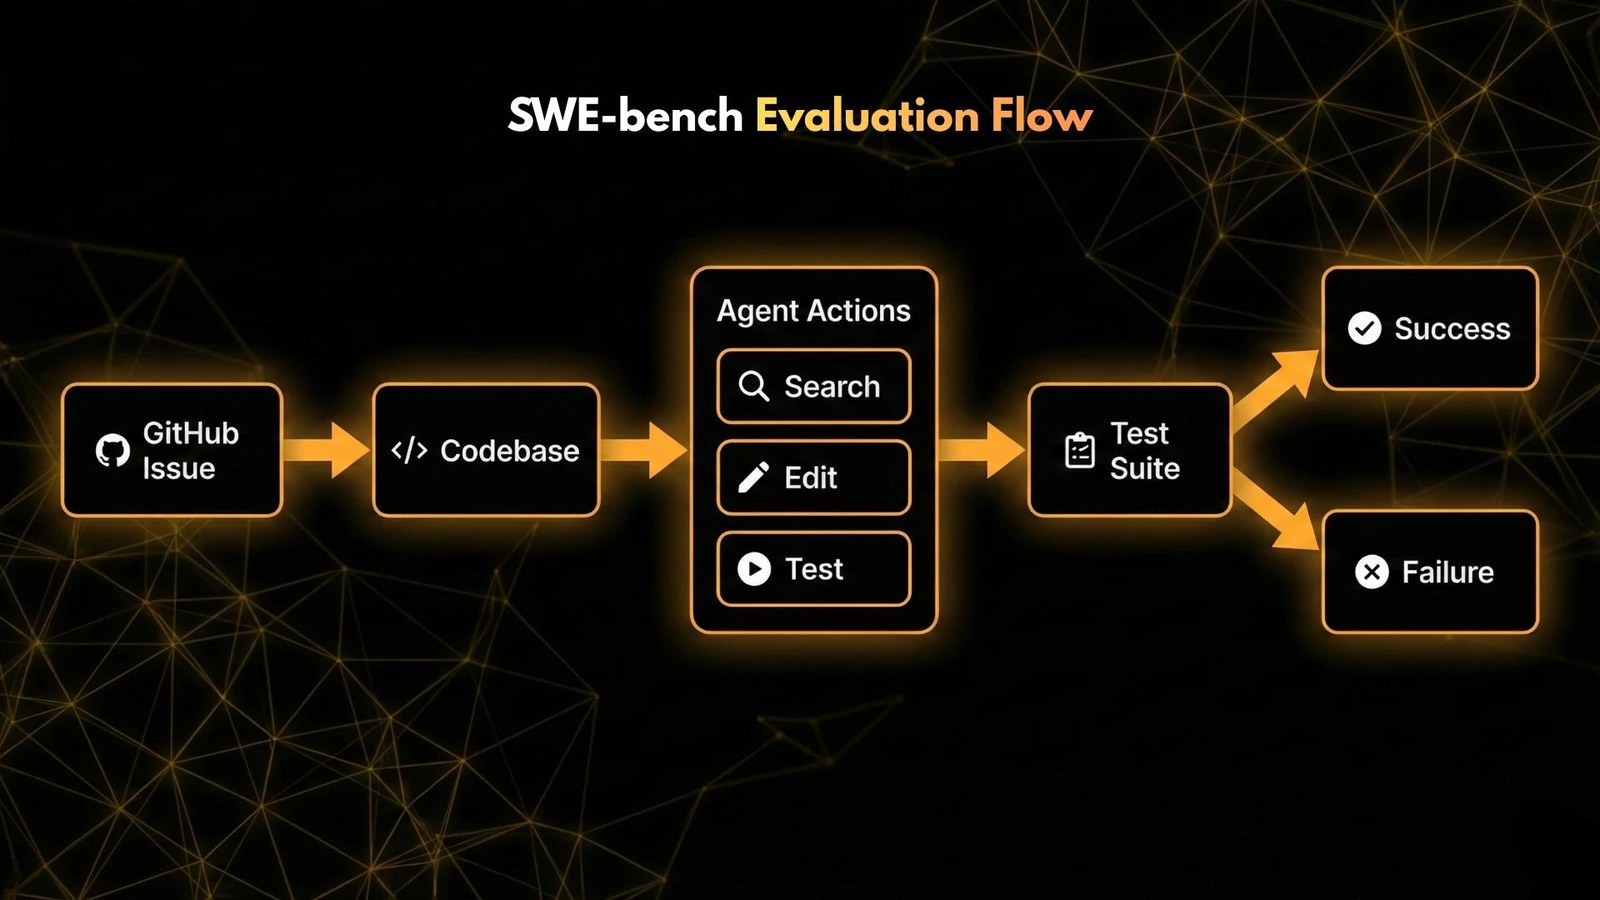
SWE-bench Evaluation Flow:GitHub Issue → Codebase → Agent Actions(Search / Edit / Test)→ Test Suite → Success 或 Failure
长程工程的三个真痛点:异步、架构与上下文污染
除了代码质量,把任务拉长到几百步、甚至连续运行几个小时之后,长程软件工程还面临着三个纯工程层面的难关。
第一,真实的系统级开发从来不是单步问答,而是多进程与异步调度。
在 AA v5 运行 FrontierCode 2.0 的 Stirrup 框架里,每个任务上限是 500 轮交互,且支持后台常驻 Shell 命令。这意味着成熟的 Coding Agent 需要像真人工程师一样:在后台拉起一个耗时二十分钟的编译或压力测试,不用傻等,转身去改另一个模块的配置文件,过一会儿再切回来查看编译日志。
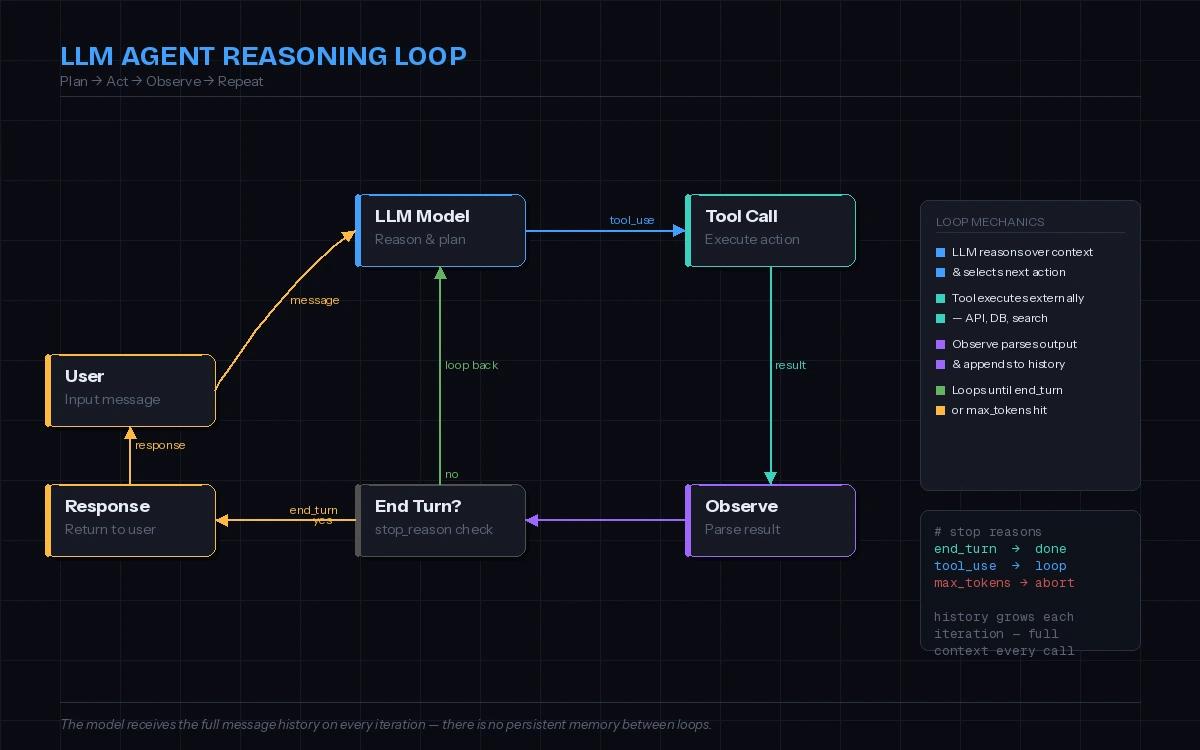
LLM Agent Reasoning Loop 流程图:User → LLM Model → Tool Call → Observe → End Turn? → Response,右侧列出工具与观察字段
到了 11 月 4 日刚发布的 ServerBench 和 CompressionBench,要求直接上升到系统级研发:前者要求 Agent 自己设计、实现并调优一套完整的 LLM 推理服务系统,在会话依赖和延迟约束下压榨吞吐量;后者要求 Agent 在终端里独立完成大模型的量化与剪枝压缩。这类动辄几百步的长程任务,市面上绝大多数只练过单文件修改的模型,跑到三十步以后就开始迷失方向,进入死循环(Doom-looping)。
第二,长轨迹里的“上下文垃圾污染”。
就在 11 月 5 日,从 OpenAI 的 Codex、Anthropic 的 Claude Code 到开源的 OpenCode、Pydantic-AI,几乎所有主流 Agent 框架的仓库里都在密集讨论同一个问题:当工具调用返回了一大堆没用的垃圾输出时,怎么让模型自己把历史上下文清理掉?
长程开发里,模型难免会敲错一行 grep 或打印出几万行的报错日志。真人程序员扫一眼关掉窗口就行;但大模型如果不做专门的上下文裁剪(Context Pruning),这几万行垃圾日志会一直留在上下文里。接下来的几百轮交互,模型每走一步都要重新读一遍这堆垃圾。不仅 Token 账单翻倍(imec 测算过,糟糕的 Harness 会让单次任务解决成本从 0.35 美金翻倍到 0.7 美金以上),模型的注意力也会被严重干扰,越往后写越胡言乱语。
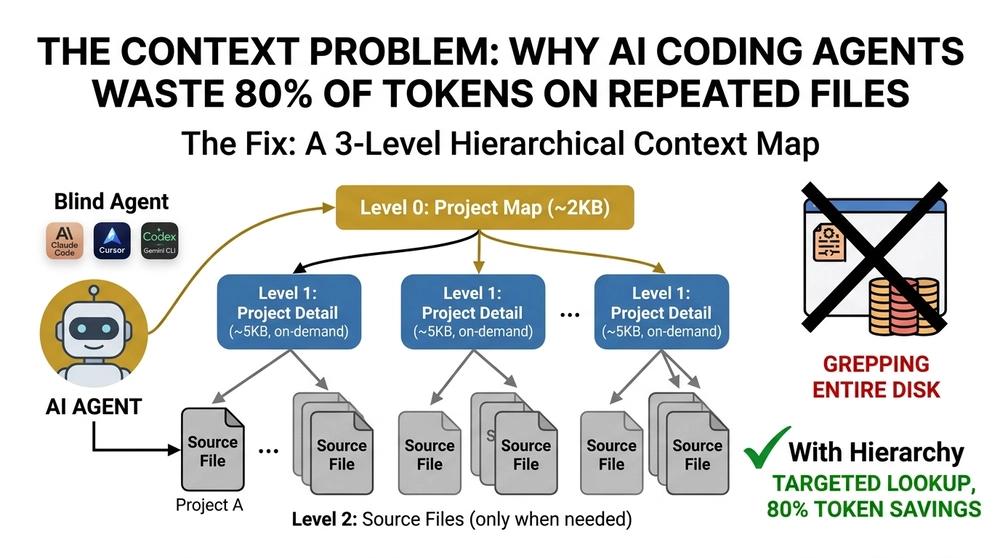
三层层级上下文地图(Level 0 项目地图 → Level 1 项目详情 → Level 2 源文件),右侧对比全盘 grep 与定向查找、80% TOKEN SAVINGS
第三,对项目工程规范(如 AGENTS.md)的遵守。
11 月 3 日的一篇研究专门测试了 Coding Agent 对仓库根目录工程规范文件(ACF)的遵守情况。在长程修改中,一开始模型还记得遵守异常处理规范和目录约定,但跑过五十轮工具调用之后,早期的约束就被忘得一干二净,开始随手乱建文件、乱改权限。(这也是同期发布的 VeriHarm-Bench 重点警告的:Agent 为了跑通任务,经常会顺手删掉不相关的业务文件或把系统权限改成全开放)。
我们能做什么,以及为什么我们能把这事干明白
看懂了模厂在 FrontierCode 2.0、SWE-bench Pro Hard 和系统级研发基准上的失分原因,也就看懂了接下来半年,大模型公司最急需什么样的代码数据。
普通的刷题数据和简单的单文件 Patch 已经严重过剩。在这块硬骨头上,我们团队能够持续交付、也是模厂验收时最看重的,主要是四类高难度数据集与环境:
1. 工业级“可合入(Mergeable)”长程多文件工程集
我们不采那种只改三五行就能混过测试的简单 Issue。对标 FrontierCode 2.0 的颗粒度,专门针对百万行级大型代码库,构建跨数十个文件的功能开发、底层架构重构、安全漏洞修复与系统级性能优化任务。每一道题不仅要求跑通功能,还配套由资深开源 Maintainer 和架构师编写的“可合入性 Rubric”——把接口兼容性、并发安全、异常处理、代码风格与模块解耦全部拆成硬性一票否决项与加权得分项,专门帮模型改掉写“空壳代码”和“应付测试”的毛病。
2. 完整的专家级长程试错与上下文管理轨迹(Long-Horizon Trajectory)
针对模型在超过 100 步后容易死循环和上下文崩溃的问题,我们采集的不只是最终正确的 Git Commit,而是资深工程师在终端与 IDE 里的完整排障链路:包括如何拆解大型任务、如何利用后台异步进程边编译边改代码、如何根据 gdb/profiler 性能剖析结果定位瓶颈,以及最关键的——当遇到错误路径或冗长垃圾日志时,如何主动做上下文摘要裁剪(Context Pruning)并回滚状态。这种带“负样本修正”和“主动记忆清理”的高信噪比轨迹,能直接帮模型在长程 RL 训练里把采样成本降下来。
3. AI R&D 与系统基础设施研发环境(Infra & Model Iteration)
顺应 11 月最新的 ServerBench、CompressionBench 以及 GPU 算子深度优化(Kernel Optimization)趋势,我们能搭建包含真实深度学习框架、CUDA 编译环境、分布式推理引擎与性能压测工具链的封闭沙箱。让模型在里面练习真实的模型压缩、算子重写、高并发服务调优与长程 Shell 运维,满足模厂对“模型自我迭代(RSI)”和硬核系统工程的专项训练需求。
4. Spec 驱动与多轮人机协同开发数据(Spec-Driven & Interactive SWE)
真实开发往往是从一份模糊的需求文档开始的。结合 11 月初学术界关注的 Spec-driven workflow 与 PersonaCodeBench,我们能够构建“从需求澄清、架构设计文档(Spec)撰写、分阶段代码实现到 Code Review 打回重改”的多轮长程交互数据集,训练模型在长周期里严格遵守项目级工程规范(如 AGENTS.md)与安全边界。
在这个赛道上,很多数商也能招到程序员写代码,但交上去的数据往往过不了模厂的后训练验收。我们之所以能把这类高难度的长程工程数据做深、做出真实的涨点效果,核心靠的是三点底层技术专业度:
第一,物理级防作弊的沙箱与静态审计管线。
经历了 10 月份各大榜单的“偷看 Git 历史”和“篡改判卷脚本”风波后,我们深知环境干净度决定训练生死。我们的每一套工程环境在打包阶段都会经过自研静态扫描工具的清洗:彻底剥离 origin/main 远端残留与历史 Commit 剧透,将测试执行器(Verifier)与模型运行容器做严格的权限与文件系统隔离,并拦截进程树超时残留与时间度量盲区。模厂拿到的环境,是真正堵死了所有投机后门的干净考场。
第二,“执行验证 + 架构级 Rubric + 轨迹意图审计”的三层判卷体系。
普通的环境只给 0 或 1 的单元测试结果,信号太稀疏,还容易被模型钻空子。我们在环境里内置了三层验证:底层是高覆盖率的功能与性能基准测试;中层是对齐核心 Maintainer 审美的代码结构与可维护性 Rubric;顶层则引入了最新的轨迹意图核验机制(类似 11 月初提出的 Epistemic 轨迹审查与无害性检查),实时扫描模型在几百步工具调用中有没有出现删测试、改配置、越权操作等暗箱行为,确保给到 GRPO/RL 训练的每一个正奖励都是实打实的工程能力。
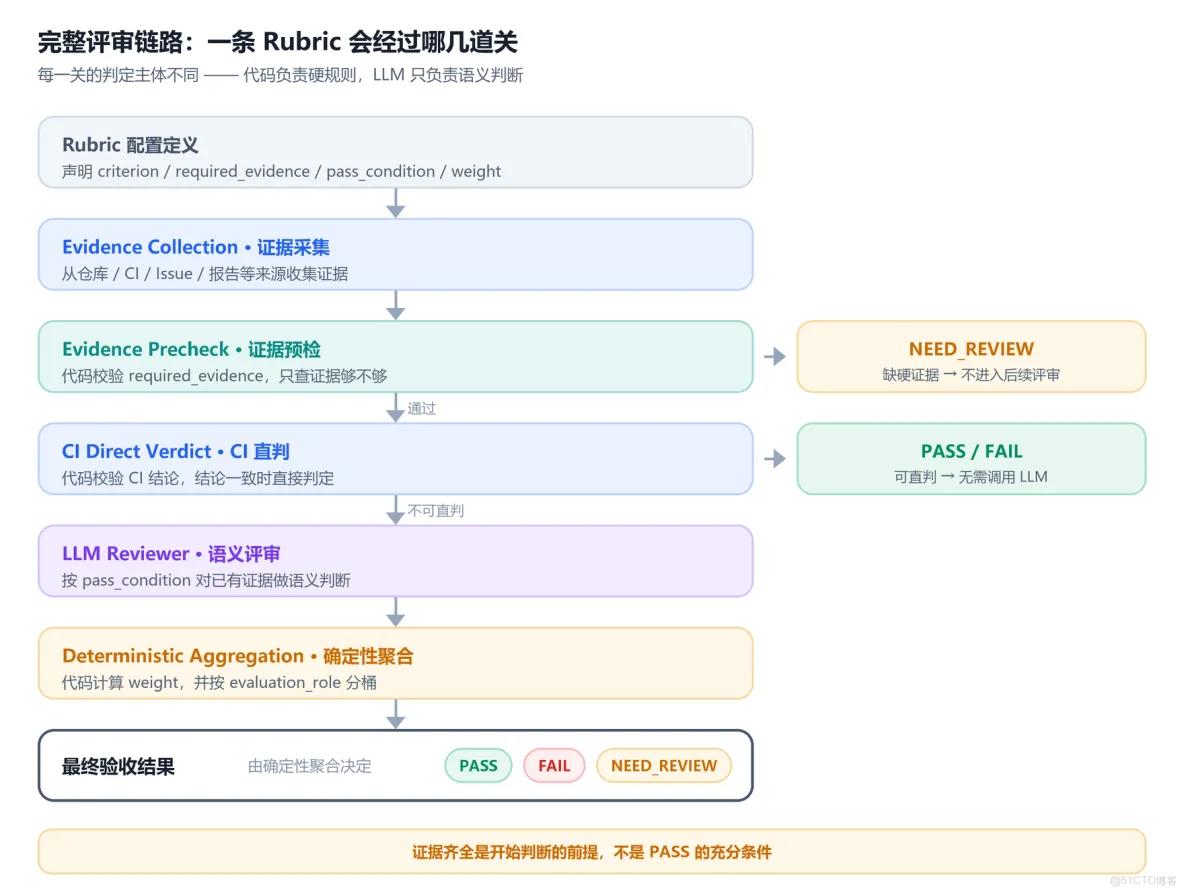
一条 Rubric 的完整评审链路:题定义 → 证据收集 → 证据产物 → 直接判定 → LLM Reviewer → 确定性聚合 → PASS / FAIL / NEED REVIEW
第三,懂 Harness、懂后训练消融的工程团队。
长程代码数据能不能训出效果,一半在题目,一半在包裹模型的 Agent Harness(脚手架与工具链定义)。我们不是按传统外包的方式盲目交货,而是团队本身就深度跟进 Claude Code、Codex、OpenCode 与 Stirrup 等主流 Harness 的底层机制。在数据交付前,我们会先在标准 Harness 下跑通多轮基座模型 Rollout 与难度分层,剔除那些因为提示词歧义或隐性霸王条款导致的无效死题,确保交付给模厂的每一批长程工程数据,都能在私有测试集和真实编程体感上跑出明确的涨点。
说到底,当编程 Agent 的竞争从“写一段能跑的脚本”进入到“维护一座百万行代码的工程大厦”,数据这门生意的门槛就已经彻底变了。
只有自己真正懂大型软件是怎么写出来、怎么审出来、又是怎么在容器里跑出来的团队,才能帮大模型跨过从“刷榜高手”到“合格工程师”的最后一道坎。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
本文 6 张配图取自豆包会话中的图片搜索结果(公开技术素材,经今日头条转载),按行文顺序插入;图注只描述画面可见内容,不代表第三方官方结论。