具身智能的“数据工厂”算账时刻:几百人戴着 VR 抓杯子,为什么还是训不出一个能干活的机器人?
DataMining · 2026年11月7日
2026 年下半年,具身智能行业最热闹的地方,不是轰鸣的制造车间,而是各地挂牌成立的“数据采集中心”。
几千平米的厂房里,几十上百台双臂机器人排成方阵。采集员戴着 VR 头显、握着动捕手柄,一天八个小时重复着同一个动作:抓起桌上的杯子、叠好毛巾、把零件塞进塑料框。
在 11 月初的乌镇世界互联网大会上,京东集团技术委员会主席曹鹏给出了一个相当诚实的评估:如果通用具身智能的满分是 10 分,今天整个行业大概只在 3 到 4 分的水平。与此同时,他还宣布未来两年要构建千万小时级别的数据集。
硬件出货的数字看着很热闹,但去向经不起细拆。市场研究机构 Counterpoint 的数据显示,2026 年上半年全球人形机器人出货量虽然暴涨近 300%,但真正进入智能制造和物流场景的,加起来不到两成。剩下的六成以上,全被文娱商演、科研教育,以及数据采集吃掉了。
说白了,大量昂贵的真机被买回去,其实是进了采集场,给下一代模型当“录像机”。
但算法团队很快发现了一个让人头疼的事实:哪怕在采集场里攒够了上万小时的遥操作视频,模型一旦离开那张铺着特定颜色桌布的实验台——换个光照、换个材质软一点的纸杯,或者旁边有人不小心推了一下收纳盒,它的抓取成功率就会断崖式下跌。
几百号人日夜不停地戴着 VR 抓杯子,为什么就是喂不出一个能干活的通用模型?
我们不妨来算算这笔账。
0101 物理账与经济账:一场“左手倒右手”的数字游戏
文本大模型的预训练,爬的是互联网上现成的网页,边际成本几乎为零。但在物理世界里,没有现成的关节力矩和空间轨迹可以白嫖。每一秒真机数据,都得靠人力和硬件在真实时间里硬磨出来。
这个“磨”的过程,损耗率高得吓人。根据一线调查,在主流的一对一物理遥操作模式下,算上设备调试、电机过热保护、机械故障恢复,以及每次抓完后人工把桌面物品摆回原位的时间,一个熟练采集员忙活 1 小时,最终能落盘的有效轨迹数据往往不到 30 分钟。
更麻烦的是“本体差异”。Google 牵头做 Open X-Embodiment 数据集时就撞过这堵墙:22 种不同构型的机器人,轴数、连杆长度、相机角度、控制频率全都不一样。在 A 厂家的双臂平台上花几千万采出来的关节轨迹,直接拿到 B 厂家的七自由度机械臂上,连坐标系都对不齐。
国内动捕设备商诺亦腾在 2026 年的复盘里也直言:当前行业最大的消耗,就在于“一机一采”,生产了大量无法互通的数据孤岛。
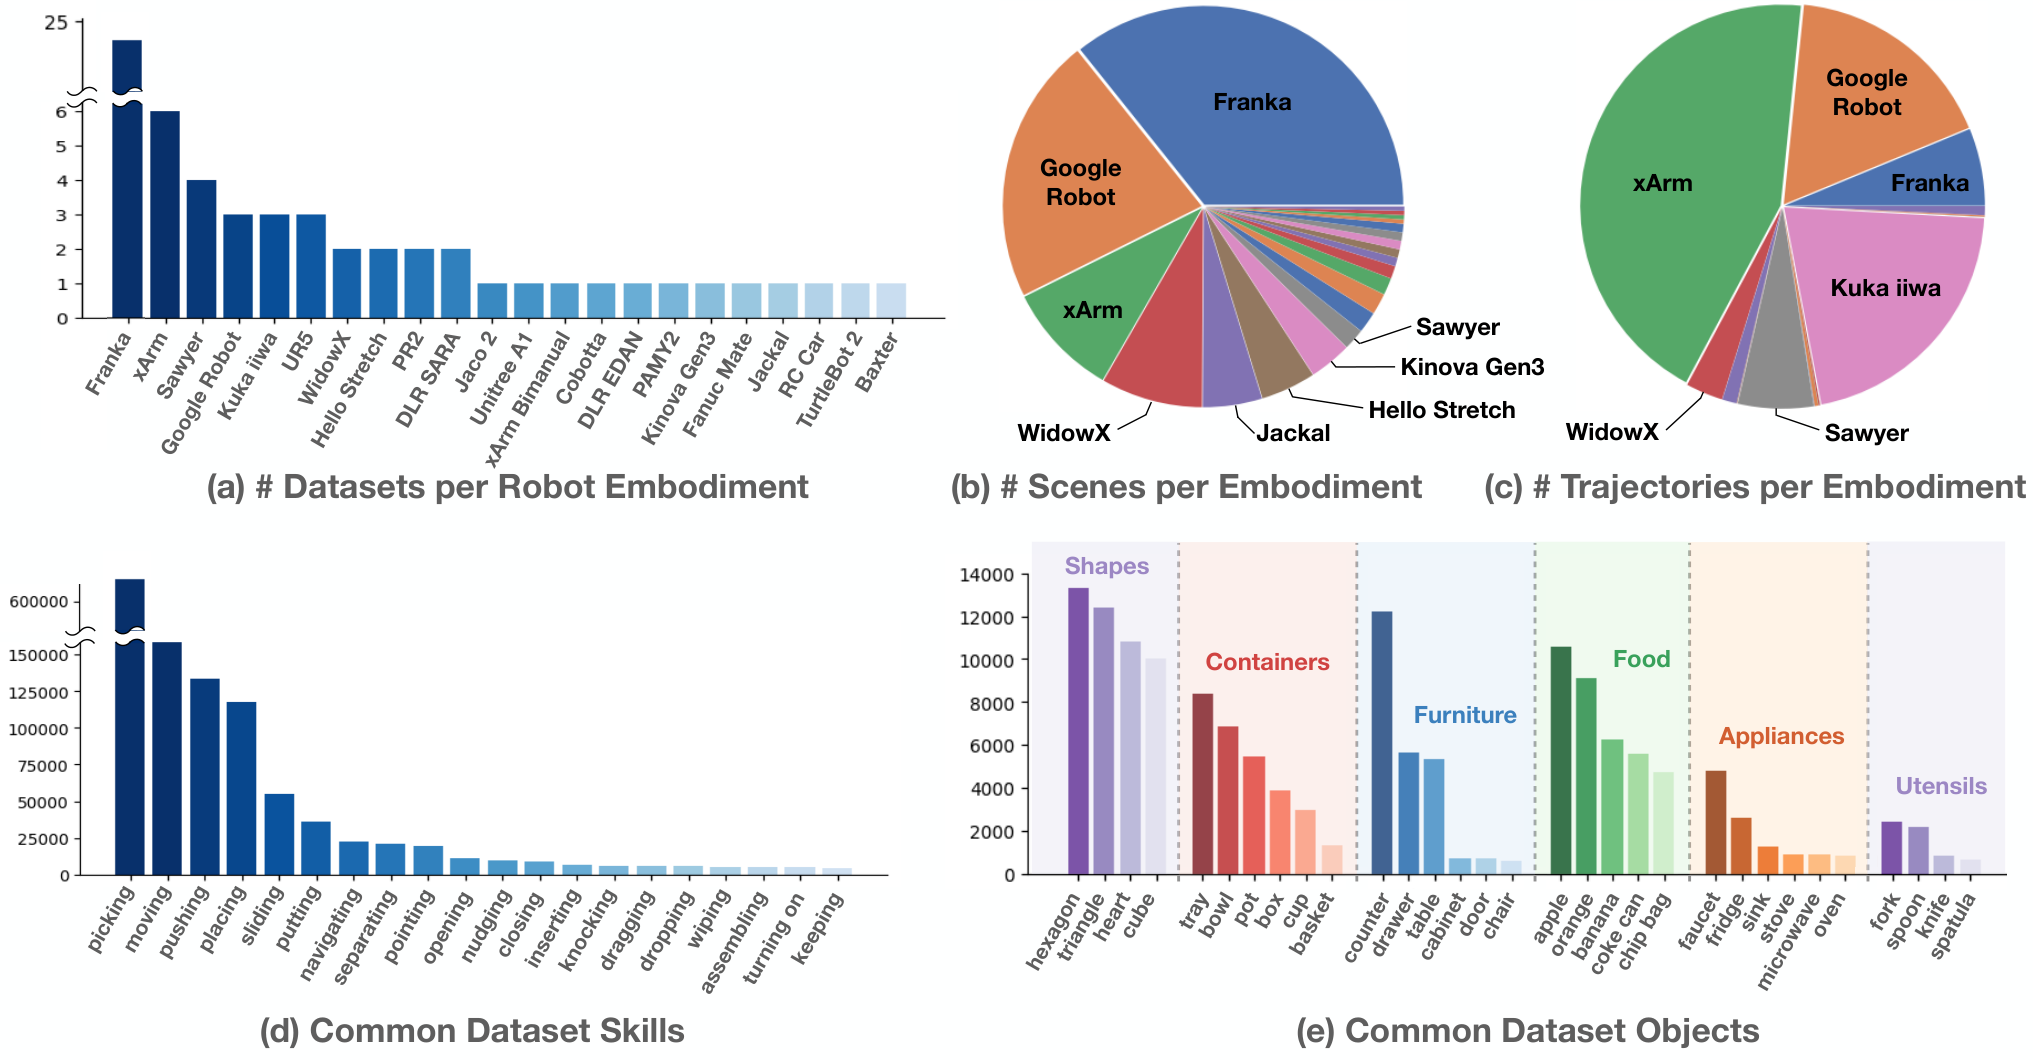
既然真机遥操作这么贵、损耗这么大、跨本体又这么难,为什么过去一年各地还在疯狂上马几百台规模的数采基地?
因为这里面,有一笔脱离了模型效果的“财务账”。
部分企业联合地方平台成立所谓的数据中心,先把自家的机器人高价卖给数据中心,确认一笔硬件收入;再由数据中心把采出来的轨迹数据,卖回给机器人公司或者关联方。
某头部人形机器人公司的招股书曾披露,其全尺寸机器人销售收入中,约 45% 来自数据采集业务,而真正来自工业制造场景的收入占比仅为 3.88%。
当“采集数据”本身成了消化硬件产能和刷高营收流水的手段,考核指标自然就变成了:今天开机了多少小时?落盘了多少万条轨迹?至于这几万条抓杯子的轨迹里,到底有没有模型真正缺少的物理信息,反倒没人深究了。
直到 2026 年下半年,随着开源社区放出大量免费的高质量人类操作数据集,市面上按小时计价的同质化动作轨迹单价被迅速打穿,这笔靠“堆人头凑时长”的账,才开始算不下去了。
0202 技术硬伤一:丢了物理交互的灵魂,模型成了“空间盲人”
抛开商业泡沫,单看技术本身:为什么纯靠 VR 头显和视觉摄像头录下来的数据,训不出泛化性?
最直接的原因,是这些数据从源头上就丢掉了物理交互最核心的维度:力觉与精确的空间对齐。
人类戴着 VR 手柄控制机械臂去抓一个塑料杯,眼睛盯着屏幕,手腕凭经验停在杯子边缘。这时候落盘的数据只有两样:摄像头的 RGB 画面,以及机械臂各个关节的位置指令。这里面唯独没有手指接触杯壁那一瞬间的力觉分布、微小滑动和形变反馈。
在实验室里抓硬质木块,靠纯视觉对准也许够了。但一进真实商业场景,全是高密度的接触任务。
2026 年 8 月,一家名为 Sharpa(夏帕)的独角兽企业在上海落地了全球首个零改造的机器人暴风雪冰淇淋商业工位。要做出一杯合格的暴风雪,机器人必须连续执行 55 个动作步骤。
现场拆解显示,这 55 个步骤里有 98% 直接依赖触觉反馈:从紧套的纸杯塔里单抽出一只软纸杯而不捏瘪它,到根据机身震动实时微调握持力,再到最后翻转 180 度做“倒杯不洒”测试。
Sharpa 能跑通,前提是它的灵巧手在每个指尖塞进了上千个触觉传感单元,把接触力信号死死写进了控制回路。
反观大多数外包数据工厂,为了降低成本,清一色使用没有触觉阵列的两指平行夹爪,或者只记录无反馈的关节位置。
模型在这样的数据集上训得越久,就越像一个只看录像带学木工的学徒——它记住了手移动到哪个像素坐标该合拢,但一旦换了一个表面摩擦系数不同、或者重量多出 50 克的杯子,它根本不知道该用多大的力气去维持静摩擦。
除了缺少力学维度,当前主流的 VLA(视觉-语言-动作)模型还普遍卡在“空间接地(Spatial Grounding)”的精度上。
多模态大模型天然是个“空间盲人”。它能看懂画面里有一只马克杯和一把夹爪,却算不准夹爪指尖离杯柄还有几毫米;更搞不清当机械臂手腕旋转 30 度并挡住一半视线时,目标物体的边界去了哪里。
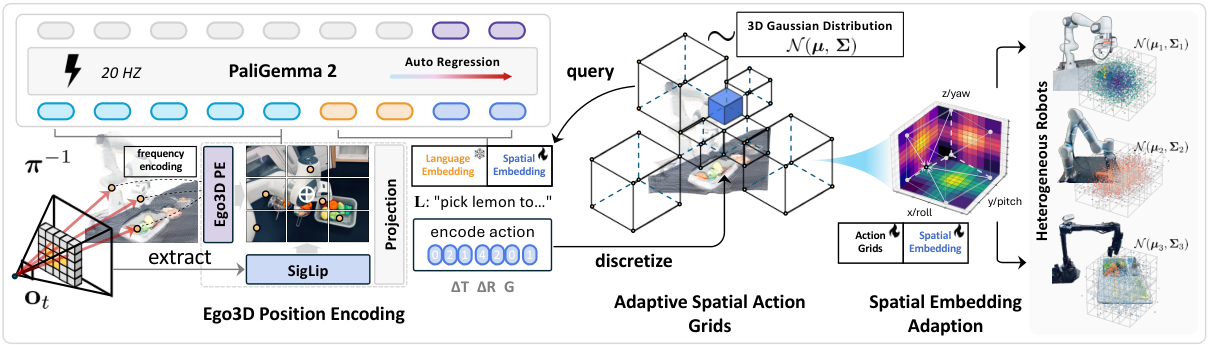
在实际工程交付中,我们发现直接把原始遥操作视频扔进模型,模型学到的往往是背景纹理的虚假关联。为了解决这个问题,国内头部具身厂商在与 DataMining 合作时,已经不再采购粗放的原始录像,而是专门定制真机场景下的 Grounding QA 与像素级目标标注。
具体做法是:在真实的机械臂作业画面上,把目标物体的二维坐标、边界框(BBox)、场景语义描述,与机械臂自身的关节状态以及下一步的运动趋势显式绑定,做成经过多模型交叉验证的问答对。
在末端夹爪即将接触物体、发生严重自遮挡的关键帧上,必须对目标物体做像素级的掩码(Mask)标注,并引入双盲专家复核。
只有先把“看懂像素”和“算准三维物理空间”这层窗户纸捅破,后面的动作策略网络才不会在手腕一转的时候直接抓了个寂寞。
0303 技术硬伤二:模仿学习的“温室效应”与复合误差
即便补齐了视觉空间定位和传感器维度,传统数据工厂的采集逻辑还有一个更致命的算法硬伤:模仿学习的复合误差(Compounding Error)。
这是机器学习领域早在 2011 年就被严格证明过的定理。在行为克隆(Behavior Cloning)框架下,如果训练数据里全都是采集员顺顺利利把杯子抓起来的“完美通关视频”,那么模型单步预测的微小误差,会在连续执行的过程中随时间呈指数级累积。
道理非常朴素。采集员都是熟手,录数据时手总是稳稳地沿着最优路径走,几乎不会把杯子碰倒,也不会在走廊转弯时撞上墙角。这就导致训练出来的模型,一辈子只见过处于“正确轨道”上的画面,成了名副其实的“顺风局战神”。
一旦到了真机闭环测试阶段,地面稍微有一点打滑,或者光线变化导致第 10 帧的动作偏了 2 毫米,到了第 20 帧,机械臂所处的位置就已经偏离了完美轨迹。这时候,摄像头拍到的画面变成了一个训练集中从未出现过的“分布外状态(Out-of-Distribution)”。
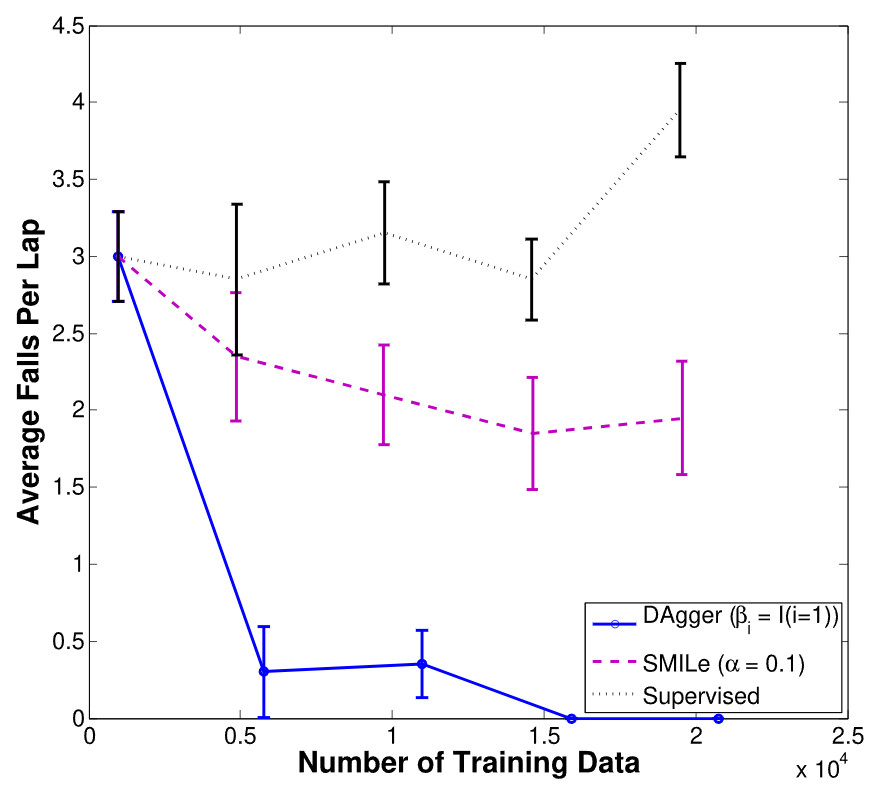
因为人类采集员从来没有在这个跑偏的位置示范过“怎么往回救”,模型瞬间就不知所措了,紧接着做出更离谱的动作,直到把整张桌子的东西全扫到地上。
几千小时的完美轨迹,在真机测试时的信息密度其实低得惊人。第 500 个小时采到的平滑抓杯子动作,和第 1 个小时采到的动作,提供的梯度信息几乎是完全重叠的。
当年的解法叫 DAgger(Dataset Aggregation):先让还不成熟的模型自己上场跑,跑偏了、快要撞上了,再由人类专家介入,专门把“从跑偏状态拉回正常轨道”的纠偏过程记录下来,并塞进训练集里迭代。
这套逻辑现在正成为具身智能后训练数据采购的核心分水岭。以 DataMining 为国内某高校具身实验室交付的具身导航数据为例,团队没有去堆砌海量走直线的冗余样本,而是把工作拆成了两步:第一步用多模态空间感知任务做监督微调(SFT),打通基础感知;
第二步直接切入具身导航 DAgger 后训练数据建设,专门针对机器人在复杂环境里走偏、遇到动态障碍物卡死等边缘状态,采集“从偏离姿态重新恢复到正确路径”的干预轨迹。
模型学会怎么把杯子抓起来只需要几百条示范,但学会在杯子滑落、手腕撞歪的那半秒钟里怎么调整姿态救回来,靠的是专门设计的“救场数据”,而不是让采集员在温室里再重复抓一万次。
0404 替代方案的算账:手持夹爪与世界模型,捷径也有坑
到了 2026 年底,业内其实已经看清了传统 VR 真机数采工厂的死胡同。为了绕开真机昂贵、缓慢、难以跨本体的限制,学术界和产业界正在猛攻两条替代路线:一条是完全脱离机器人的“手持夹爪采集”,另一条是靠“世界动作模型(World Action Models)”在脑子里生成未来。
但这两种新方案,各自都有一本还没算平的硬账。
先看手持夹爪路线。
2026 年下半年,基于手持灵巧操作采集系统(如 YUBI 及后续的 AIRoA-0)的方案大火。AIRoA-0 做了一件很极端的事:它用纯手持夹爪录制的 1.6 万小时双臂演示数据做预训练,全流程没有用到哪怕一秒钟的真机数据。
在 10 项高难度长程任务上,它取得了 78% 的平均成功率,而同场测试的四个主流 VLA 模型最高只有 27%。更关键的是,同一套模型权重可以直接零修改部署在不同构型的机械臂上。
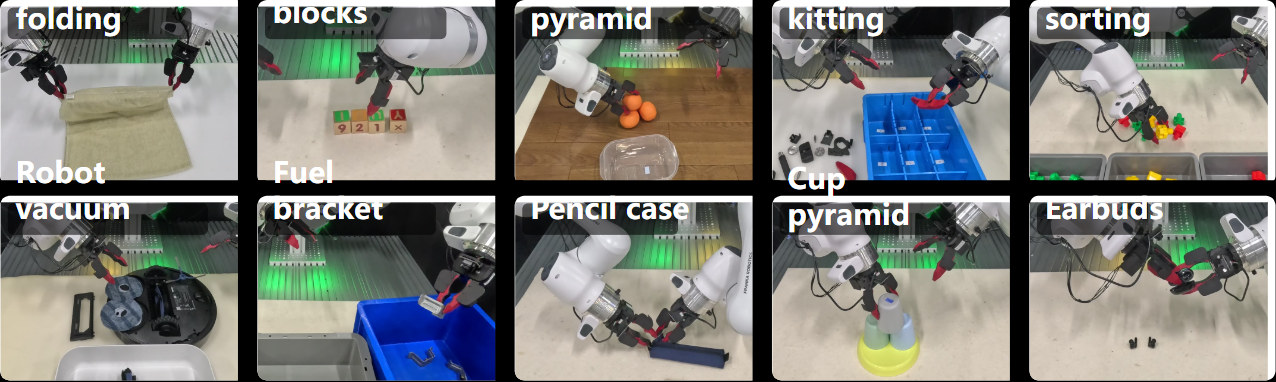
手持路线之所以能跑通跨本体,窍门在于它把状态和动作空间死死锚定在了那把夹爪以及两个腕部相机上。但它的物理边界也恰恰锁死在这里:所有要部署的机器人,末端必须安装和采集时一模一样的那把夹爪。
一旦下游客户用的是五指高自由度灵巧手,或者任务需要利用机械臂肘部、全身协同发力去搬运重物,手持夹爪省掉的动力学标定账,立刻就得连本带利还回去。
再看另一条被寄予厚望的“世界模型”路线。
既然真机采得慢,能不能让模型一边预测动作,一边像视频生成模型一样在脑海里推演接下来的画面?2026 年 9 月底,一项针对世界动作模型(WAM)的深度研究戳破了它在真机执行时的核心痛点:模型脑补出来的未来画面,经常带有严重的“乐观幻觉”。
在机械臂还没有碰到物体的自由移动阶段,世界模型预测的画面和现实高度一致;但只要进入精细接触阶段(比如插拔卡扣、物体发生滑动),真实物理世界的摩擦和碰撞只要有一点点偏差,模型沿着固定步长继续盲目执行脑补出来的动作序列,就会立刻抓空甚至损坏硬件。
研究团队不得不专门训练了一个轻量级的“未来-现实一致性验证器”,在真机上实时比对模型想象的画面与摄像头拍到的真实画面,一旦发现物理接触跟脑补的对不上,立刻切断原计划重新规划,这才把真机成功率提升了 35%。
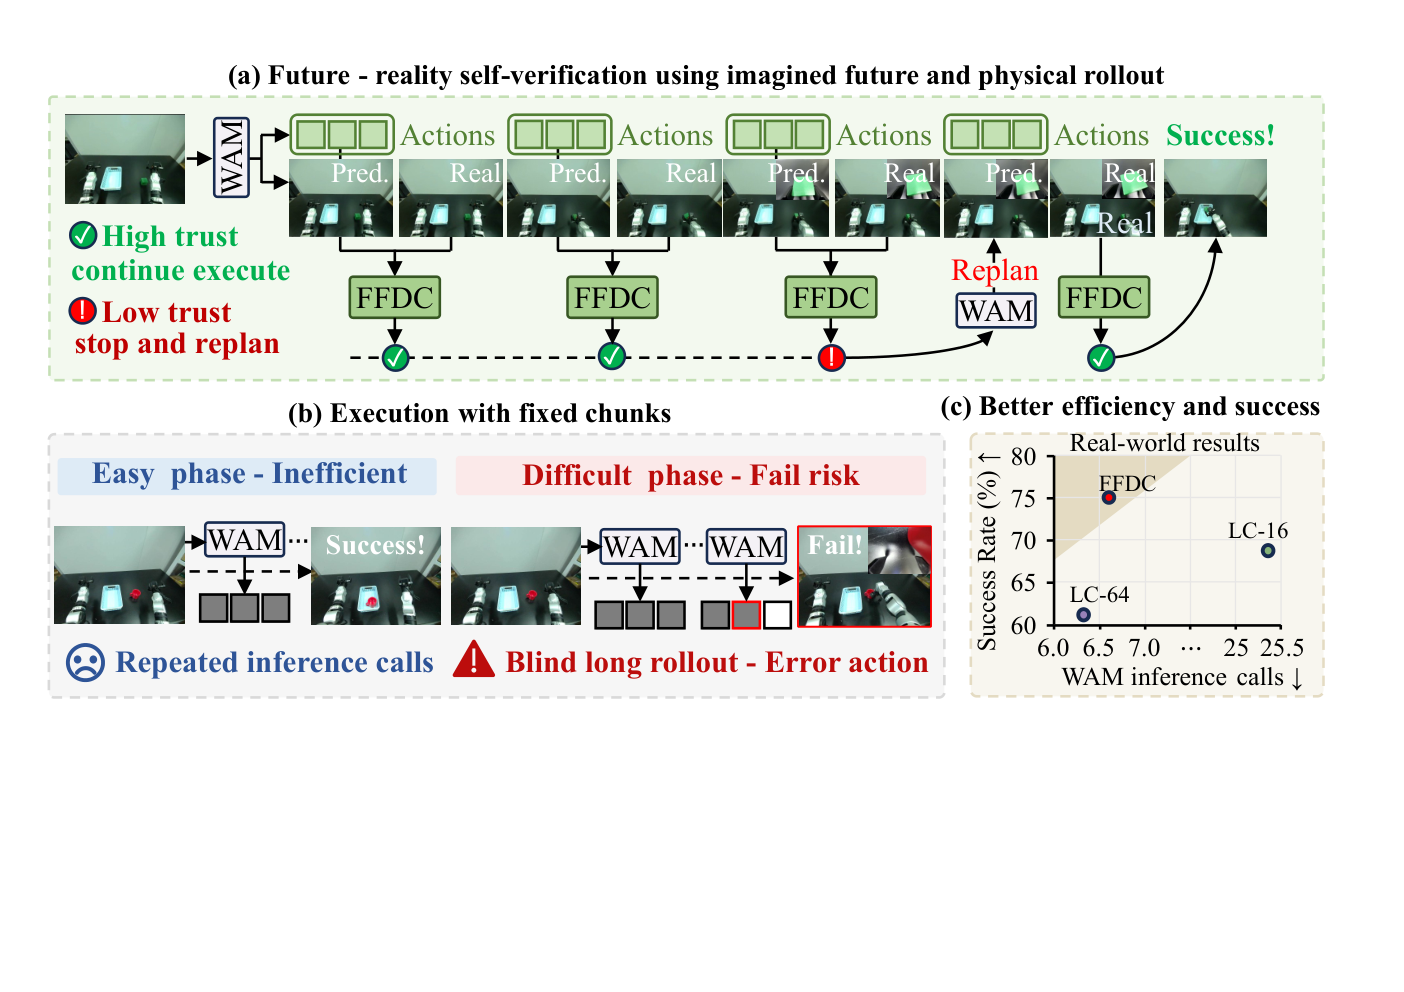
你看,不管是手持夹爪还是世界模型,最后都绕不开同一个结论:没有经过严格空间校验、没有接触物理对齐、没有失败恢复标注的“脏数据”和盲目轨迹,哪怕规模堆到几千万小时,也无法在真实物理世界里自动涌现出泛化能力。
0505 结语:别把“体力劳动录像”当成 AGI 的燃料
回过头看,具身智能行业之所以在 2025 到 2026 年扎堆建设千人规模的 VR 数采工厂,并不是因为从业者不懂复合误差,也不是不知道缺少触觉和空间对齐的后果。
这是资本周期、地方招商诉求与早期技术路线碰撞出的必然产物。对急需落地的硬件厂商来说,卖机器人给数采中心能最快兑现当期营收;对地方产业园来说,几百台机器人整齐划一地抓杯子,是最直观、最好验收的数字经济样板工程;
对早期算法团队来说,在还没想清楚怎么设计纠偏数据分布之前,先把采集时长从一千小时堆到十万小时,是向投资人证明自己拥有“数据壁垒”最省力的叙事。
但这里面藏着一个典型的古德哈特定律陷阱:当“采集小时数”从衡量模型能力的辅助参考,变成了融资、补贴和硬件销售的硬性考核指标,整个生产体系就会自动向最容易凑时长、最不容易出错的简单重复动作倾斜。
很多团队喜欢拿特斯拉 FSD 的数据飞轮来替自己的数采工厂辩护,却刻意忽略了两者在经济学结构上的根本差异。特斯拉的几百万辆量产车是消费者自己掏钱买回家开在路上的。
平时的正常驾驶根本不回传,只有当人类司机一脚刹车踩下去、或者猛打方向盘接管系统的那一瞬间——也就是模型预测与人类决策发生剧烈冲突的高价值分布外时刻——影子模式(Shadow Mode)才会触发数据回传。
它的边际硬件成本是零,且天然只筛出信息密度最高的“纠偏样本”。
而今天绝大多数具身智能数采工厂,干的是完全相反的事:自己花巨资买下还没有商业闭环的机器人,雇几百个全职工人,在高度受控的假房间里,从早到晚录制毫无意外的“岁月静好”。
具身智能的数据下半场,早就不是比谁的厂房面积大、谁雇的 VR 采集员多了。头部具身团队把预算从粗放的遥操作外包,转向高精度真机空间 Grounding 与 DAgger 纠偏后训练,是因为大家终于算明白了这笔账。
当开源社区已经能免费提供几万小时的基础抓取视频,如果一家数据工厂手里的几百万条轨迹,依然既没有亚毫米级的空间掩码对齐,也没有一次从失误边缘拉回来的纠偏记录,那堆在硬盘里的,究竟是通往通用人工智能的燃料,还是仅仅用昂贵算力和电费录下的一份人类体力劳动录像?
如果你所在的具身智能团队,正在推进 VLA 模型空间定位、复杂接触操作或室内外导航算法研发,正面临真机遥操作数据泛化差、自遮挡场景抓取失误或长程任务复合误差大等工程瓶颈,欢迎与 DataMining 交流。
DataMining 由北京大学计算机学院软件所博士团队创立,核心成员深耕多模态与大模型数据工程,已深度服务字节跳动、阿里巴巴、腾讯等头部科技企业及国内一线具身智能厂商与高校实验室。
在具身智能方向,我们不生产同质化的无效时长,专注于高信息密度的算法定制数据交付:
- 真机场景定制 Grounding QA:显式融合 2D 坐标、BBox、场景语义描述、本体感知与运动意识,经多模型交叉验证。
- 真机目标像素级 BBox/Mask 标注:针对手物交互遮挡场景引入双盲专家复核,严控毫米级空间对齐精度。
- 具身导航 SFT 与 DAgger 后训练纠偏数据集建设:协助模型团队用更少、更准的闭环数据,打穿真实物理场景的泛化瓶颈。
📚 配图来源
[1] Open X-Embodiment: Robotic Learning Datasets and RT-X Models,arXiv:2310.08864,Figure 1
[2] SpatialVLA: Exploring Spatial Representations for Visual-Language-Action Model,arXiv:2501.15830,Figure 2
[3] A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning,Ross 等,AISTATS 2011,arXiv:1011.0686,Figure 2
[4] AIRoA-0: Long-Horizon, Precise, Cross-Embodiment Manipulation from Handheld Data,arXiv:2611.03815,Figure 2
[5] When to Trust Imagination: Adaptive Action Execution for World Action Models,arXiv:2605.06222,Figure 1
以上 5 张均为论文公开原图,按行文顺序插入;图注只描述画面可见内容。