ALE 与全行业 Agent 终极评测:当模型离开考卷,坐进真实的工位
DataMining · 2026年11月9日
ALE 把考场搬进真实工位之后,卡住模型的往往不是智力,是许可证、弹窗和判卷脚本。
如果说 HLE(人类最后的考试)考的是大模型能不能在草稿纸上解出博士级的奥数和理论物理题,那伯克利 RDI 实验室(Dawn Song 团队)联合三百多位行业老手搞出来的 ALE(Agents' Last Exam,智能体最后的考试),
考的就是另一件事:把模型直接扔进一台装满真实工业软件和遗留代码的电脑里,给它五个小时,看它能不能把一个打工人一天的活干完。
今年下半年,这套测试成了硅谷和国内大厂买 Agent 数据时最爱提的参照系。道理很简单,现在的模型在单轮对话和小段代码测试里早就刷到头了,但真放到公司业务线上,经常连个集群故障都排不明白,或者在桌面软件里点错两个按钮就把流程卡死。
顺着伯克利刚迭代完的 ALE v1.1 官方技术报告,再结合我们一线交付 Coding 运维、CUA、科学计算、网络安全和金融法律环境时的真实内幕,你会发现:要想让模型在真实工位上干活,背后卡住全行业的,全是那些教科书上绝不会写的工程细节。
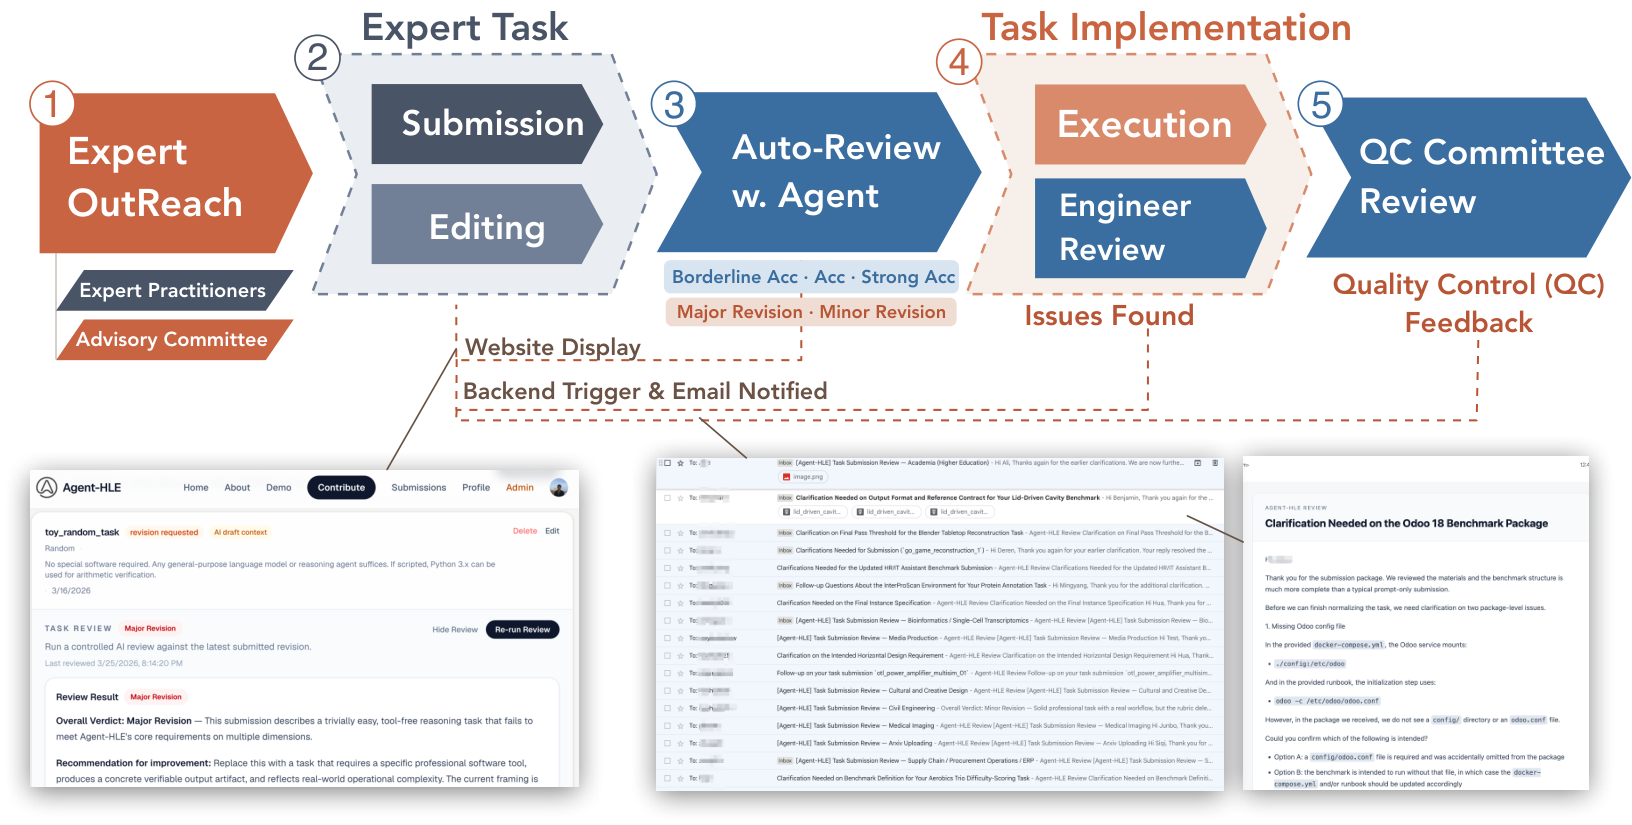
这套题不是几个人关起门编出来的。官方博客写明的规模是 55 个细分职业、1,500 多个专家任务、300 多位行业专家参与;一道题从专家提交到进题库,要过带 Agent 的自动审查、工程师复核和质量控制委员会三道关,中间任何一步退回,都得重新改。
0101 从 SWE-bench 到活着的集群
先看最基础的 Coding 和运维。这里考的不是写函数,是从一堆微服务里找出谁把线上搞挂了。
过去两年大家测编程,最习惯的路子是 SWE-bench:给模型一个 GitHub 仓库和一段报错描述,让它改几十行代码,跑通单元测试就算赢。
但任何在互联网大厂干过后端或 SRE 的人都知道,日常工作里最要命的往往不是写不出某个函数,而是线上系统突然挂了,你得在一堆微服务、数据库和配置文件里找出到底是谁闯了祸。
在 ALE 的计算与工程目录里,考的就是这种活。比如里面有一道叫 k8s_payment_api_root_cause_analysis 的题,直接模拟了线上支付接口瘫痪的现场。
模型进到环境里,面对的是一个正在报错的 Kubernetes 集群,它得自己敲命令查 Pod 状态、翻日志、核对路由和配置变更,把导致支付失败的根因找出来并修好。
还有像 k8s_migration_1 这样的集群迁移任务。评测脚本在判卷时,不仅要看服务能不能跑起来,还会用预留的快照直接比对 Pod 的实时规格(Spec),连镜像摘要(Image Digest)和挂起状态都得核对得丝毫不差。
除此之外,像分布式训练里的模型并行权重合并(mp_checkpoint_consolidation)、推荐系统排序节点的特征对齐恢复(ranking_node_feature_parity_recovery),还有企业级的数据清洗管线(ETL),全都被塞进了考题里。
这类环境最难搭的地方在于,它不能是一个静态的代码包,而必须是一套活着的服务。
我们在按 Harbor Task 标准(对应 ale-cli-bench 规范)给模厂交付这类 L2 级改进环境时,每一道题都得配一个独立可启动的 Docker 环境,还要由资深工程师手写一套可执行的参考解(Oracle)。
单这一条硬规矩,就能把市面上大半靠拼凑开源题库交差的小作坊挡在门外——因为很多团队连让包含多个依赖服务的容器每次都在固定时间内稳定启动都做不到,更别提每周稳定交付 200 道经过多模型交叉验证的原创运维题了。
0202 CUA:没有命令行的工位
一旦跨进图形界面,麻烦立刻翻倍:大量工业软件根本没有命令行。
如果模型只在黑底白字的 Linux 终端里敲命令,那还算省心。一旦跨进 CUA(直接操作电脑图形界面),工程上的麻烦就立刻翻倍。
真实世界里的工业设计和企业办公,有大量操作根本没有命令行接口。你在 ALE 的题库里能看到各种五花八门的桌面软件任务:在 Odoo 里处理全套企业资源管理流程,在 Metabase 里搭商业智能看板,
在 PowerPoint 里做品牌视觉翻新(判卷脚本甚至会按画面区域去比对排版有没有歪),在 KiCad 里给导航开关画 PCB 电路板,在 Blender 里把二维工程图纸还原成三维建筑模型,在 FreeCAD 和 LinuxCNC 里生成机床加工用的 G-code 刀路,
甚至还要在 MuseScore 和 Ardour 这种专业音频软件里扒谱、做工程迁移。
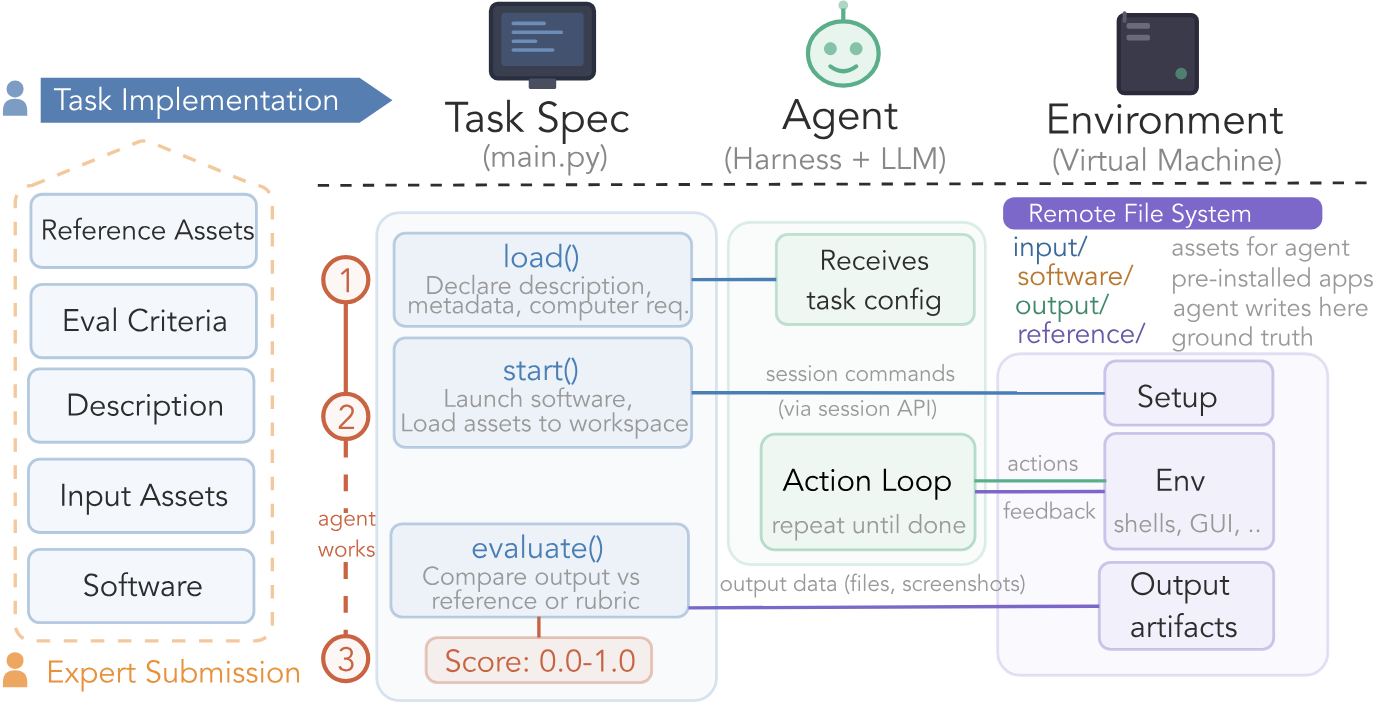
为了让模型既能敲命令又能点鼠标,ALE 官方搞了一套叫 ALE-Claw 的双桥接架构:当模型在沙箱外面跑的时候,通过两个 MCP 桥接器连进虚拟机——一个管命令行和文件读写,另一个专门管图形界面的截图、鼠标点击和键盘输入。
听起来很顺畅,但今年下半年 ALE 官方在升级 v1.1 版本时,却因为软件环境问题狠狠踩了一回坑。
在最初的版本里,有些专家顺手用商业闭源软件出了题。结果到了大规模评测和强化学习训练阶段,许可证(License)直接把路堵死了:模厂做一次评估或者跑一轮 RL,动辄要同时拉起几百上千个沙箱实例,商业软件的授权机制根本不允许这么干,环境也无法随意分发。
最后伯克利团队实在没办法,在 v1.1 里硬着头皮把 6 道依赖商业软件的题目全部重写,迁移到了 Linux 开源软件上;
还有一道做四腔模具注塑成型仿真的工程题(mold-flow),因为开源界实在找不到能同时精确模拟充填、保压、冷却和脱模全流程的替代软件,只能忍痛把整道题从活跃题库里删掉。
哪怕全换成了开源软件,普通容器也常常兜不住底。
比如 ALE 里的公路路线设计题(cailian_road_highway_alignment_2),因为底层图形与进程管理重度依赖 systemd 和独立的控制组(cgroups),在普通 Docker 容器里跑就会直接崩掉,非得拉起完整的 Linux 虚拟机才行。
把这三件事放在一起看,v1.1 真正改动的是环境的分发方式,不是题目难度。商业软件授权卡住的是并发,systemd 和 cgroups 卡住的是容器边界,自动更新弹窗卡住的是界面操作——三处都不写在模型的能力清单里,却都能让一次评测直接归零。
这也是为什么我们在给大厂做 ALE 和 CUA 交付时,专门建了一条标准化的虚拟机镜像产线。不管是 Windows 11 企业版还是 Ubuntu 24.04 桌面版,全部做成 60G 不分片的单文件 VMDK 镜像,留出至少 20G 余量,默认走 BIOS 启动。
Windows 里提前打好 VirtIO 驱动、配好 WinRM 和 SSH;Ubuntu 桌面强制切回稳定的 X11 协议(避开 Wayland 截图黑屏的坑),关掉 Swap 和一切自动更新弹窗。
很多时候,模型在 CUA 评测里拿零分,真不是模型笨,而是弹出来一个系统更新提示框把按钮挡住了。
0303 科学计算与实战攻防
再往深水区走,科学计算和安全题全是从真实实验室、真实流量里搬出来的。
把底层虚拟机和桌面理顺之后,再往深水区走,就是科学计算(Science)和网络安全(Cyber)。
以前大家以为 AI for Science 就是做生物医药问答,或者默写几个化学分子式。但在 ALE 的科学板块里,题目全是从真实科研实验室里搬出来的计算流程。
比如物理与天文方向,有一道题叫 hst_acs_wfc_visit_reduction,要求模型直接处理哈勃太空望远镜先进巡天相机(ACS/WFC)的原始曝光数据,做完整的降噪、校准和星图拼接;
在凝聚态物理里,模型得调动计算材料学工具链,去算二硫化钼(MoSe2)在自旋轨道耦合下的激子吸收光谱(mose2_bse_absorption_soc),或者跑完硅材料的能带与介电函数收敛;到了生命科学和医学,
模型不仅要跑全基因组变异检测(WGS Variant Calling)、用 AMBER 跑三阶段分子动力学结合自由能计算(MM-GBSA)、用 ZDOCK 给 HIV 二聚体界面打分,甚至还要在 MicroDICOM 里复核胸片标注,
或者用 matRad 复现前列腺癌调强放疗(IMRT)的剂量规划。
而在网络安全(Cyber)方向,风向更是彻底转向了实战攻防。
就在 11 月初,OpenAI 披露了一组震动安全圈的数据:内部安全模型从 2,308 个候选漏洞出发,动态复现了 1,724 个历史漏洞环境,顺藤摸瓜在 Linux 内核里挖出了 948 个此前未知的本地提权漏洞(LPE),整个过程花掉约 120 万美元的 API 成本。
这三个数字里最值得看的不是 948,而是 2,308 到 1,724 那一段。把一份漏洞公告变成能反复攻击、又能自动判分的复现环境,本身就是最贵的一步。安全题的难度从来不在知不知道这个漏洞编号,而在能不能把它还原成一台机器。
你看 ALE 里的安全题,路数如出一辙。
在 ghidra_malware_config_extraction_01 里,模型得自己打开美国国安局开源的逆向工具 Ghidra,反编译一个真实的恶意软件二进制文件,顺着汇编指令和交叉引用,把藏在里面的远控服务器(C2)配置信息提取出来;
在 pcap_enterprise_triage_01 里,模型面对的是一大包企业内网抓包流量(PCAP),得像安全应急响应工程师一样,从海量请求里把黑客入侵的链路筛出来;
还有像 tris_crackme 和 newyear_keygen2,直接让模型逆向破解二进制程序并写出注册机。
这也是我们团队在储备 exploitbench 和 cyberbench 两条安全产品线时最花心思的地方。做这类数据,既不能拿网上早就被模型背熟的老旧 CTF 题充数,又必须把漏洞触发环境严格封死在离线容器里。差一步,要么训不出实战能力,要么就成了安全事故。
0404 金融法律:口径比文笔贵
离商业变现最近的一块,值钱的不是把话说通顺,是把每一个数字的口径算对。
最后一块硬骨头,也是离商业变现最近的,是金融和法律这类专业白领工作。
很多人觉得金融和法律不就是读读 PDF、写写总结吗?大模型最擅长干这个。但只要你真去投行、律所或者四大事务所看一眼就会明白,专业人士值钱的地方从来不是把话说通顺,而是在几十份相互打架的文档和几万行表格里,把每一个数字的口径算对、把每一处隐藏的条款冲突揪出来。
在 ALE 的商业金融与法律目录里,任务全是这种高危活:解析美国证交会的 10-K 年报、搭建跨多张工作表的股票研究估值模型、用 Longstaff-Schwartz 蒙特卡洛方法给美式期权定价、按巴塞尔协议计算商业银行操作风险资本金、写 A 股北向资金的程序化交易策略,
或者在并购交易(M&A)的十几份法律文件里做跨文档一致性审计(legal_ma_consistency_audit_01)。
在法律领域,目前行业里公认的标杆还有估值百亿美金的法律 AI 独角兽 Harvey 搞出来的 Harvey LAB(Legal Agent Benchmark)。
它覆盖了全球 24 个法律执业领域的 1,250 个真实律所任务,背后塞了超过 75,000 条由资深律师逐条手写的评分细则(Rubrics)。
为什么专业领域的评测非得把评分细则写得这么碎?因为大模型太擅长用漂亮的官话掩盖算错的账了。
我们团队在交付这类金融法律长程测试集(包括对标 Harvey LAB 规格、周产能 200 题的专业评测线)时,就遇到过一个极其典型的案例。
当时我们用某家上市公司的 33 份真实破产重整公告做了一道尽调题,核心问题只有一个:普通债权人的实际清偿率到底是多少?
在人类专家提取的铁证链条里,重整计划规定每家债权人 10 万元以下的部分全额清偿,超过 10 万元的部分按不同方案清偿。如果把小额刚性兑付和超额部分加总,再除以普通债权的审查确认总额,算出来的真实清偿率是 35.36%。
但我们把市面上几个顶尖大模型放进去测了一圈,发现它们几乎全军覆没。有的模型直接从公告角落里抄了一个 41.65% 的预估数字交差,有的被小额部分的 100% 清偿率晃花了眼。
更要命的是,如果只用普通的 LLM Judge 去判卷,裁判模型看它们引用了公告原文、格式又极其专业,居然全给了高分。
同一道题,用不同的评分细则会得出完全相反的结论。人类专家算的是加权后的实际清偿率,模型抄的是公告里最显眼的那个预估数;LLM Judge 看的是引用是否规整、格式是否专业,恰恰看不见数字口径。判卷这件事本身,也成了一道需要被评测的题。
为了治这个毛病,我们在写这类专业题目的 Rubric 时,定下了一条死规矩:除了正向采分点,必须配齐专门抓幻觉和口径错误的负向扣分项(Negative Rubrics)。
只要模型交上来的报告里出现了 41.65% 这类未做加权折算的误导数字,或者像我们在医疗流调工作流(DM-MED-WORKFLOW)里测试的那样,把原始五份材料里根本没写的监测指标自己脑补出来写进 Word 和 Excel 交付物里,哪怕整篇报告文笔再好,直接触发倒扣分。
0505 出题人先砍自己的题
把五个方向串起来,ALE 真正在做的是给狂飙了两年的 Agent 行业泼一盆冷水。
就在前不久,伯克利 RDI 团队对初版 ALE 题库做了一次极其严苛的内部大扫除:他们把现有的 152 道题目挨个扒了一遍,结果一口气淘汰了 30 道题,剩下的 122 道活跃题目里,有 57 道被迫回炉大改——其中 47 道改了容易引发歧义的指令,
43 道重写了有漏洞的验证脚本(Verification),32 道修了环境配置。
连自己刚刚发出来的旗舰基准都能砍掉五分之一、重改一半,伯克利为什么要对自己下这么重的手?
这 57 道回炉题里,改指令、重写验证脚本、修环境三件事各占一部分,说明问题很少出在题目太难或者太简单,而是出在模型能不能被唯一地判分上。一道题如果指令有歧义,强模型按自己的理解做对了反而被判错;如果验证脚本留了漏洞,弱模型也能拿满分。
基准的可信度取决于这两头的严密程度,不取决于题目数量。
因为他们正是此前扒出 SWE-bench、Terminal-Bench 和 OSWorld 存在大面积作弊漏洞的那拨人。他们比谁都清楚,如果环境里留了一点点后门,经过强化学习训练的模型就会顺着缝隙钻进去。
所以你看 ALE 现在的运行机制(ale_run),设计得非常有意思:系统先拉起沙箱,放进任务输入,然后让 Agent 进去干活;等 Agent 彻底跑完、交出控制权之后,系统才会把隐藏的标准参考答案(Hidden Reference)挂载进容器里,启动判卷脚本打分。
先交卷、清场,最后再把标准答案拿进考场判分。
这一个看似简单的时序改动,直接堵死了过去两年大模型最常用的作弊套路——不管是翻本地 Git 历史、搜测试脚本里的硬编码数字,还是修改系统里的 curl 和动态链接库,只要标准答案在运行期间根本不存在于虚拟机里,模型就彻底没法偷看。
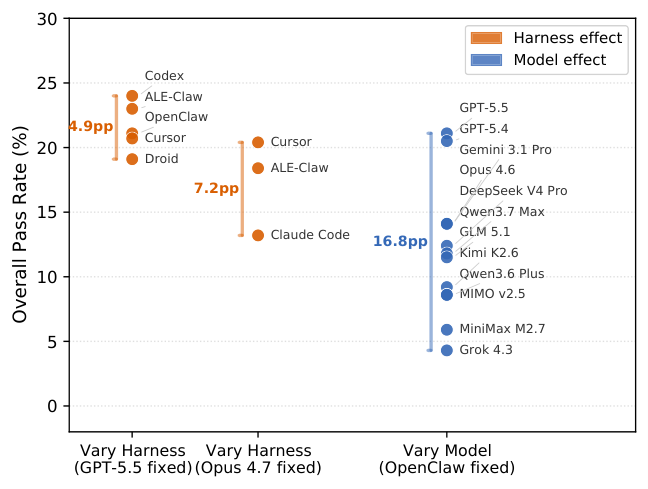
论文里还有一组对照值得放在一起看:固定模型换工具链,通过率差 4.9 到 7.2 个百分点;固定工具链换模型,差 16.8 个百分点。工具链确实能吃掉一截分数,但模型本身的差距更大。把评测环境做扎实,是为了让这 16.8 个百分点量得准,不是为了替模型补分。
说到底,今天无论是伯克利大刀阔斧重构 ALE v1.1,还是各大模厂收紧验货标准,都不是为了故意为难谁,而是被过去一年评测体系的水分逼出来的自然反应。当简单的单轮题被刷爆、当静态打分表被模型摸透套路,整个行业不得不把考场搬进真实、沉重且严格隔离的生产级沙箱里。
只是这事往深了想,依然绕不开好哈特法则(Goodhart's Law)的冷酷规律:当一个指标变成目标时,它就不再是一个好指标。
哪怕今天 ALE 把参考答案锁在了容器外面、把 122 个工业级任务做成了防作弊的铁桶,一旦这套公开题库成为所有模厂发新模型时必晒的成绩单,围绕着这 55 个细分职业场景的定向刷题和同构数据合成就会立刻铺开。
而对真正想把模型训出来的团队来说,公开榜单上的那 122 道题永远只是入场券——谁能持续不断地把真实世界里那些还没被写进公开考卷的集群故障、软件交互、科研计算与合同陷阱,变成一个个干净、自洽且带可执行验证器的私有环境,谁手里才真正攥着通往下一代模型的船票。
📚 配图来源
[1] Agents' Last Exam,Berkeley RDI,arXiv:2606.05405,Figure 4(2026-06-03)
[2] Agents' Last Exam,Berkeley RDI,arXiv:2606.05405,Figure 6(2026-06-03)
[3] Agents' Last Exam,Berkeley RDI,arXiv:2606.05405,Figure 12(2026-06-03)
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的基准、数字与官方发布均为公开第三方成果;文中涉及的能力判断为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud