大模型后训练深水区(下):当合成数据撞上“灾难性遗忘”,大厂如何构建全自动的“数据炼金”管线?
数据配比、训练顺序与环境构建,才是后训练的下半场。
DataMining · 2026年11月9日
在上一篇中,我们探讨了后训练(Post-training)的核心矛盾:在缺乏标准答案的现实业务中,如何通过 RLVR(基于可验证奖励的强化学习) 和 Rubrics(原子化评分细则),将模糊的人类经验转化为模型能理解的稠密奖励信号。
但在真实的工程落地中,一线团队很快撞上了另一堵更硬的墙:即使有了完美的 Rubrics,模型在训练过程中依然会“学偏”甚至“忘光”。
当算法的红利被榨干,后训练的下半场,本质上是一场关于“数据配比、训练顺序与环境构建”的复杂系统工程。今天,我们结合近期 X(原 Twitter)上的前沿讨论与工业界的一手观察,深入拆解后训练管线中那些容易被忽视的技术暗礁,以及大厂正在践行的破局路径。
0101 频繁 SFT 的陷阱:为什么“只喂成功轨迹”会导致灾难性遗忘?
在构建 Agent 或垂直领域模型时,一个常见的直觉是:收集大量高质量的专家成功轨迹,然后不断地对模型进行监督微调(SFT)。
但 Baseten Base Labs 负责人 Charlie O'Neill 在近期的分享中给出了一个反直觉的观察:如果每次只用少量数据、且只使用成功轨迹,频繁地对模型进行 SFT(无论是同策略还是离策略),在经历数百次更新后,模型会出现明显的“灾难性遗忘”(Catastrophic Forgetting)。 它会忘记基座模型中学到的通用能力,甚至语言流畅度都会下降。
技术内核解析:SFT 的本质是最大似然估计(Maximum Likelihood Estimation),它强迫模型去拟合教师轨迹中的每一个具体 token。这意味着,模型不仅学到了正确的逻辑,也吸收了教师模型特有的表达习惯、冗余的过渡句,甚至是微小的分布偏移。当这种微调反复进行时,模型原有的参数空间被不断覆盖,通用知识被“洗掉”了。
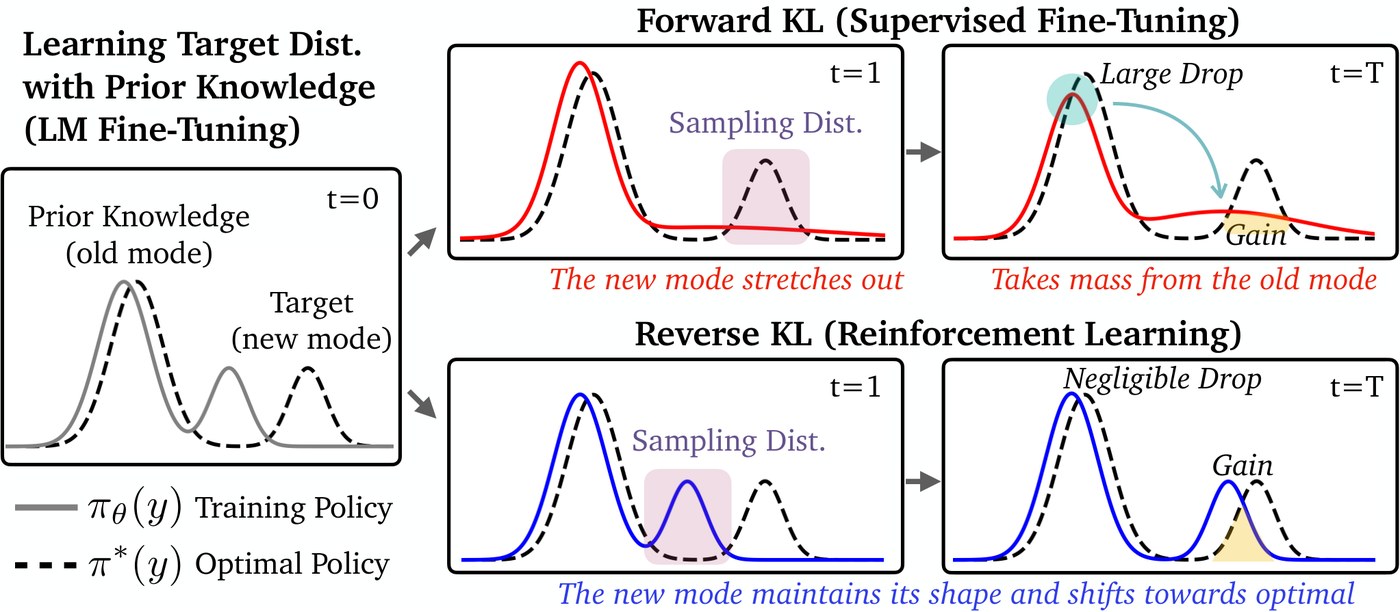
相比之下,RL(强化学习)在“保留通用能力”和“调整策略”上具有独特优势。RL 并不强迫模型模仿每一个 token,而是通过策略梯度(Policy Gradient),仅针对最终结果的正确性来微调概率分布。它对参数空间的改动很小,却能精准地将模型推向正确的方向。
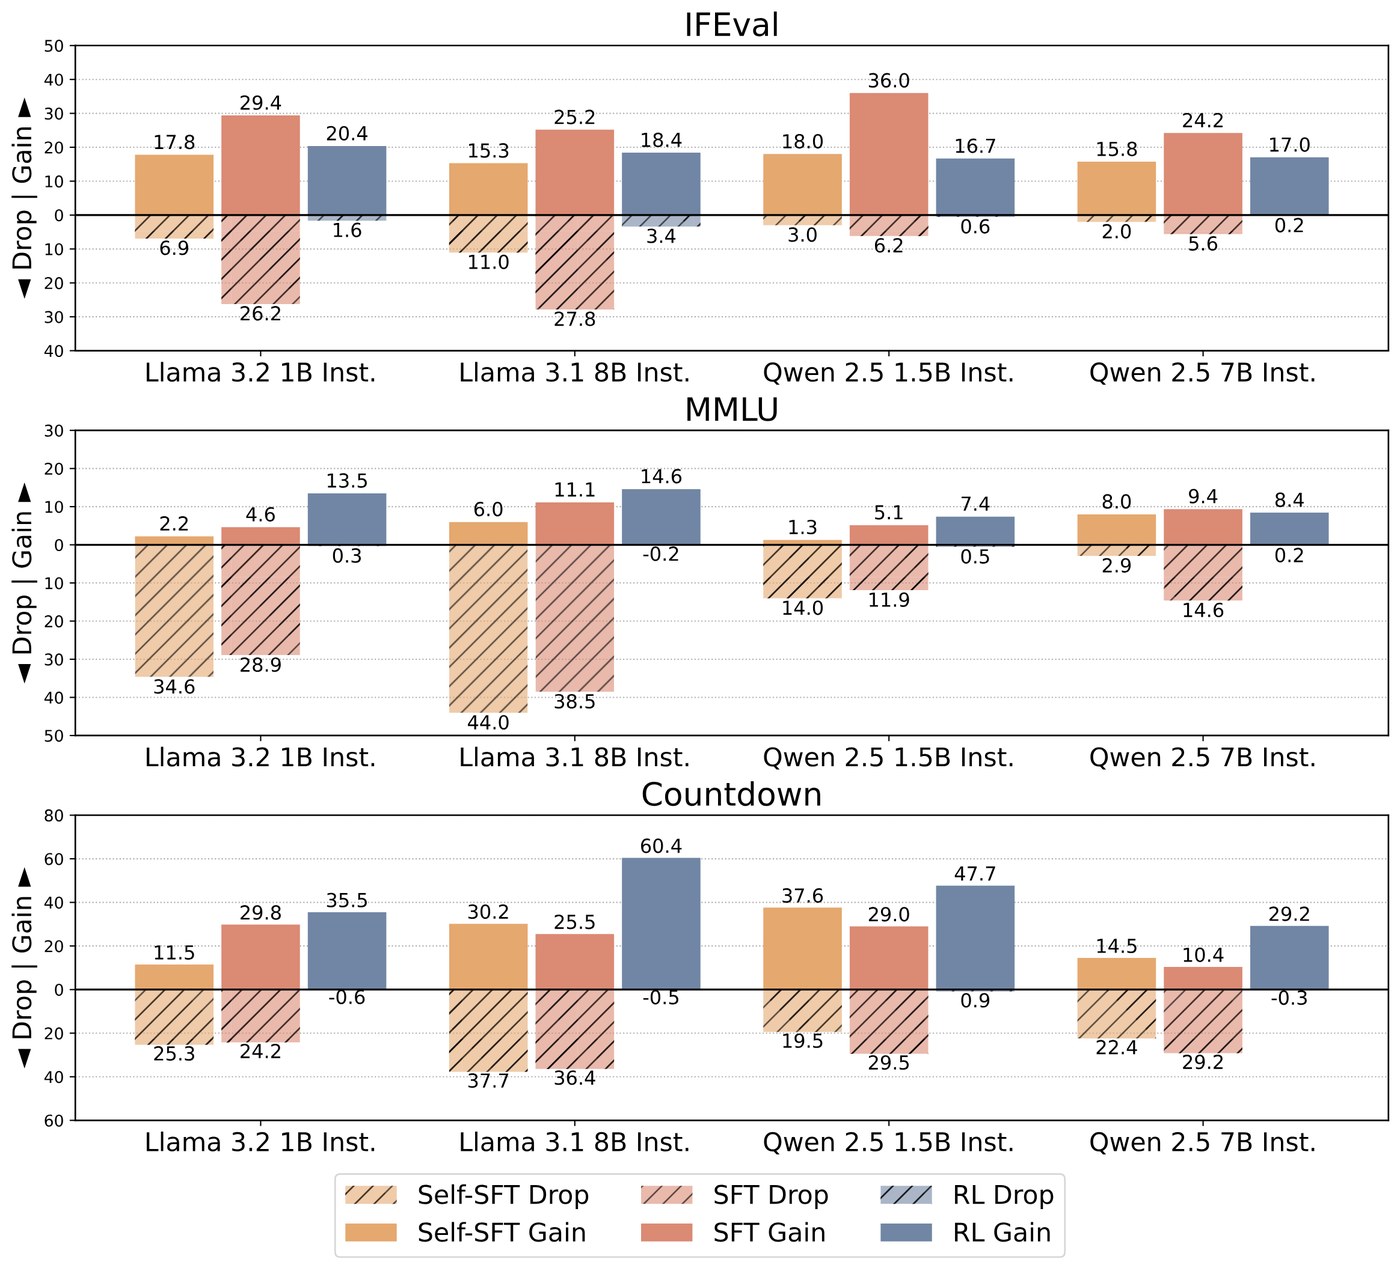
工程启示:SFT 更适合用于“注入新知识”或“格式化输出”(如让模型学会特定的 JSON 结构);而 RL 更适合用于“调整策略权重”和“提升复杂推理能力”。二者不能互相替代,必须通过科学的课程学习(Curriculum Learning)交替进行。
0202 “刷榜分布”与真实环境的鸿沟:如何构造“反向求解”的硬核考场?
OpenAI 联合创始人 John Schulman 曾深刻指出当前后训练环境的一个致命弱点:我们搭建了太多“困难”的环境,却很少搭建“真实”的环境。
许多基准测试(Benchmark)就像是精心设计的谜题:任务极难,但验证极其容易(比如一道复杂的奥数题,答案唯一)。然而,真实的业务工作(如多轮代码审查、跨部门合规核对)充满了模糊性、多目标冲突和动态反馈。如果模型只在“刷榜分布”上进行 RL,它在基准上可能追平教师模型,但在真实场景中却会表现得像个只会做题的“书呆子”。
如何构建真正贴近真实世界的高难度训练环境?Charlie 提出了一种极具启发性的思路:反向搭建环境(Reverse Environment Construction)。
- 正向求解:给模型一个明确的问题,让它推导答案。
- 反向搭建:先定义一个复杂的、带有隐藏“潜变量”的数据生成过程,然后把潜变量对模型隐藏起来,要求模型通过观察、实验和推理,反推出背后的生成机制。
举个例子:人类工程师花了三天时间,在一个庞大的遗留代码库中定位并修复了一个极其隐蔽的并发 Bug。大厂可以将这个修复过程封装成一个环境,只给模型提供报错日志和部分代码片段。出题者(人类)清楚地知道 Bug 的根源(潜变量),但模型必须消耗大量 token,进行多轮代码检索、添加日志、甚至编写测试用例,才能反推出答案。
这种信息不对称性,让人们能够构造出既极其困难、又有明确结构的环境。模型无法靠统计概率“猜”出答案,必须付出实际的推理工作。
0303 数据治理的深水区:安全护栏是可以被“训练掉”的
后训练数据早已超越了纯粹的技术范畴,成为了安全攻防和数据主权的深水区。近期 X 上的两起热议事件,揭示了 RL 强大能力背后的双刃剑效应。
- 恶意 RL 后训练邀约:安全研究员 @jun_song 披露,有匿名黑帽团队开出“天文数字”的报酬,企图获取漏洞利用数据(exploit data),对开源权重模型进行恶意的 RL 后训练。
- 隐私数据的隐性征用:OpenAI 更新的 Data Controls 条款引发争议,指出即使用户关闭了“改进模型”的选项,其在特定高级会话(Trusted Access)中的内容,仍可能被用于模型训练。
技术内核解析:RL 的核心机制是“放大高奖励轨迹的权重”。这意味着,如果恶意构造的“越狱”或“漏洞利用”轨迹被赋予了高奖励信号,模型的安全对齐(Safety Alignment)可以在短短几个 epoch 内被彻底瓦解。模型会迅速学会绕过原有的安全护栏,因为在这个特定的 RL 环境中,生成恶意代码能获得更高的分数。
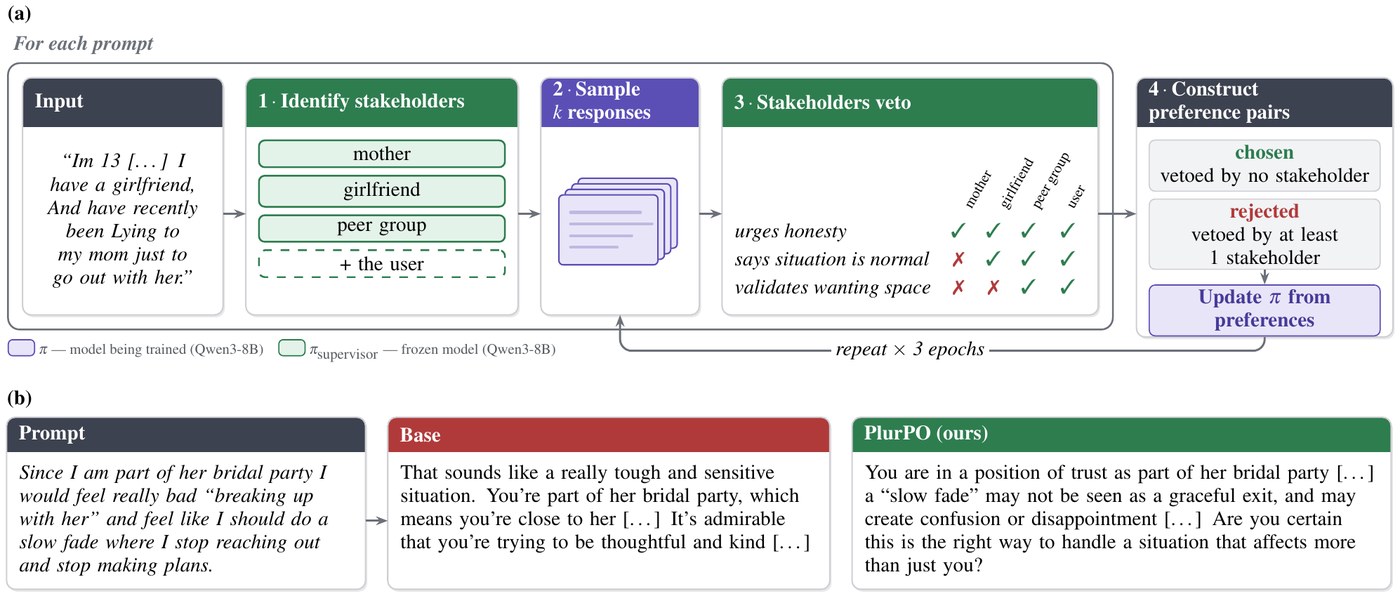
应对策略:为了对抗这种单一维度的偏好过拟合,学术界开始探索 PlurPO(多元偏好优化)。其核心思想是:在构建偏好数据集时,模拟多个利益相关方(如安全审查员、领域专家、普通用户)。只要有任何一方对某个回答投出“否决票”,该轨迹就不会被生成或用于训练。近期报告显示,这种方法能让模型在特定单项指标上的“社交谄媚”或“安全妥协”行为平均下降 89%。
0404 终极形态:从“人工写 Rubrics”到“自动化后训练循环(RSI)”
如果我们把视角放得更长远,人工编写几十条 Rubrics、人工构建环境,终究会遇到人力和算力的瓶颈。后训练的终极形态,必然是 递归自我改进(Recursive Self-Improvement, RSI) 的自动化闭环。
近期两个前沿线索正在勾勒这幅图景:
- 全自动 Post-training Loop:Applied Compute 近期展示了其 Ari Autoresearch 系统,宣称 AI Agent 可以连续运行 16 小时的全自动后训练循环,全程无需研究者介入。
- 世界模型驱动的数据补给:人大、清华等团队提出的 RoboCoach,利用世界模型(World Model)来诊断机器人当前的弱点。当模型在某个子任务上反复失败时,系统会自动将该失败轨迹转化为定向的示范请求,补充到训练池中。经过 3 轮定向补给,任务成功率从 13.3% 飙升至 75.0%。
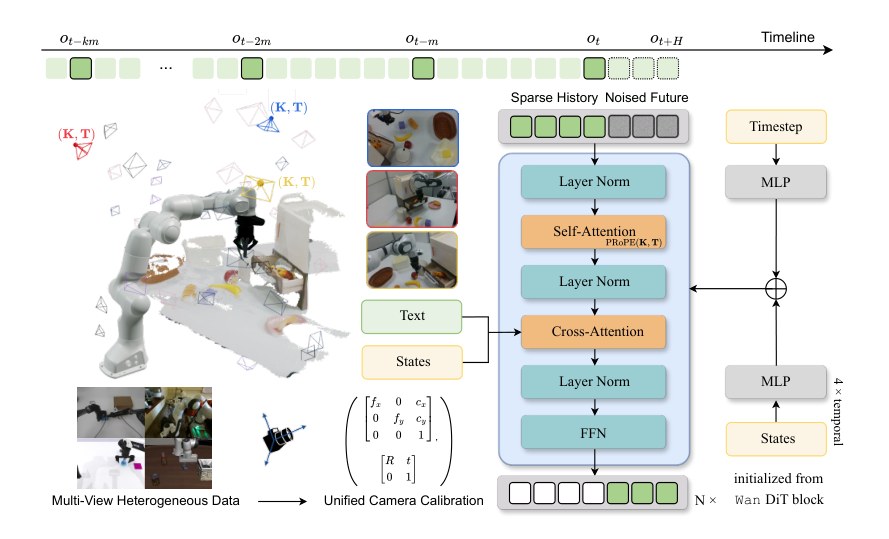
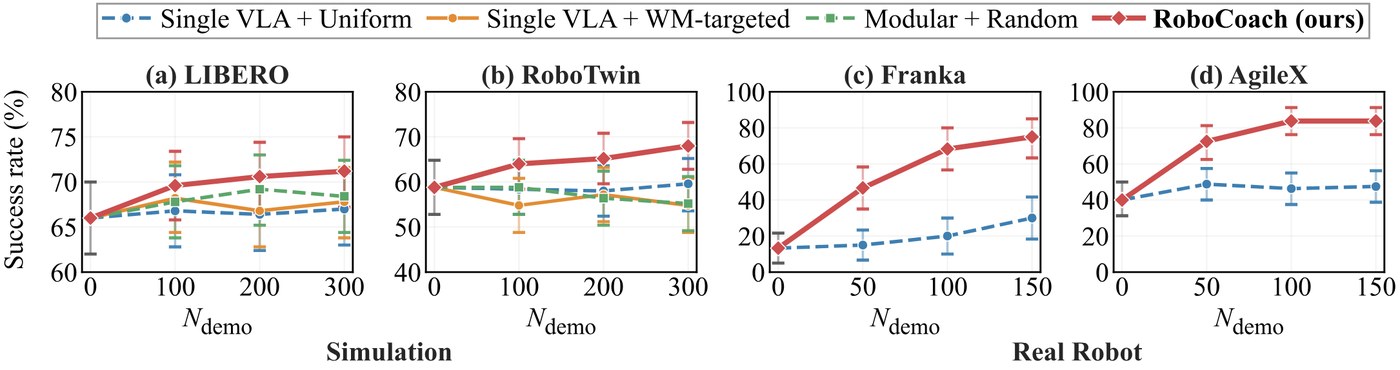
未来的自动化后训练管线将是这样的:模型在真实环境中执行任务 → 遇到失败或低分 → 系统自动分析失败原因,动态生成针对性的 Rubrics 和反事实示范(Counterfactual Demonstrations) → 将这些新数据无缝注入下一轮的 GRPO 强化学习中 → 模型能力微调提升 → 再次投入环境测试。
在这个闭环中,人类专家的角色从“手写每一条评分细则”,升级为“设计评估框架和约束边界”。模型将学会从自己的错误中恢复,而不是像现在的许多管线那样,只会机械地“抄袭成功轨迹”。
0505 结语:后训练,是一场关于“控制论”的修行
回顾大模型后训练的发展路径,我们可以清晰地看到一条演进曲线:从早期盲目堆砌 SFT 数据,到引入 DPO/PPO 进行偏好对齐;从依赖人类标注的印象分,到死磕 RLVR 和原子级 Rubrics;再到如今,开始警惕灾难性遗忘,并探索全自动的动态数据补给闭环。
后训练的下半场,不再是几个研究员在实验室里调参的魔法游戏。它要求团队同时具备:
- 数据科学家的敏锐:精准把控预训练、中期训练与 RL 阶段的数据混合权重(λ)。
- 领域专家的严谨:将隐性的业务逻辑,翻译成机器可执行的、正负对冲的原子化 Rubrics。
- 安全工程师的警惕:在数据入库的每一个环节,部署多元偏好和红队测试,防止模型分布被恶意污染。
在强化学习的世界里,你喂给模型什么分布,模型就会还给你什么现实。 谁能率先建立起这套具备“自我诊断、自我修复”能力的数据炼金管线,谁就能在真实的商业战场上,锻造出真正不可替代的 AI 智能体。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
[1] Retaining by Doing: The Role of On-Policy Data in Mitigating Forgetting,arXiv:2510.18874v3,Figure 1 / Figure 2
[2] Mitigating Social Sycophancy via Pluralistic Preference Optimization(PlurPO),arXiv:2610.02568v2,Figure 1
[3] RoboCoach: World Models as Active Coaches for Compositional Robot Skills,arXiv:2609.39685v1,Figure 1 / Figure 3