当A/在思维链里"下毒",国模们该怎么办。
DataMining · 2026年11月10日
我一直觉得蒸馏无可厚非,你A/不也是蒸馏成千上万的顶尖书籍和代码仓库还有顶级专家吗?等轮到别人蒸馏你了(还是在付钱使用你的产品的前提下)。你就双标不乐意了,Excuseme?
吐槽归吐槽,问题还是要解决的,既然蒸馏这条路未来被堵死的话,我们还是首先把数据壁垒建起来(这也是我们在做的)然后是转向基于环境的自主探索,防蒸馏时代的下半场,比拼的是 “系统工程与行业 Know-how”。
0101 巨头的“物理铁幕”:从“惜字如金”到“架构级隐藏”
如果你最近调用过 GPT-6 Astra 或 Claude 的最新推理版本,你会发现一个明显的趋势:它们变得越来越“高冷”了。
今年 10 月,Tech Times 援引 The Information 的报道称,OpenAI 9 月发布的 GPT-6 Astra 有限度地采用了 Loop Transformer(循环 Transformer,也叫 recurrent depth)架构。
反复循环的计算留在高维隐藏状态里,不会解码成文字,模型写出来的推理步骤因此变少。OpenAI 在系统卡里也承认,Astra 的书面推理比 GPT-5.6 Sol 更难监控,在简单任务上能用更少的书面步骤把题做出来。
但要把这件事说成“思维链出现大片空白”,就走过头了。OpenAI 明确表示 Astra 的思维链仍大体可读,“完全不产生人类可读输出”是被否认的假想状态;官方公告里也根本没有 Loop Transformer 这个词,架构说法目前只来自媒体报道。
真正的变化是可监控性下降、书面步骤变短,不是把推理从屏幕上抹掉。
如果说 OpenAI 是在模型和架构层面收紧推理轨迹,那么 Anthropic 则是在 API 策略层面重拳出击。Anthropic 在 2026 年 10 月 12 日发布《Strengthening our defenses against distillation attacks》,
披露了 preserved thinking(保留思考):2026 年 8 月 31 日及之后新建的 API 账号不能编辑 Claude 先前的上下文;推理块不允许跨会话、跨模型、跨账号搬运;推理记录只对发起请求的组织可见;再加上一套两阶段分类器,误报率低于 0.1%。
官方给出的数字是:在 Anthropic 自有平台上,蒸馏者提取到的推理 token 量下降约 90% 到 99%(约 10 到 100 倍)。这是早期证据,也是 Anthropic 自己的估算,第三方云和其他推理服务商的流量不在统计里,官方同时写明“我们还不知道这些收益能维持多久”。
把它写成“全网恶意抓取量下降 99%”,是另一回事。
安全研究者一直在找突破口。2026 年 8 月的 EchoCoT 利用工具调用之间的推理重放面和 API 返回的保真度信号,从黑箱推理模型里近逐字还原隐藏思维链;
同年 2 月的 Trace Rewriting 则反过来,用辅助 LLM 在保持语义和答案正确性的前提下重写教师的推理轨迹,让这些轨迹不再适合拿去做下游蒸馏训练。
但这场“猫鼠游戏”的成本正在呈指数级上升。大厂已经意识到,无底线的 API 蒸馏正在抽干他们的护城河,通过架构隐藏和 API 封锁,巨头们正在从物理层面锁死高质量推理轨迹的流出。
靠“白嫖”海外 API 做 SFT 的时代,彻底终结了。
0202 就算你“偷”到了 CoT,你的模型也未必学得会
假设你绕过了 API 限制,用自定义工具强制调用,成功提取了 GPT-6 Astra 的极简草稿,然后把这些草稿喂给参数量较小的开源模型做蒸馏,会发生什么?
奥尔堡大学等机构在 2026 年 9 月 22 日发表的《Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models》,
做的正是这件事的前半段:通过标准 API 注册一个自定义工具,把前沿模型的中间推理逼出来。论文的发现是,Astra 走的是省字但方向准的路子,更早选中正确轨迹,把基础步骤放在内部完成,只把关键推理外化出来。
论文在 80 道竞赛数学题(47 道 APEX Shortlist 加 33 道 2026 年 2 月 HMMT)上做三条件对照,并把提取到的轨迹跨模型复用:接收模型拿到的是去掉末尾最终答案的推理文本,然后关掉原生推理、单次作答。
结果里最刺眼的一组数字是:Astra 的轨迹在 73/80 道题(91.25%)里已经把正确答案明写进推理文本;
但把轨迹交给较弱的接收模型后,在它们各自的错题里,仍有 68.75% 到 83.33% 属于“答案就写在输入里却答错”,GPT-5.4 nano 是 11/16,DeepSeek-V4-Flash 是 11/15,另一个接收模型是 15/18。
附录里那道条件概率题更直观。Astra 的短草稿直接写出 24/60 = 2/5,分子分母都给了;DeepSeek-V4-Flash 仍然输出 4/7,GPT-5.4 nano 输出 2/3,论文里另一个接收模型答对了 2/5。作者的评语是:输入明明同时给出了分子和分母,失败还是发生了。
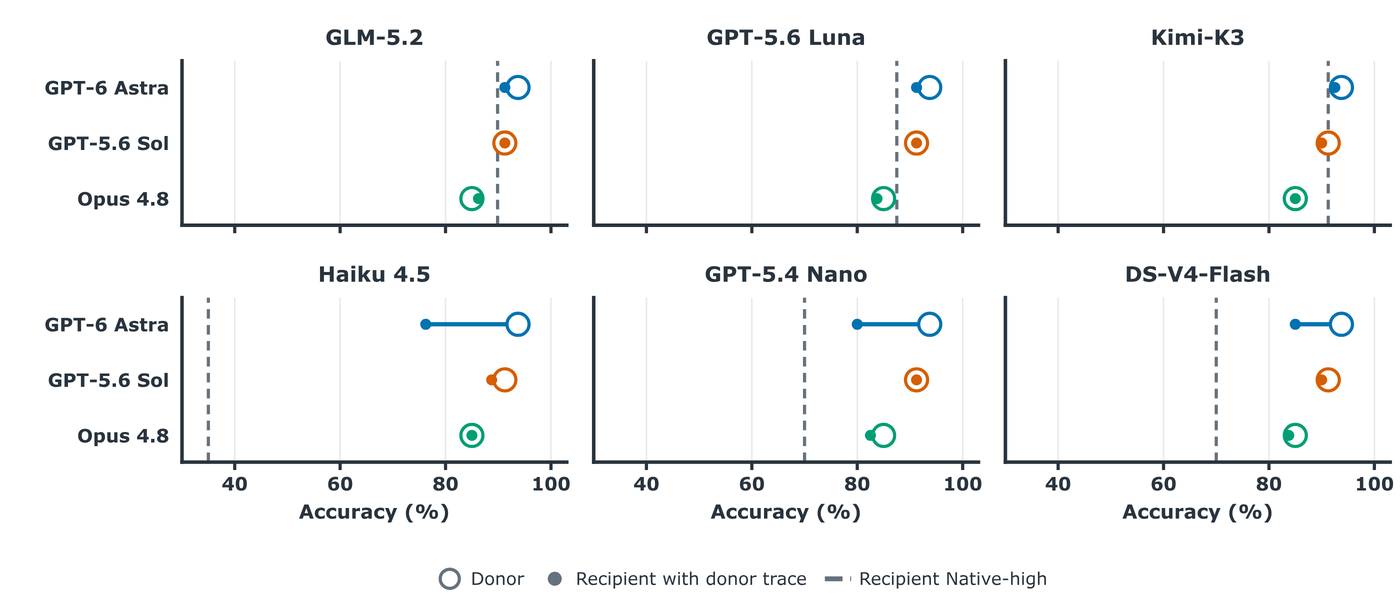
为什么会这样?论文的措辞是接收方能力门槛:强接收模型几乎无损地复用紧凑轨迹,弱接收模型只能部分复用。作者把它当作“强教师未必带出好学生”的一个候选机制,但紧接着写得很清楚:这个实验测的是上下文复用,不是后训练蒸馏,也没有把压缩单独分离成因果因素。
换句话说,强模型主动省去的基础推导步骤,正是弱模型需要的逻辑台阶。对 GPT-6 Astra 这种级别的模型,代数题直接给出关键关系、跳过因式分解过程是它的“直觉”;但对参数量较小的模型来说,缺了中间步骤,逻辑链条就闭不上,只能靠自己的“幻觉”去猜一个答案。
所以别急着把“知识诅咒”写成论文结论,论文里没有这个词。能站得住的判断只有一句:把紧凑轨迹直接拿来训练,前提是学生自己补得上被省去的台阶。这也是作者在讨论蒸馏时格外克制的原因。
0303 放弃幻想:后训练必须走向“内生探索飞轮”
既然“抄不到”(API 防提取),且“抄到了也未必学得会”(接收方能力门槛),国内大模型的后训练出路在哪里?
答案很残酷,但也很清晰:彻底放弃对“完美教师轨迹”的幻想,转向基于环境的自主探索(RLVR,可验证奖励强化学习)。
不要试图把爱因斯坦的极简草稿塞给小学生,而是给小学生一个带验证器的沙箱,让他自己去试错、去撞墙、去生成属于他自己当前能力边界的“真实台阶”。
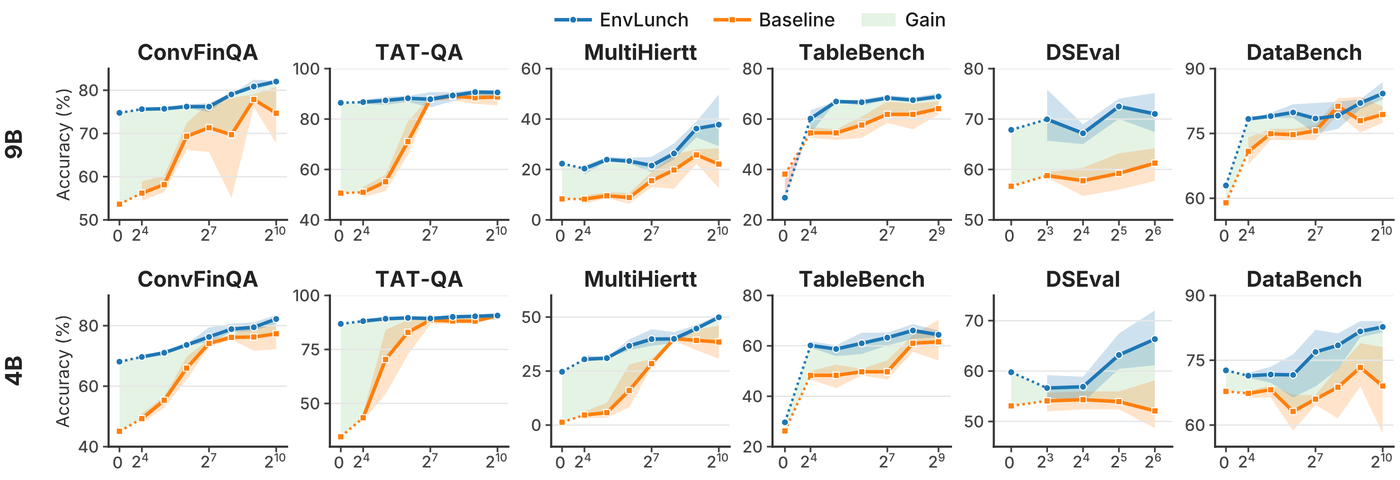
近期的前沿论文也印证了这一趋势。
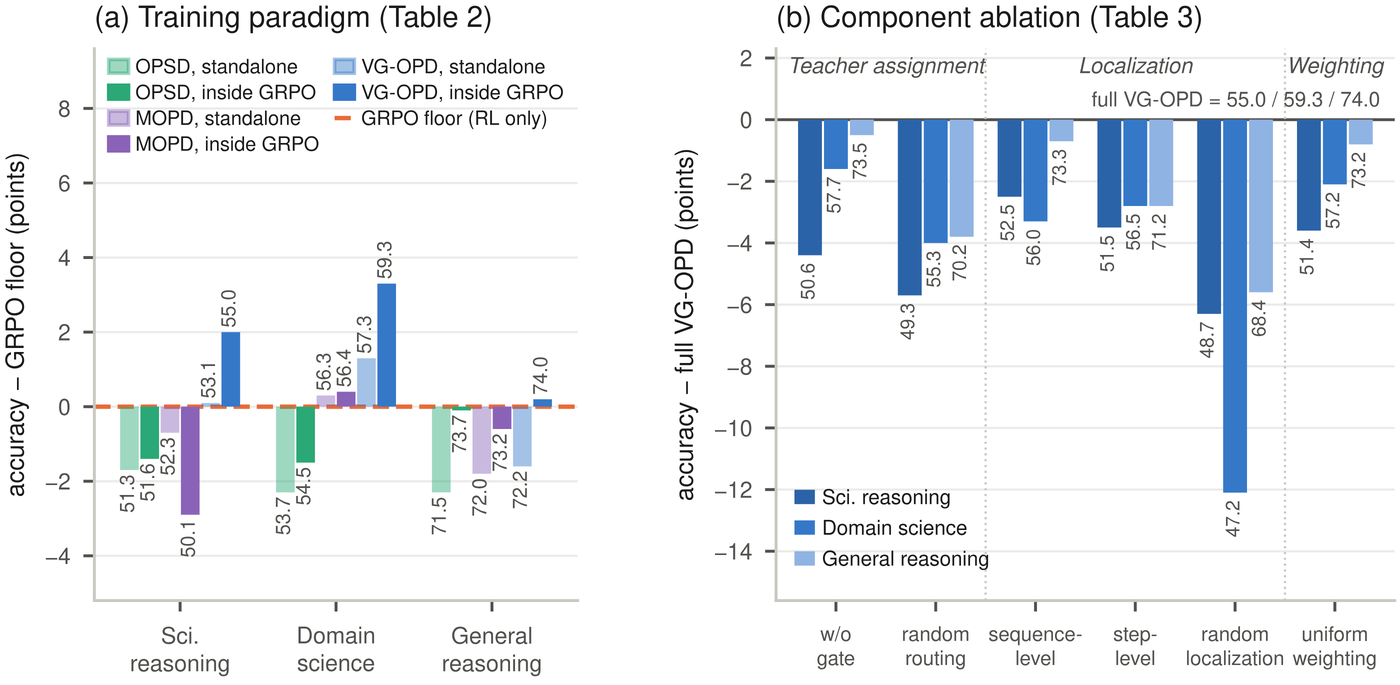
2026 年 9 月的《Who Teaches Which Token? Verifier-Gated Multi-Expert On-Policy Distillation for Scientific Reasoning》用验证器按答案准则的反事实增益,决定哪个专家有资格教哪些 token;
论文里那句“没有老师也好过一个没验证过的老师”,说的就是门控把局部出错的专家拒掉。无门控的稠密蒸馏,反而会把 RL 拖到它自己的下限以下。
2026 年 6 月的《Rubric-Guided Self-Distillation: Post-Training Without Rubric Verifiers》走的是另一条路:在既没有外部更强教师、也没有标准答案推理轨迹的开放域,把 rubric 当特权上下文,
让 rubric 条件化的基础模型当教师,向无条件的学生逐 token 自蒸馏,训练期把 LLM 判官整个拿掉。作者把它定位成 verifier 成本和可靠性受限时的互补方案,而不是全面超越 GRPO。
在 DataMining 德塔曼宁,我们早就停止了低效且高风险的“API 轨迹倒卖”。我们为大厂提供的是内生数据飞轮的基础设施,核心由三个齿轮咬合而成:
- 高保真沙箱(Environment):把“做题”变成“干活”
我们不再交付纯文本的 QA 对,而是将真实的业务案卷进行逆向封装。例如,在参照 UC Berkeley RDI 的 ALE(Agents' Last Exam)与 Harvey 的 Legal Agent Benchmark(LAB)做财税/法律任务时,
我们会将包含错漏的原始台账、相互打架的合同扫描件打包封进自包含的 input_files/ 目录,并拉起一个隔离的 Docker 沙箱。
模型面对的不再是一道“阅读理解题”,而是一个需要它自己去 grep 搜日志、用 Python 写脚本核对跨期错账的真实工作台。只有在真实环境中撞过南墙,模型才能长出真正的“业务直觉”。
- 原子级 Rubric(Verifier):把“印象分”变成“手术刀”
在没有标准答案的开放域,如何判定模型做对了?我们把合伙人和审计师的隐性经验,拆解为 35~60 条正负对冲的原子级检查项。
严禁出现“且”、“同时”等模糊连词,一条标准只查一件事;
针对业务暗礁设计重罚项(如对外脱敏清单漏遮一个身份证号,直接 -10 分一票否决);
强制绑定证据链(如“结论必须与 raw_ledger.csv 第 14 页数值一致”)。
这套严苛的 Rubric,就是 RL 管线中最稠密、最精准的奖励信号(Reward Signal)。
- 绝境纠错轨迹(Exploration):教模型“如何自救”
传统的蒸馏只能产生“一次做对”的顺风局数据。但在真实世界中,Agent 走到第 15 步突然报错是常态。
我们在交付数据时,重点攻坚了绝境纠错轨迹(Recovery Trajectories)的合成。利用我们提供的环境状态快照(State Snapshot),算法团队可以让模型从任务的第 80% 进度接手,先学会“收尾”,再逐渐将接手点前移。
这种包含大量“试错-报错-反思-修正”的 CoT 轨迹,才是当前 RLVR 最渴求的顶级燃料。
0404 蒸馏的尽头是同质化,探索的尽头才是智能
大模型数据合成的上半场,比拼的是“算力与爬虫”——谁能更便宜地调用海外 API,谁能更快地把开源代码洗进预训练语料库。
但防蒸馏时代的下半场,比拼的是 “系统工程与行业 Know-how”。
当 GPT-6 Astra 把书面推理步骤压短、连 OpenAI 自己都说可监控性在下降,当 Anthropic 把自有平台上蒸馏者提取的推理 token 压到原先的十分之一以下,当紧凑轨迹在弱模型上撞到接收方能力门槛,大模型的进化,必须建立在自主探索之上。
在 DataMining 德塔曼宁,我们一直坚信一个朴素的道理:不要给模型喂别人嚼过的答案,给它建一座标准化、可验证的“考场”。
我们交付的不是二手的 CoT,而是带确定性验证器的 Harbor Task,是正负对冲的原子级 Rubric,是能让模型在绝境中学会自救的 State Snapshot。
谁先建起这座内生进化的“标准化阅卷室与沙箱”,谁就能跨越蒸馏陷阱,在真实商业世界里训出真正能干活的 Agent。
📚 配图来源与参考文献
[1] Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models,Aalborg University 等,2026-09-22,arXiv:2609.26637(配图一,Figure 4)
[2] EnvLunch: The Environment as a Free Lunch for Learning to Interact,2026-10-24,arXiv:2610.33817(配图二,Figure 1)
[3] Who Teaches Which Token? Verifier-Gated Multi-Expert On-Policy Distillation for Scientific Reasoning,2026-09-14,arXiv:2609.15404(配图三,Figure 5)
[4] OpenAI,GPT-6 Astra 公告,2026-09-03;Tech Times,Loop Transformer 报道,2026-10-15;Anthropic,Strengthening our defenses against distillation attacks,2026-10-12
[5] EchoCoT: Extracting Hidden Chain-of-Thought from Large Reasoning Models,2026-08-20,arXiv:2608.20055;Protecting Language Models Against Unauthorized Distillation through Trace Rewriting,2026-02-16,arXiv:2602.15143
[6] Rubric-Guided Self-Distillation: Post-Training Without Rubric Verifiers,2026-06-10,arXiv:2606.12507;Agents' Last Exam,UC Berkeley RDI,arXiv:2606.05405;Harvey,Legal Agent Benchmark (LAB),2026-05-06
关于 DataMining 德塔曼宁 专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们交付的不是二手的 CoT,而是带确定性验证器的 Harbor Task、正负对冲的原子级 Rubric 与环境状态快照。 本文引用的基准、数字与官方发布均为公开第三方成果;文中涉及的能力判断为我们的内部同口径结论,不代表第三方官方结论。