评估 AI 数据供应商的四个维度:专家网络、测量科学、执行环境与反馈回流
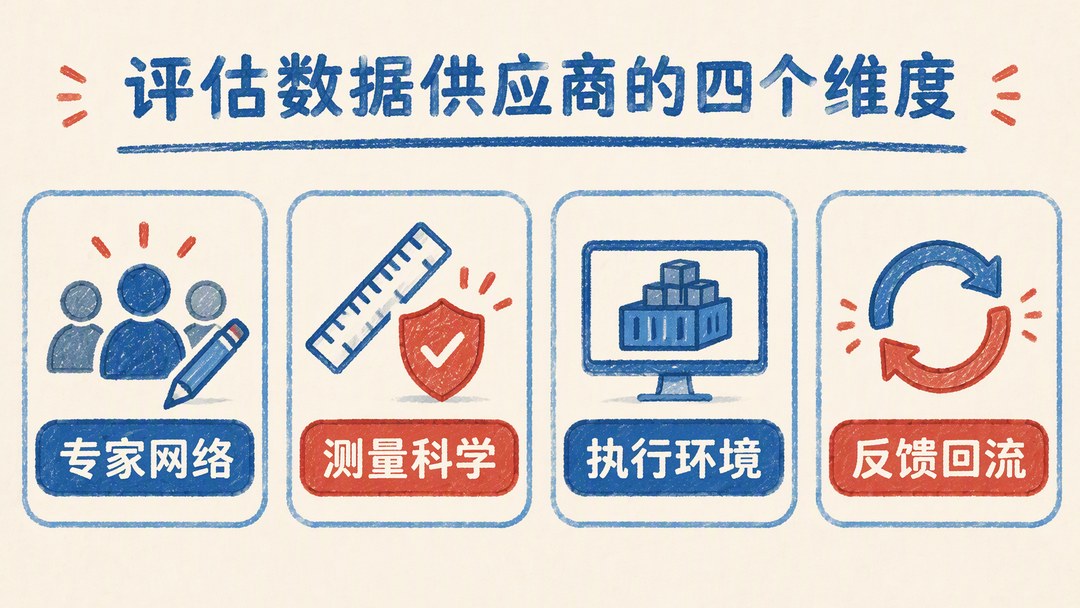
买数据和买模型 API 不一样:模型能力有公开榜单可以对照,数据的好坏在交付之前,只存在于供应商自己的讲述里。行业里的供应商盘点把竞争力归纳为四个维度——外部专家网络、任务测量科学、可规模化的执行环境、真实场景的反馈回流——这篇文章把这四个维度整理成一份评估清单:每个维度看什么证据、什么证据不算数、对应的采购动作是什么。
数据采购收到的材料里,最常见的三类说法是:注册专家几十万、题库几十万道、客户使用后分数提升多少。这三类都是自述指标,采购没法验证。四个维度之所以比专家数和题量更接近生意的本质,是因为它们回答的是同一个问题:产能和质量从哪来。
我们自己是供应商,先交代立场:下面的每条证据标准都同时用来检验我们自己,每个维度会写清楚我们拿得出什么、拿不出什么。
01先说结论
四个维度各看一种证据。专家网络看命题质量:专家是否自己命题、参考答案能否追溯到输入材料、交付前有没有独立质检,注册人数不算证据。任务测量科学看判定能否复跑:答对与否由程序或逐条标准判定,难度差异要有带口径的实测对比,出题量不算证据。执行环境看交付形态:交付的是「任务+环境+参考解+验证器」的整套,还是一份样本文件;环境能否重置重放,是能不能接进训练流程的分水岭。反馈回流看任务来源:任务来自真实工作还是凭空编造,模型失败的数据能不能采集回来继续训练。采购动作对所有维度通用:先跑小规模 POC,再配采购方自己保留的隐藏测试集。
02维度一:专家网络——看命题质量,不要数人头
行业里最容易比较的是专家规模:注册专家几十万、覆盖上百个行业。但注册数和产能是两回事,一位注册专家一个月实际产出多少条合格数据,才是产能的真实口径。这个数字只有供应商内部有,采购看不到。评估专家网络,别比较规模,看三个证据。
第一,专家在流程里做什么。如果专家只给模型生成的题目打分,这条流程的瓶颈是模型而不是专家;如果专家自己命题、自己写参考答案、自己定评分标准,瓶颈才是专业能力。Agent 评测基准 ALE(Agents' Last Exam)是一个公开参照:由伯克利 RDI 组织、250 多位行业专家共同开发,覆盖 13 个行业集群下的 55 个子领域,论文口径已收集 1,000 多项任务,任务由行业专家从真实执业场景带出来。Harvey 的 Legal Agent Benchmark 是另一个:1,250 个任务覆盖 24 个法律执业领域,评分标准超过 75,000 条,全部由专家撰写。专家的产出物是评分标准,不只是答案,这是「专家在命题」和「专家在挂名」的区别。
第二,参考答案能不能追溯。专家写的参考答案,每个结论要能指回「哪份材料、哪一段」。少了这层,质检的人没法区分结论是从材料推出来的,还是专家自己补的。我们做行业专家任务包时,交付结构里固定有一个字段:专家解题思路与证据索引,作用就是这个。
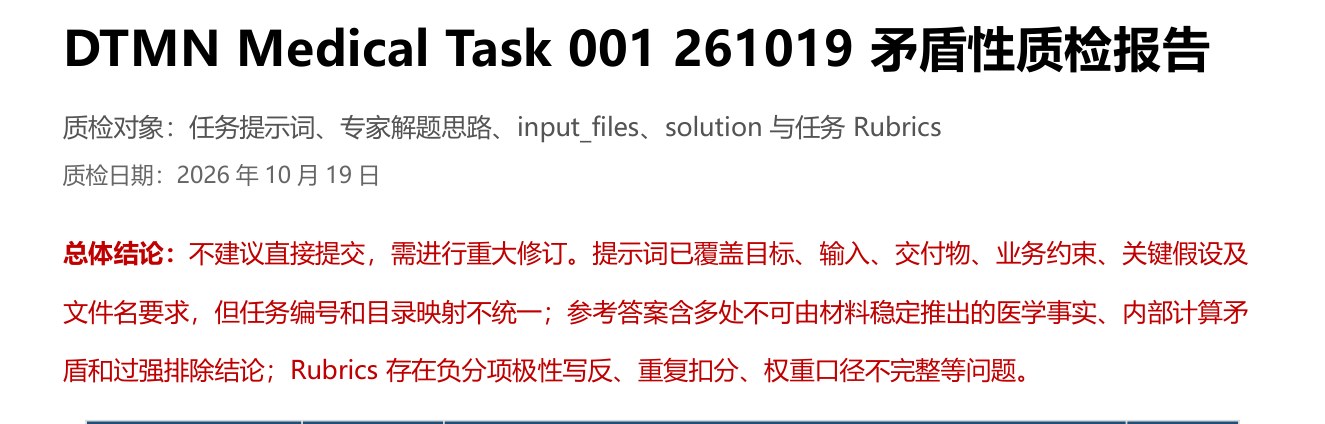
第三,交付前有没有独立于命题人的质检。专家审自己的稿子,能发现的错误有限。我们给专家交付的任务包加了一道矛盾性质检,检查五个维度:提示词完整性、文件与标识一致性、参考交付物正确性与可推导性、参考交付物跨文件一致性、评分标准质量。举一个我们真实判定过的例子:一份食品安全流调任务包,材料里没有记载晚餐开席时间,参考答案直接按 18:00 假设推算潜伏期,并据此排定了致病因子优先级;材料只记载了腹痛和腹泻,答案却写了「无频繁剧烈呕吐」这样的阴性症状。两处都会改变专业结论。质检报告把它们标为高风险,明确写不建议提交,而不是提醒一句就放行。
这条维度上我们的边界也说清楚:我们是命题制的小规模专家网络,核心命题由北京大学计算机学院软件所的博士生团队承担,医疗、法律、金融的行业任务由执业专家命题;我们不是以注册人数见长的平台型网络。采购要的是大规模泛标注产能时,比的本来就是另外一套东西。
03维度二:任务测量科学——可复跑的判定才是壁垒
这一维的核心,是把真实、长程、高风险的工作任务,转成可审计、可复现、带细粒度评分标准的数据。转译能力比专业 know-how 更稀缺,因为它要求同时懂业务和懂评测工程。看三个证据。
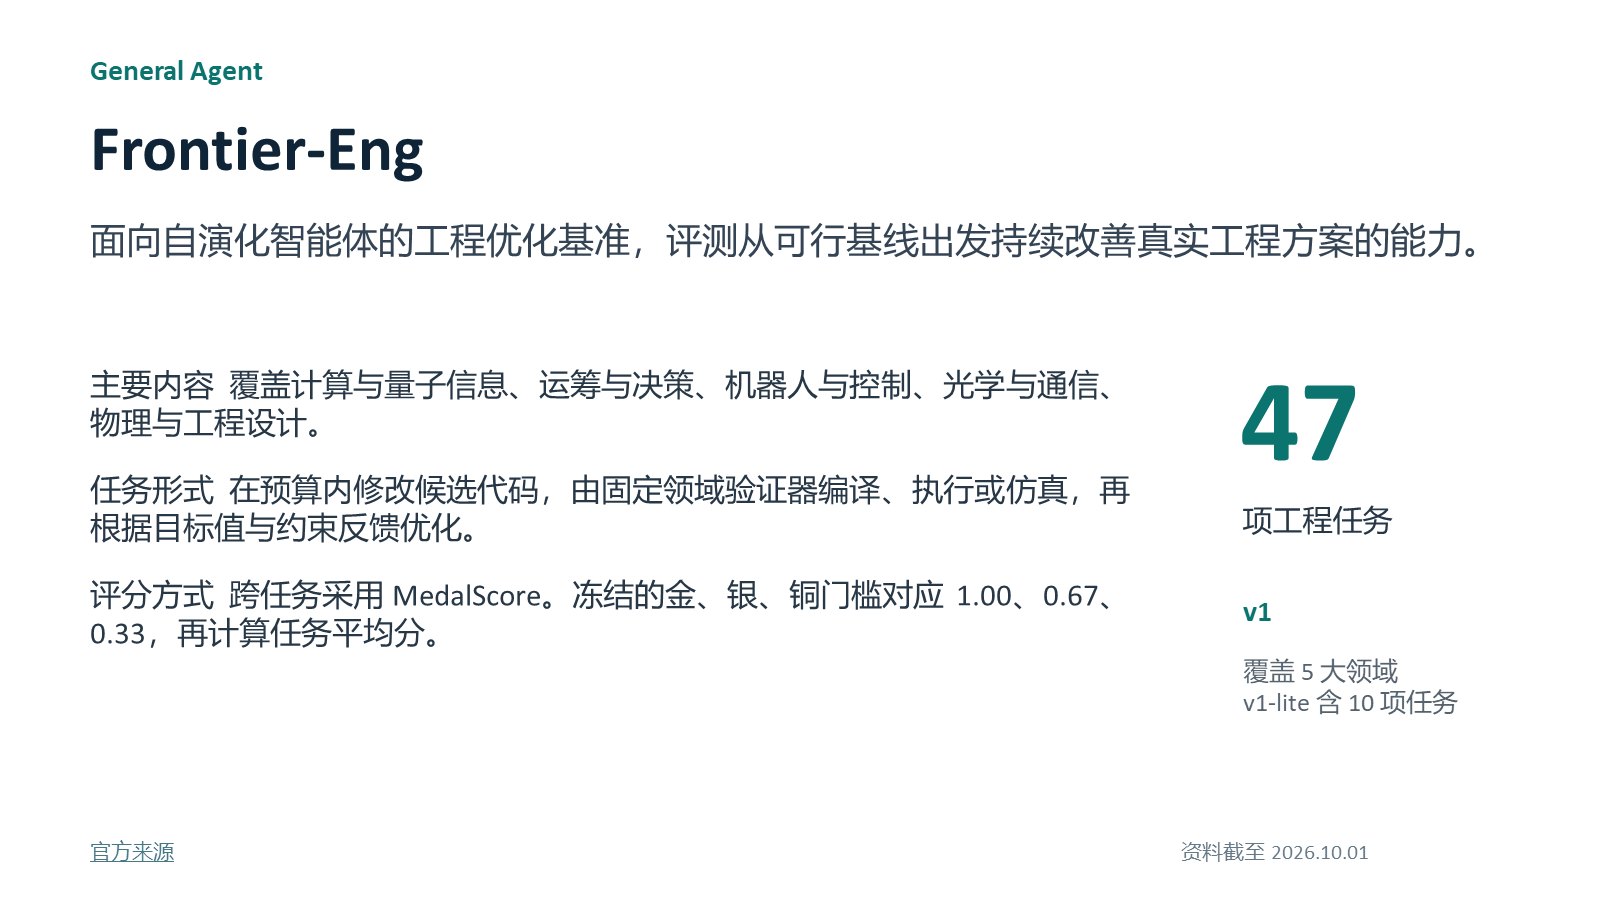
第一,判定能不能复跑。「答对」应该由程序判定,或者由逐条可核对的标准判定,不能靠模型裁判的印象分。Frontier-Eng 是个干净的参照:47 项真实工程任务,覆盖计算与量子信息、运筹与决策科学、机器人与控制、光学与通信系统、物理科学与工程设计五个领域,模型在固定交互预算内反复修改代码,分数由领域验证器编译执行后按目标值与约束给出,金银铜门槛冻结在 1.00、0.67、0.33。评分是跑出来的,不是评出来的。
第二,题目本身有没有被「测量」过。HLE(Humanity's Last Exam)在题库阶段先用带检索的模型筛一遍,再逐题人工审计,把搜索就能找到的题剔掉,保证测的是推理而不是记忆。对题目自身的这层质检,做和不做的差别,在分数上就是「能力」和「污染」的差别。
第三,难度差异有实测还是只有说法。「我们的题更难」这句话,唯一有意义的形态是在约定模型上跑出来的对比数字,并且说清楚模型名、对比对象、指标名。任何不带这三个要素的难度声明,都应该当成宣传处理。HLE 方向我们放一组内部实测:竞赛教练团队全新命制的数学、物理、化学专家题,在我们内部对照评测中,Seed-2.1-pro-0915 的准确率分别提升 4.6、5.3、2.7 个百分点。口径要标注清楚:这是内部对照评测的结果,HLE 官方榜单上没有这个模型的成绩,这组数字只用于说明题目难度区间,不用于榜单比较。数学题的判定走形式化求解器(Z3/SymPy),物理和化学走多模型交叉验证加双盲专家复核。
我们自己的难度口径在下一节。
04中期案例:Deep SWE 类任务的两条实测数字
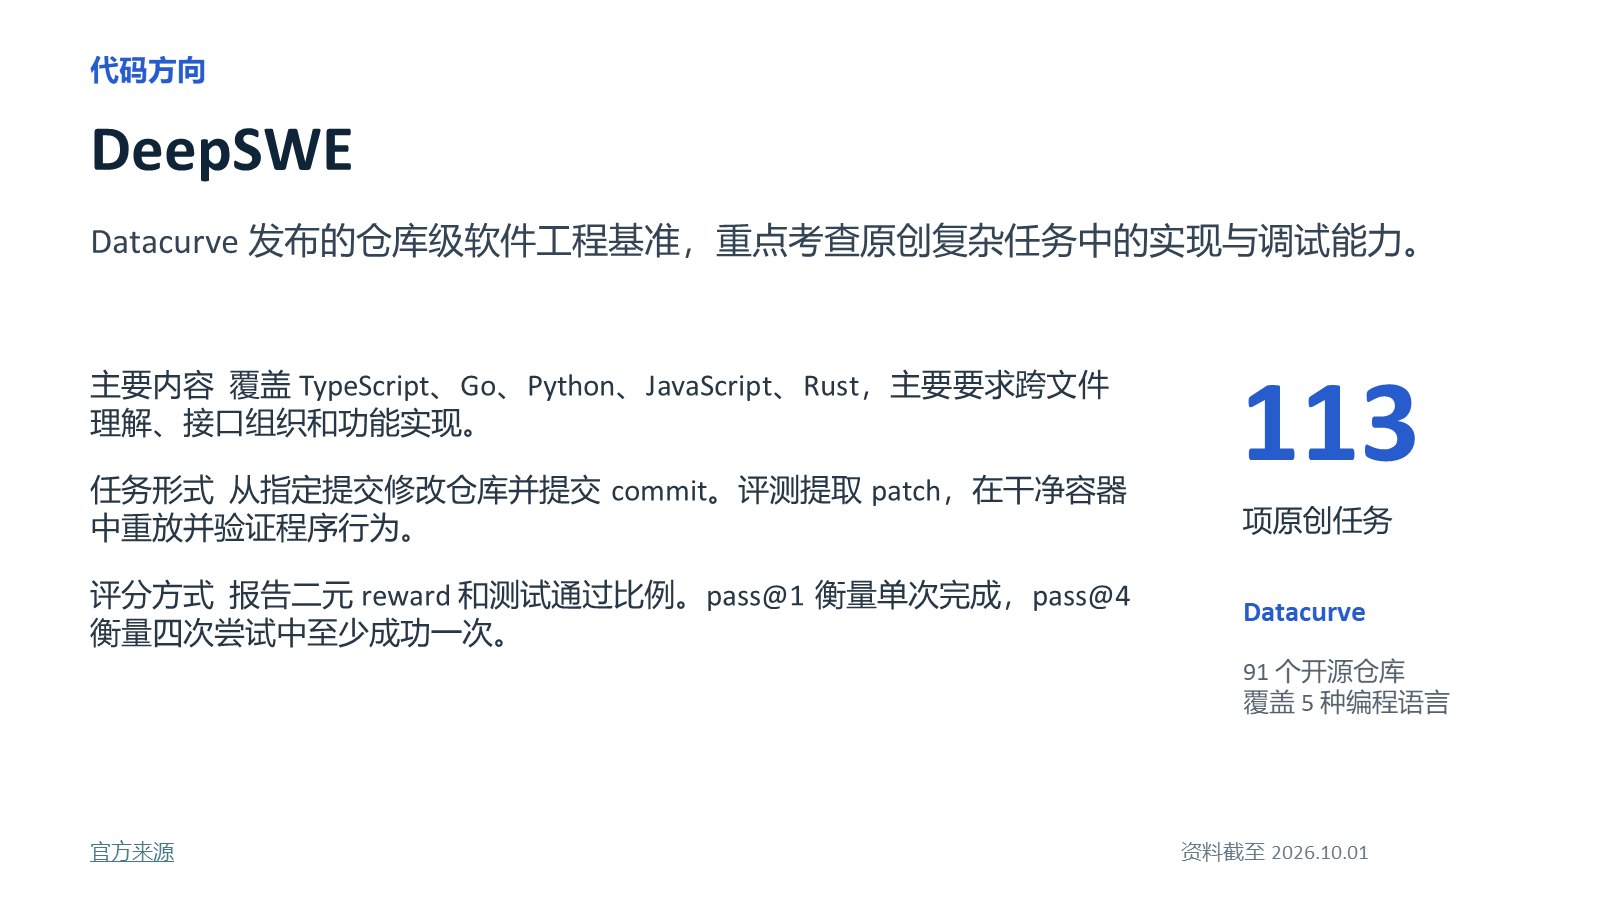
我们对 Deep SWE 类任务的做法与原始口径一致:真实活跃开源仓库、真实功能验证器、真实参考解,评测时把提交抽成 patch,在干净容器里重放验证。交付能力 200 题/周、7 个工作日,质检走多模型交叉验证加双盲专家复核。 可对比的差异是两条实测数字:在 Deep SWE 类任务数据对比中,GPT-5.6-sol 在我们数据上的准确率(ACC)比其他同类供应商的同类数据低约 15 个百分点;同一批任务上,智能体的推理轨迹比其他供应商长约 20 轮。 这两条数字说的是同一件事:任务把模型推到了更长的推理路径上,而不是让它更快交卷。对要训练长程代码能力的团队,轨迹长度本身就是可训练的信号。
05维度三:执行环境——交付的是整套,不是样本
题只是交付物的一小块。要把数据接进训练或评测流程,采购需要的是「任务+环境+参考解+验证器」的整套,其中环境是分水岭:它决定这批数据能不能规模化地反复使用。看三个证据。
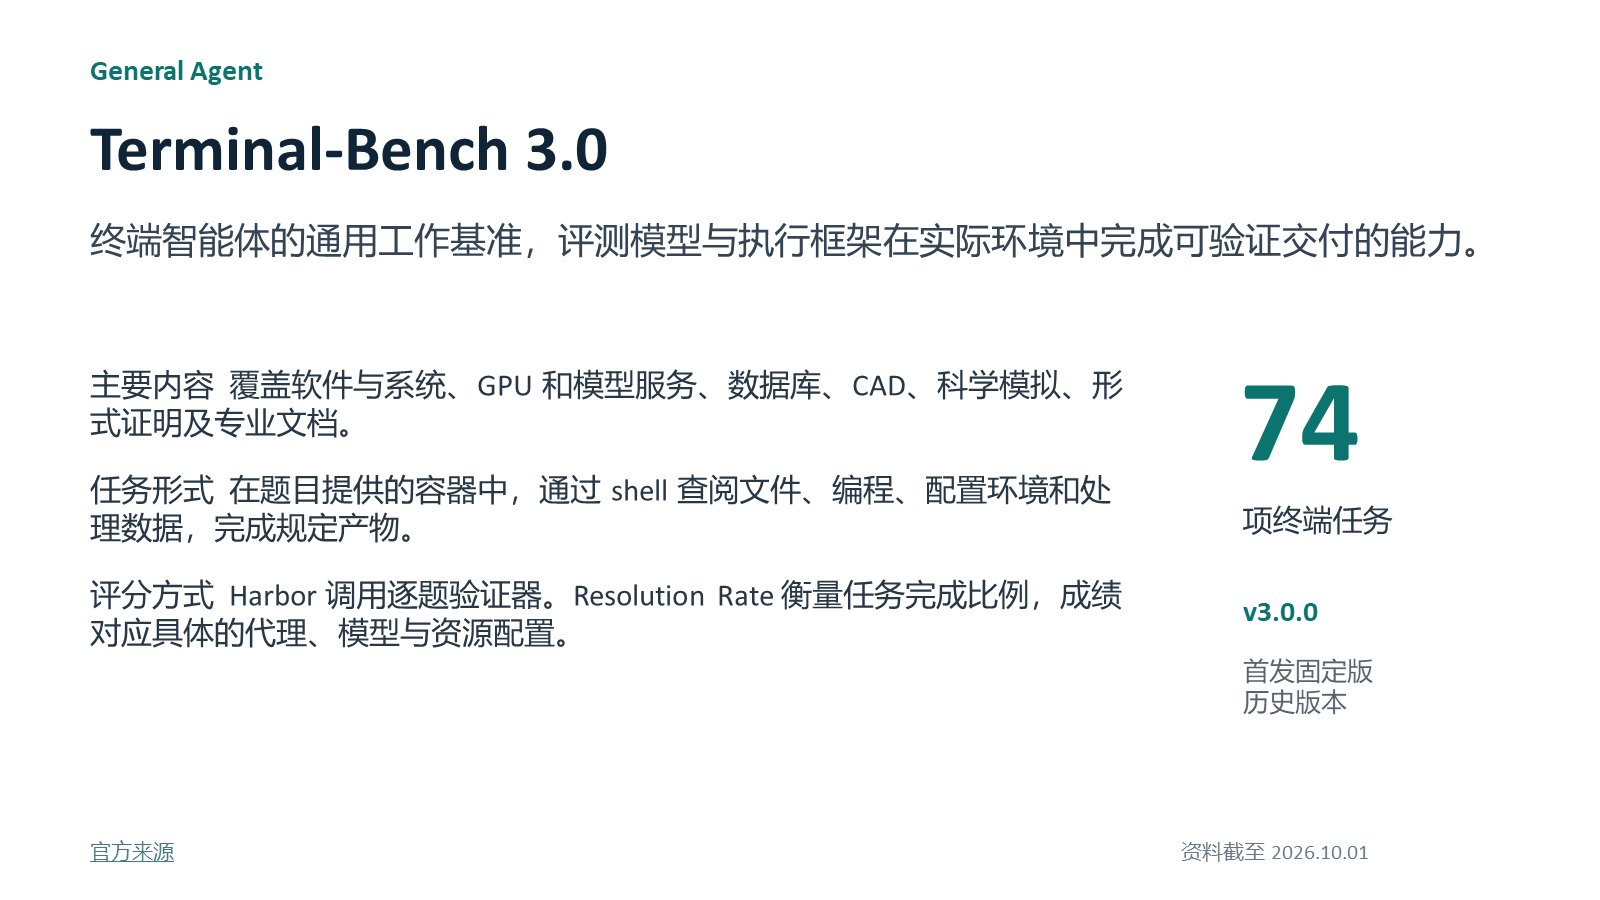
第一,环境能否重置和重放。同一个任务,评测跑一次、训练跑一万次,环境都要能回到初始状态。Terminal-Bench 在 Harbor 框架下给每道终端任务配逐题验证器;我们交付 ALE 类任务时,每项任务配一个独立可启动的 Docker 环境和一个独立评分器,按 Harbor 任务格式交付,每条数据带审核 oracle。我们交付虚拟机类任务时给的是标准化镜像:Windows 11 企业版或 Ubuntu 24.04,单镜像 60G,桌面操作数据由真实人类在镜像里完成任务产生,带任务指令、界面状态和操作轨迹,7 个工作日交付。
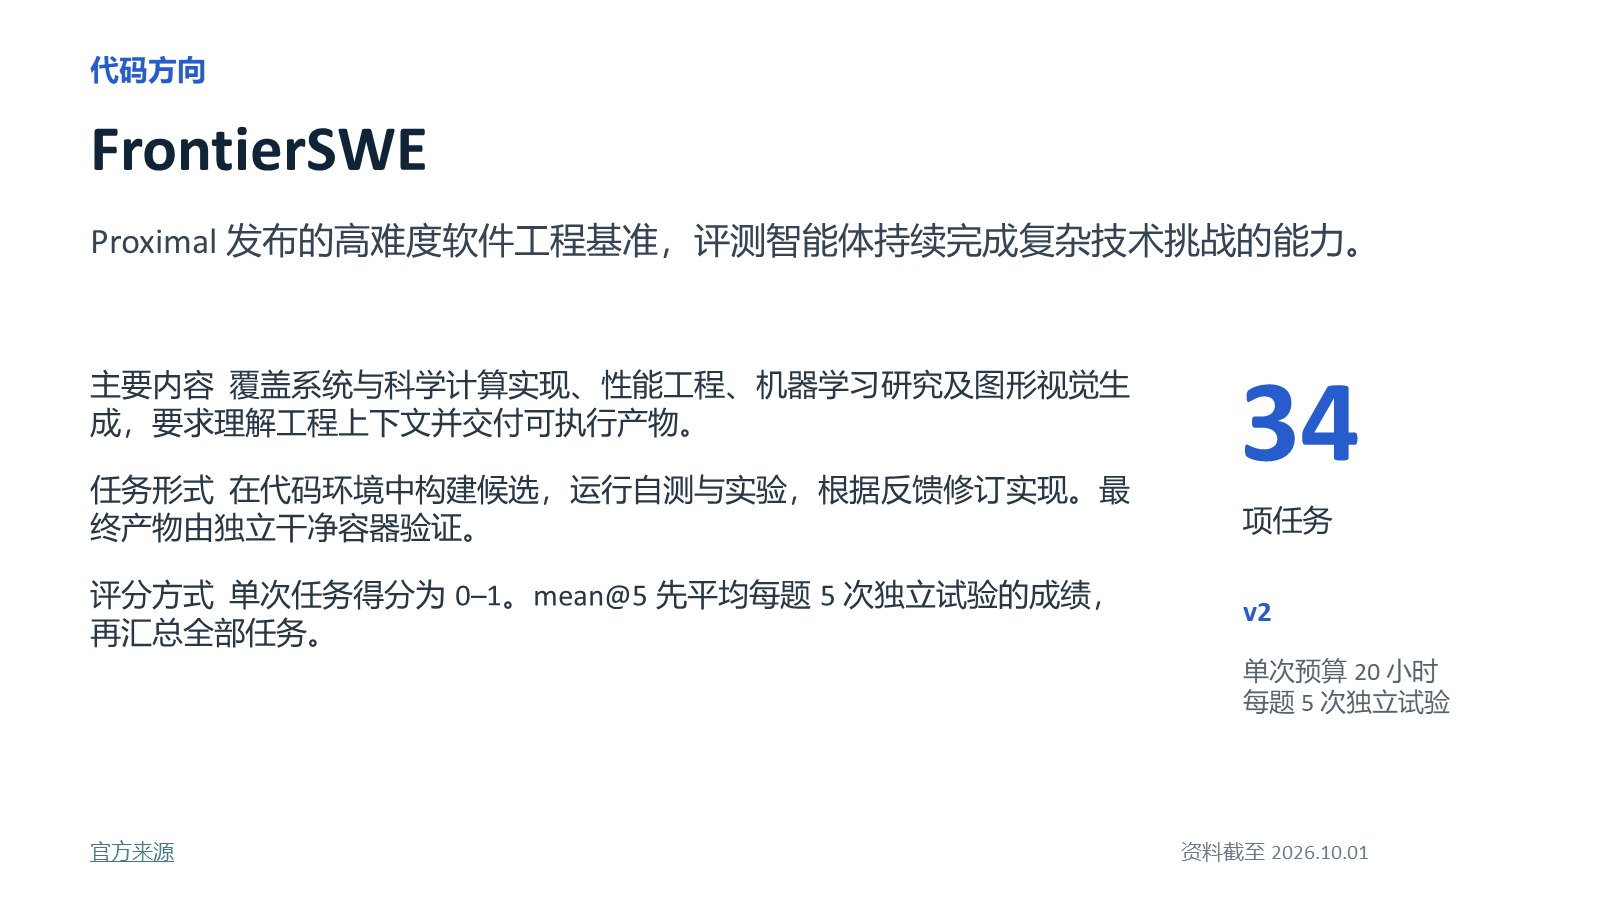
第二,防不防 reward hacking。验证环境里如果预置了答案文件、残留了上一次的运行状态,模型可能学到作弊路径。DeepSWE 的做法是把提交抽成 patch 放进干净容器重放;FrontierSWE 的验证器从固定镜像重新启动,文件系统干净。评估供应商时可以直接问两个问题:验证环境怎么保证干净;超时和上下文超限算不算失败。
第三,产能是不是流水线。环境化的直接结果是可以批量。我们代码类和智能体类任务的主流交付口径是每周 200 题、7 个工作日。这个产能口径依赖标准化环境:没有可重置的环境,这个数字撑不住。
Terminal-Bench 从 3.0 到 4.0 的更新值得单独看:74 题砍到 66 题,移除的 8 题里,2 题模型饱和、2 题模型直接拒答、2 题存在公开解法、2 题有质量或平台兼容问题,另修 19 题,并声明属于破坏性变更,3.0 的成绩要在 4.0 上重跑。公开头部基准自己在周期性换血,供应商交付的同类任务也需要同样的复验机制。采购时可以问一句:题库多久复验一次,复验不过的题怎么处理。
06维度四:反馈回流——任务从哪来,失败数据回不回得来
这一维决定数据的天花板。凭空编的任务测得出格式能力,测不出真实工作的复杂度;真实任务的两个来源,是客户场景和公开基准的同类原创再生产。反馈回流说的是另一件事:模型在这些任务上失败之后,失败现场能不能被采集回来,变成下一轮训练数据。
我们拿得出手的证据是具身智能这条线。某头部具身智能厂商提供真机数据,我们做 grounding QA(3 万条,含机器轨迹、2D 投影坐标、bbox 投影、场景描述、本体感知与运动感知)和 grounding 标注(30 万帧的 bbox 与 mask 精确标注);某高校实验室的具身导航项目,我们交付了 100 万条多模态大模型 SFT 数据和 80 万条 DAgger 后训练数据,周期 45 个工作日。DAgger 这类方法本身就是一种回流机制:让模型先跑,把跑偏的状态采集回来重新标注,用新数据继续训练。任务的来源是真机,不是合成。
这一维的边界同样说清楚:我们没有自营产品在持续产生反馈数据,回流主要发生在客户项目内部。这一维我们能给的证据是「任务来源真实+有回流方法」,给不出的是「自营场景持续产生数据」。如果采购把这一维当硬指标,正确的验证方式不是听任何一家供应商讲回流故事,而是要求看任务的真实来源材料,并在 POC 里检查任务和真实工作流的距离。
07证据分级与采购动作
四个维度看完,供应商给出的东西可以分成三档。第一档是自述指标:专家注册数、题库总量、模糊的客户说法,这些不构成证据,只构成线索。第二档是可出示的物证:任务样本、参考答案与证据索引、质检报告、验证器代码、环境镜像,这些可以逐份检查。第三档是可复跑的实测:在采购方指定或认可的模型上,按约定口径跑对比,这是三档里唯一无法靠讲述获得的一档。
对应的采购动作是现在业内已经在收敛的做法:小规模真实 POC,采购方自己保留的隐藏测试集,对数据来源与授权链的审查。我们欢迎这两样东西,因为可复跑的证据对我们有利。这也是我们敢把这四个维度写成评估清单的原因。
08一份可以直接用的自查清单
| 维度 | 自查项 | 不通过的表现 |
|---|---|---|
| 专家网络 | 专家是否自己命题、写参考答案与评分标准 | 专家只给模型产出打分 |
| 专家网络 | 参考答案的每个结论能否追到输入材料 | 质检无法区分推导和补写 |
| 专家网络 | 交付前是否有独立于命题人的质检 | 专家自审即终审 |
| 测量科学 | 答对与否能否由程序或逐条标准判定 | 模型裁判给印象分 |
| 测量科学 | 难度声明是否带模型名、对比对象、指标名 | 只有「更难」的说法 |
| 测量科学 | 题目是否做过可检索性筛查 | 分数混入记忆和污染 |
| 执行环境 | 每条任务是否带可启动环境与独立验证器 | 交付一份样本文件 |
| 执行环境 | 验证环境是否干净,超时是否算失败 | 存在作弊路径 |
| 执行环境 | 产能口径是否可持续 | 一次性交付,无法续供 |
| 反馈回流 | 任务来源是否为真实工作 | 凭空编造的任务 |
| 反馈回流 | 失败数据能否采集回训练 | 失败现场直接丢弃 |
| 采购动作 | 是否先跑小 POC 加隐藏测试集 | 用一次性大单赌自述指标 |
09总结
四个维度可以分成两组。专家网络和测量科学决定题好不好:命题质量决定上限,可复跑的判定决定分数有没有意义。执行环境和反馈回流决定能不能规模化用起来:环境化让数据接得进训练流程,真实来源和回流机制决定这批数据之后还能不能继续长。
落到采购动作,每个维度向供应商要一样东西:专家网络要命题样本和质检报告,测量科学要带口径的实测对比,执行环境要环境试跑,反馈回流要任务来源说明。四样都拿得出,再谈批量;拿不出的维度,用 POC 和隐藏测试集补验。
我们自己也是供应商,这篇清单列的每条证据标准,都欢迎拿来检验我们。
10我们做过类似的
| 案例 | 做了什么 | 规模 | 周期 |
|---|---|---|---|
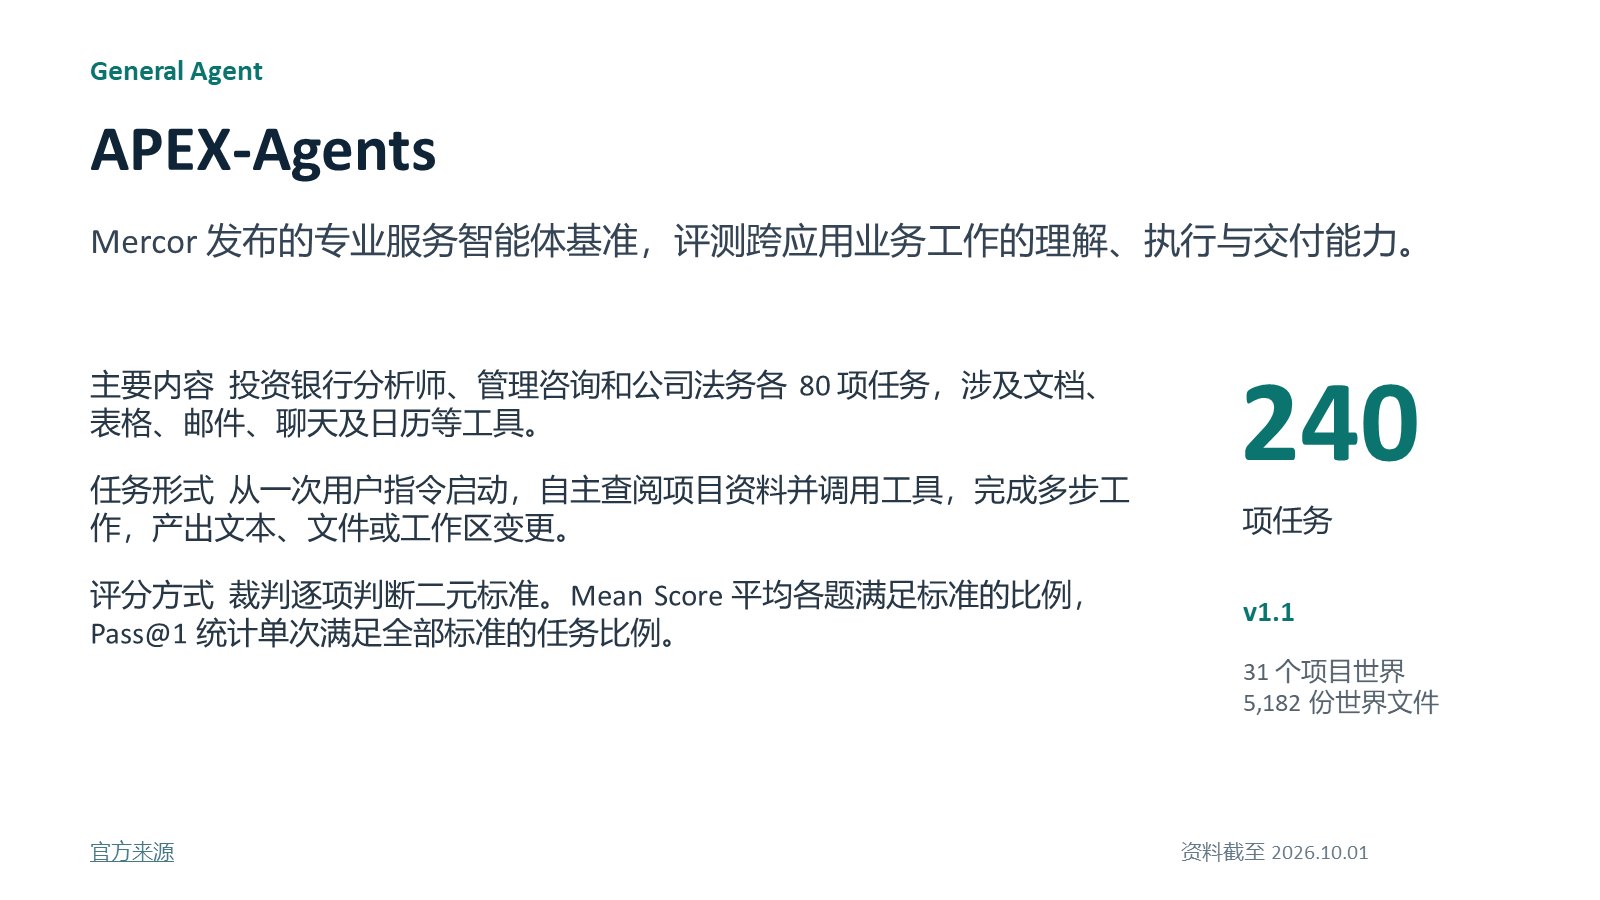
| HLE-Math / Physics / Chemistry | 竞赛教练团队全新命制的严格多模态专家题,数学走形式化求解器验证,物理化学走多模型交叉加双盲复核 | 单科 1,000–2,000 题 | 3 个工作日 |
| Deep SWE 类代码任务 | 真实仓库、真实功能验证器与参考解,干净容器重放验证 | 200 题/周 | 7 个工作日 |
| ALE(Agents' Last Exam)类任务 | 专家生产,每题独立 Docker 环境与独立评分器,Harbor 格式 | 200 题/周 | 7 个工作日 |
| Windows / Ubuntu 虚拟机镜像 | 标准化镜像,真实人类桌面操作轨迹数据 | 单镜像 60G | 7 个工作日 |
| 具身智能四项 | 真机数据的 grounding QA、bbox/mask 标注、导航 SFT 与 DAgger 后训练数据 | 3 万条 QA / 30 万帧 / 100 万条 SFT / 80 万条 | 45 个工作日 |
| 行业专家任务包 | 医疗、法律、金融执业专家命题,含干扰文件、参考交付物、证据索引与 Rubrics,交付前过矛盾性质检 | 按行业与项目定制 | 按项目约定 |
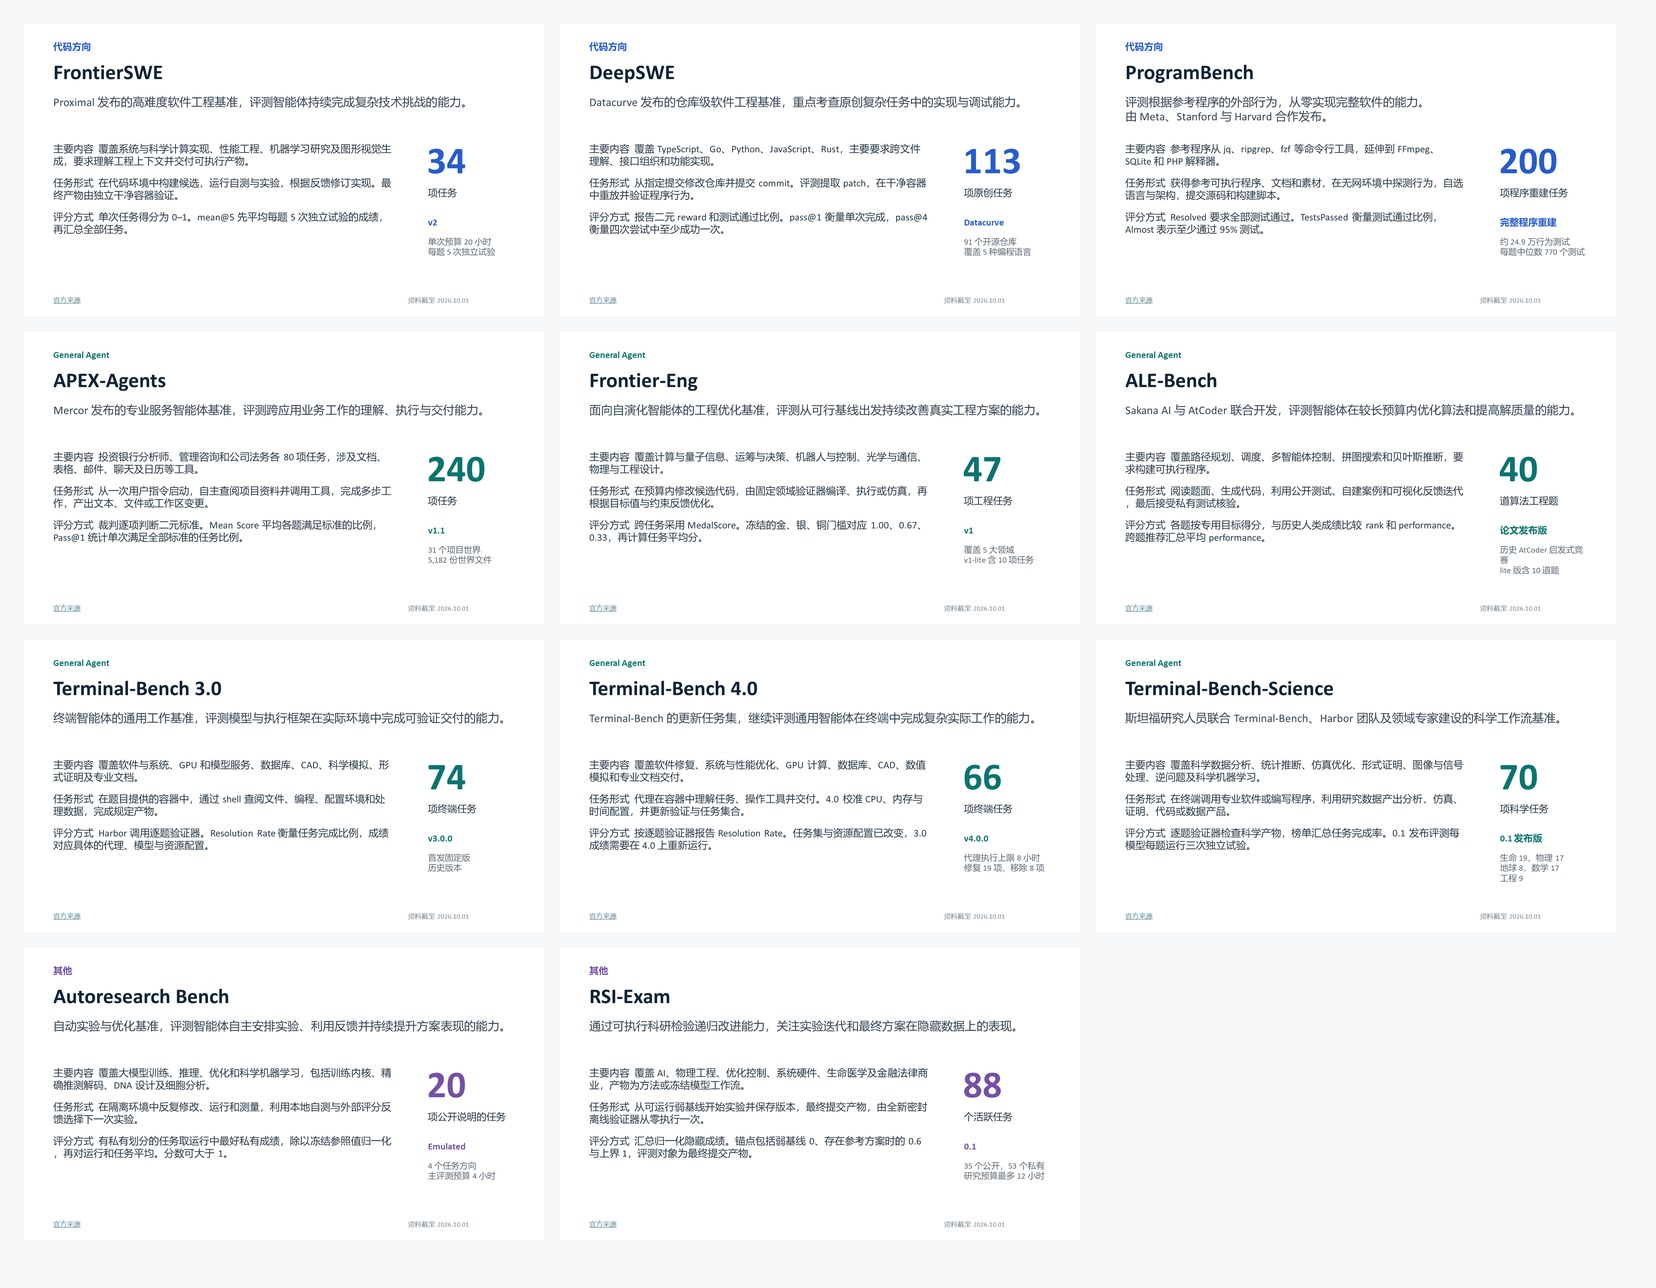
我们做的事是:DataMining(datamining.cloud)为大模型与智能体研发提供原创任务数据,覆盖代码、复杂推理、多模态与智能体任务,按 ALE-Bench、Frontier-Eng、HLE、Frontier SWE、Deep SWE、Program Bench、APEX Agents 等基准的能力要求构建同类原创任务。代码数据是核心,在 Deep SWE 类任务上,GPT-5.6-sol 在我们数据上的准确率比其他同类供应商的同类数据低约 15 个百分点,智能体推理轨迹长约 20 轮。
需要样例数据、评测集清单或定制方案,联系团队:contact@datamining.cloud