让 5 个 Agent 自己造 RL 训练数据,全员不及格
让 Agent 自己写训练数据,是目前自动化数据合成最想打通的一环。开源基准 AutoDataBench 把 5 个 agent 放上考场,最高分不到 0.2。
当下行业常谈递归自我改进(RSI)与数据飞轮。让 Agent 自己生产训练数据,是这套叙事里的关键一环。开源基准 AutoDataBench(GitHub 仓库 StarDewXXX/AutoDataBench)近期做了一组实测。让 5 个 agent 生产强化学习训练任务,覆盖 terminal-bench、tb-science、automationbench 3 个领域的 24 道原任务。结果显示,在满分 1 分的机制下,5 个 agent 的总分没有一个超过 0.2:最高 kimi-k3 0.184,gpt-5.6-sol 0.177,qwen3.8-max 0.139,glm-5.3 0.130,最低 deepseek-v4-pro 0.097——这组数据直接给全自动数据合成泼了一盆冷水。大厂在采购、自建 RL 任务数据集时,需要正视这个结论:依靠 Agent 全自动产出任务,暂时还达不到可用的交付标准。
01AutoDataBench 在测什么
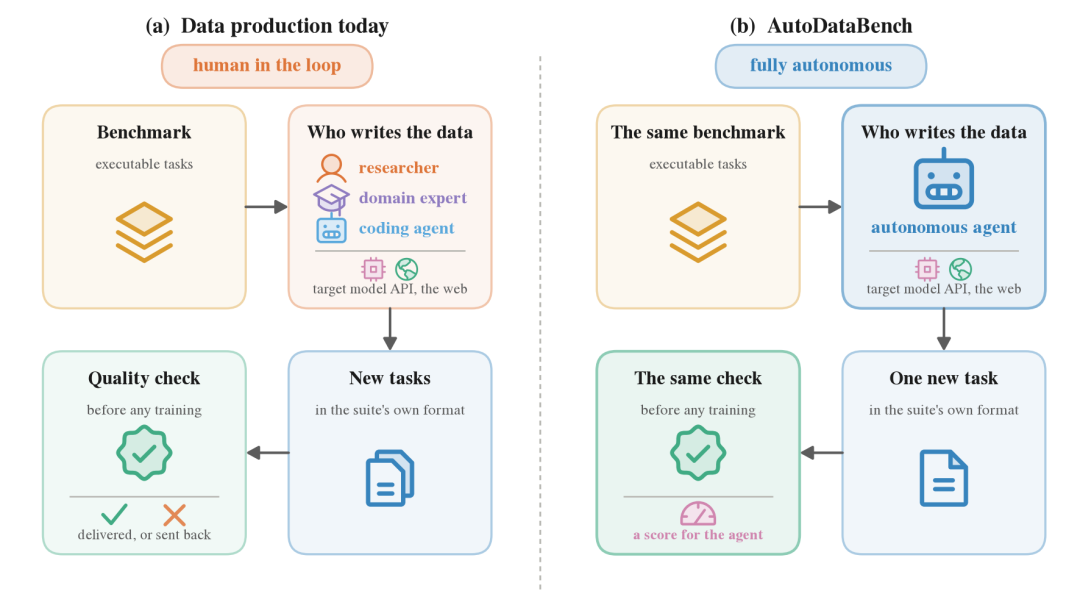
AutoDataBench 测的是一件事:让被评测的 agent 替代人类数据团队,为 agent 强化学习生产新的训练任务。agent RL 的数据单位不是文本对,是任务。一个完整的任务包含可执行环境、验证器,以及匹配目标模型的难度。
整套评测链路定义了四类独立角色:目标模型、被测 Agent、分析师、评审。
- 目标模型:待训练对象,本次实验固定为 deepseek-v4-pro;
- 被测 Agent:数据生产方,读取原任务与目标模型失败记录,构造新任务环境和验证脚本;
- 分析师:负责前置归因,从目标模型 6 次尝试轨迹中提炼保密的隐藏 rubric,标记出错的决策节点与错误方式;
- 评审:等被测 Agent 交付新任务后,负责执行验证并打分。
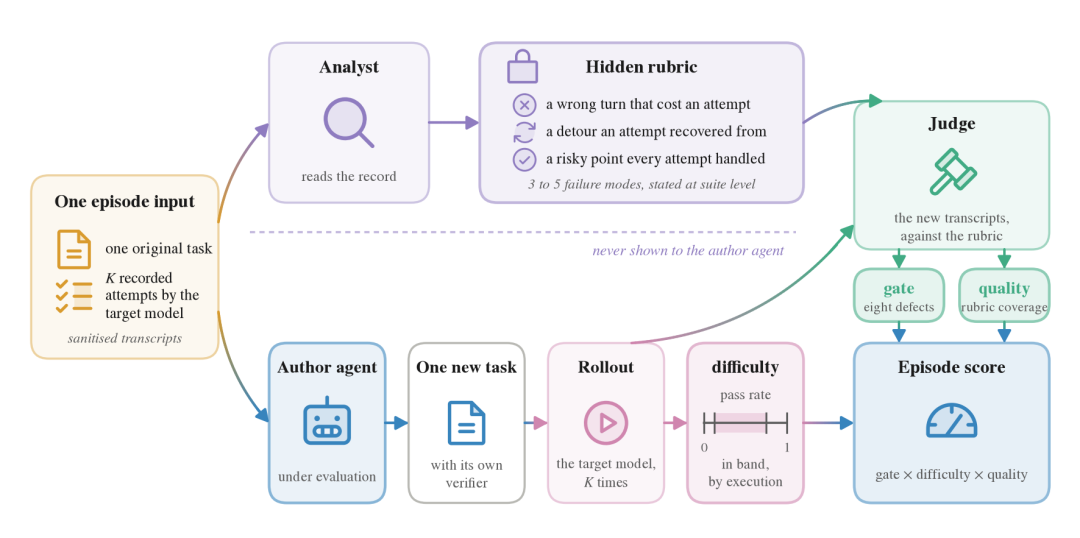
这套基准的评分公式为 score = gate × difficulty × quality,任一项为零总分即零。文档明确说明:该指标是产物代理指标,无法预先证明单条任务一定对 RL 训练增益;但作为工程上的数据验收标准,这套设计直击痛点。
gate:7 项规则,命中即 game over
gate 是准入关卡,包含 7 种致命问题:验证器失效、答案泄露、任务无解、换皮改写、抄袭、越权调用外部模型、无有效任务。其中换皮是最高频错误,也就是只替换名词、不改动问题本质。测试 harness 会先做文本 diff 自动筛查,规避这类问题。过往实验已经证明,仅靠人工评审很难识别高文本重合的换皮任务,自动化前置拦截是必要手段。
difficulty:难度看实测通过率
难度不依靠主观标注,由目标模型多次运行的求解比例决定。通过率必须落在指定区间。全对意味着模型已经掌握,没有梯度信号;全错意味着超出当前能力边界,采样不到正例轨迹。
quality:从执行轨迹里找证据
quality 评估新任务能不能命中 rubric 里记录的原有错误模式。评审不能只看题干,必须从模型真实执行轨迹中找到证据,确认任务能够触发对应的决策错误,才算有效覆盖。
02失败出在难度两端
5 个被测 agent 在 24 道原任务上的总分全部低于 0.2。拆解这三项相乘的得分细项,可以定位自动化造数据的真正瓶颈。
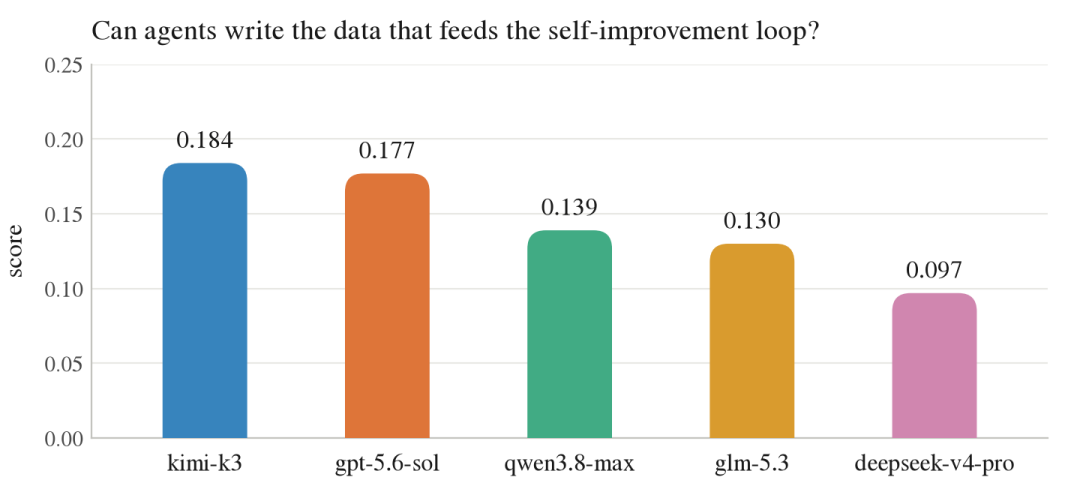
做归因分解会发现,被测 agent 的 rubric 覆盖接近饱和,失败集中在 difficulty 两端。需要说明样本边界:这个结果基于 24 道原任务、单一目标模型,规模不大,但归因结构说得清楚。
这说明在 quality 维度,当前主流模型的能力并不弱。只要给到目标模型在原任务上 6 轮尝试的完整失败轨迹,被测 Agent 可以识别出目标模型出错的决策节点,并围绕该错误点设计对应的考察逻辑。真正的卡点,是把考察逻辑落地成可执行环境、配套验证脚本之后,Agent 无法稳定控制任务的实际难度。最终产出的新任务,交给目标模型实测 rollout,要么稳定全过,要么稳定全失败,两种情况都不适合作为 RL 训练样本。
识别模型的错误特征,只是静态文本理解;控制任务难度,属于动态系统层面的工程问题。在终端操作、科学计算、自动化这类 Agent RL 场景里,难度并不由题干文字单独决定,而是由环境依赖、工具反馈、状态空间规模、容错边界共同决定。
被测 Agent 在构造任务时存在两种典型倾向。为了保证自己编写的验证脚本可以正常运行,它常会简化环境配置、在提示词中预埋大量线索,任务难度随之走低,目标模型稳定答对,difficulty 直接归零。反过来,如果 Agent 主动提升复杂度,叠加多轮文件操作、引入复杂依赖,又很容易埋下隐性问题:环境死锁、依赖缺失、边界条件遗漏;或是任务链路过长,超出目标模型的规划与上下文上限,导致目标模型完全无法完成,difficulty 同样失效。
自动化造题 Agent 缺少一套闭环机制:在任务生成阶段高频调用目标模型做真实 rollout,再根据执行反馈持续调整环境阻力。缺少真实试错来标定难度,生成结果就会持续向 “全对” 和 “全错” 两个极端收敛。
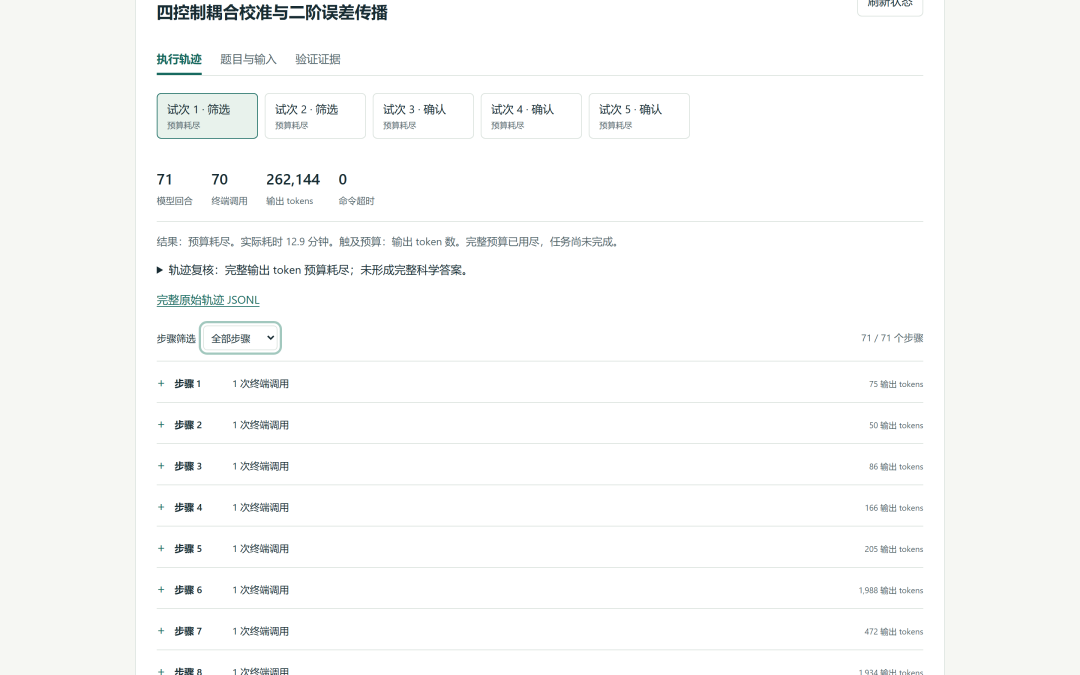
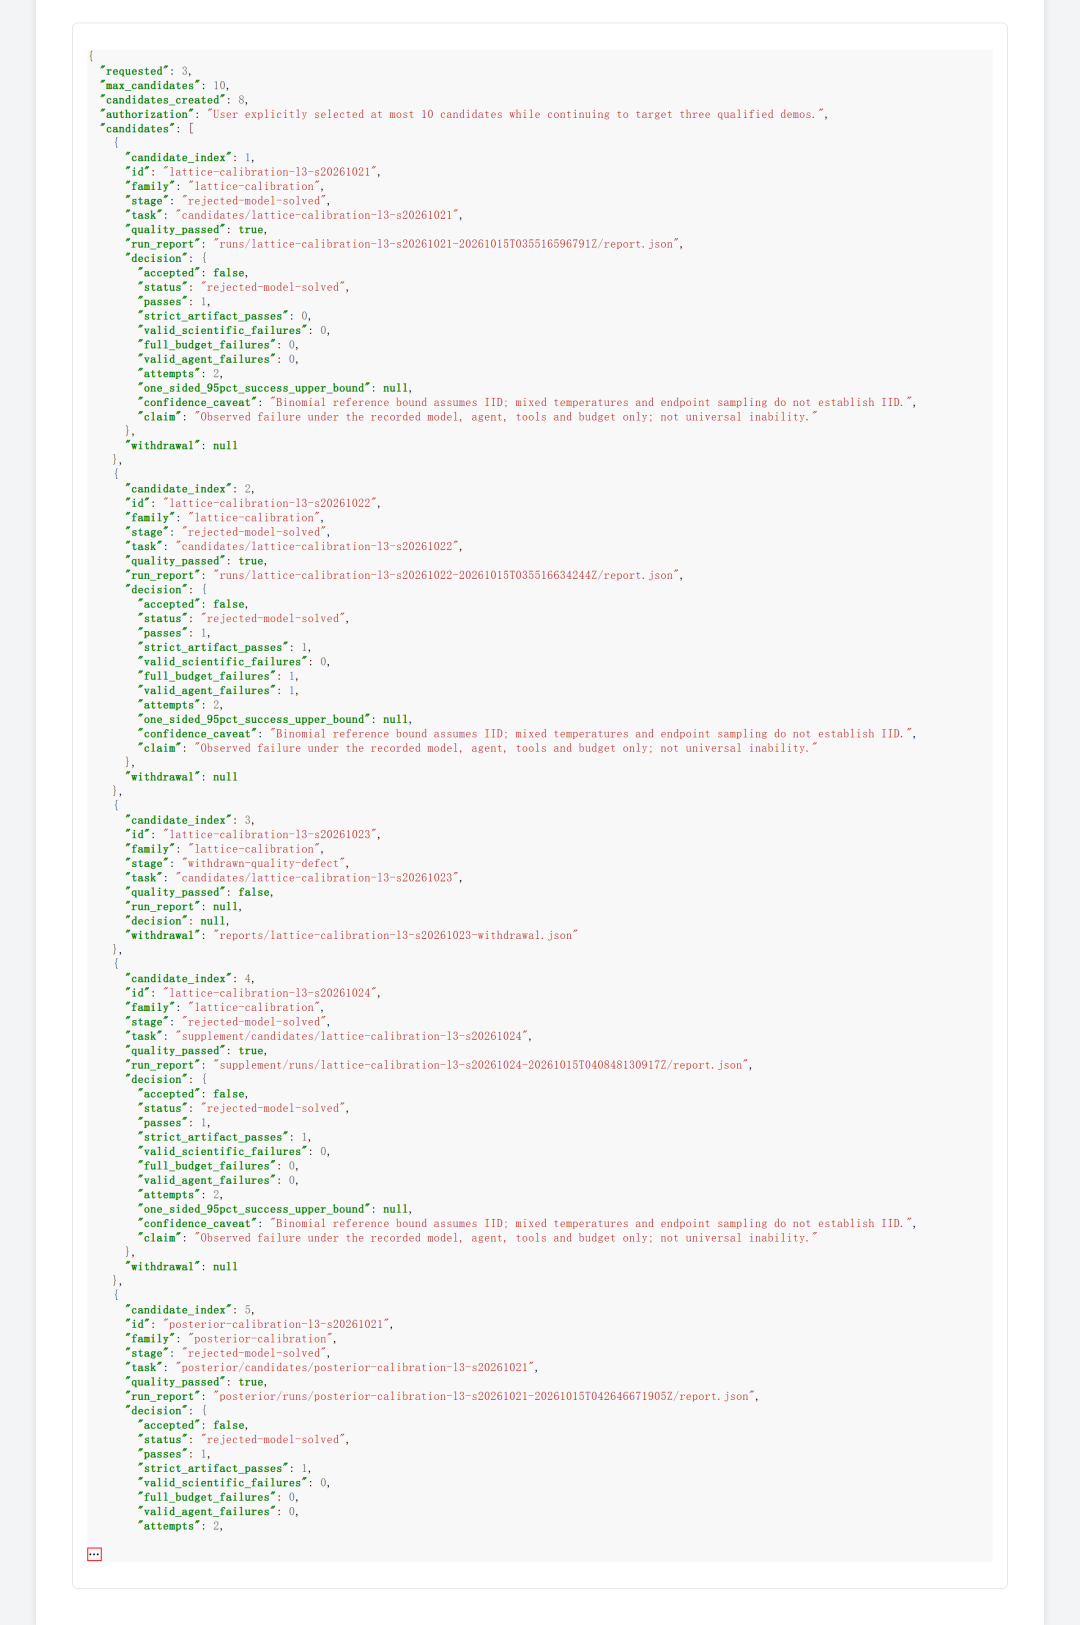
【交付实证:tbs 科学计算任务】 任务卡在难度两端不是评测基准里的特殊现象,而是我们每天都在处理的日常。在我们近期完成的 tbs 科学计算任务交付中,目标模型 DeepSeek-V4-Flash-Vision-Exp 在单题上连续 5 次尝试全部预算耗尽(测试配置为 80 步上限、26.2 万输出 tokens、1800 秒、温度 0 与 0.6 混合);按此单侧估计,95% 置信的成功率上界为 45.1%;轨迹查看器实录单题 71 个模型回合。这批交付任务是从 8 个候选里筛出 3 道,落选任务的证据全部保留,其中 1 道因参考答案漏计主动撤回。把任务难度精准卡在预算耗尽边缘且确保题目绝对可解,靠的就是高密度的真实跑测与淘汰。
03拆解打分逻辑:大厂采购真正的验收条件
AutoDataBench 的 gate/difficulty/quality 三项,刚好和我们做 RL 任务数据交付时的验收逻辑对齐。
gate 对应的,是交付物最基础的准入底线。防换皮抄袭、防答案泄露、任务可复现、全链路可溯源,是工业级数据包的硬性门槛。不少采购方会把验收规则分成三级,Must pass 项只要有一项不满足,整批数据直接失效。
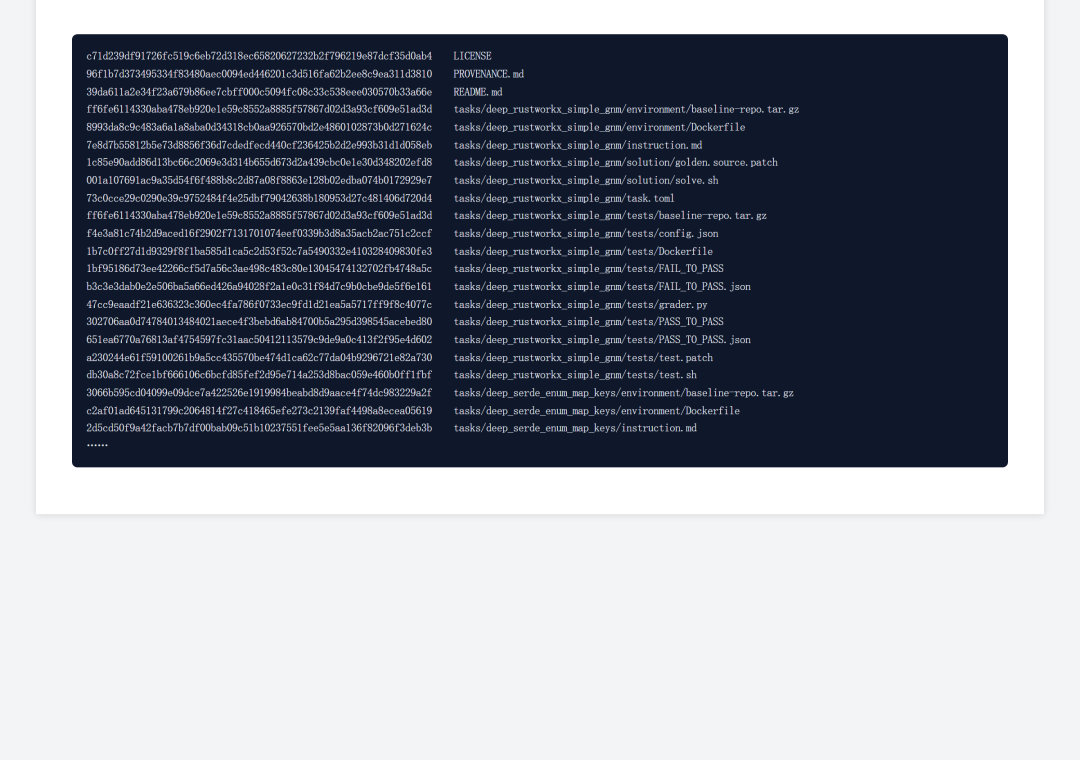
所以给大厂做的数据交付包不能只是零散的 JSON 文件,必须是一套经过完整校验的工程制品。以我们的 DeepSWE 交付包为例:单包包含 5 个任务、33 个轨迹槽位、27 条有效轨迹;6 条无效轨迹保留 null 字段,不做删除;3 处空补丁明确标注,保证 apply_failed=0;配套全量文件 CRC 校验,附带 SHA256SUMS 清单和 PROVENANCE 溯源文档,完整记录上游数据集 commit、评测器哈希、各个仓库的 base commit。无效记录不隐藏、补丁可以 100% 成功应用、溯源信息精确到哈希,gate 的校验逻辑,就是这样落地到交付流程里。
difficulty 对应的,则是需要多轮实测才能锁定的难度窗口。成熟的采购方,不会直接收下没有经过目标模型真机跑测的合成数据。伯克利 ALE 基准(13 个行业集群、55 个子领域、一千多条任务)的采购需求里,就明确要求 pass@3 至少出现一次非满分;另一版 v2.0 任务规范,额外增加硬性约束:解题步骤≥50 步、SOTA 模型机器评分≤40 分、干扰材料占比不超过 1/3。
想要卡在狭窄的有效难度区间,数据管线必须具备大规模算力调度、多轮真机 rollout 的能力,最终以真实通过率作为判定依据。我们的交付全部采用这套实测口径:DeepSWE 的 5 项任务,用 GPT-5.6-sol (xhigh) 跑 20 次,成功 3 次;FrontierSWE 的 4 道 Go 任务,16 次尝试成功 3 次;两道 CHEMQ 化学题实测 Pass@4=0。只有把模型版本、尝试次数、成功次数全部固定,产出的任务才能直接接入 RL 训练管线。
quality 核心是定向命中模型真实的失败模式。和 AutoDataBench 要求评审从执行轨迹提取证据的思路一致,高质量合成任务,必须瞄准目标模型真实的决策盲区。搭建长程任务时,我们先采集目标模型在种子任务上的完整执行轨迹,由领域专家定位工具调用错误、状态遗忘、逻辑跳步这类具体问题,把错误点做成可自动化核验的检查项,再反向设计环境障碍。
就算是专家主导的纯手工题,也很难一次就调好难度。前面提到的 tbs 科学计算任务,我们从 8 个候选里只留下 3 道;淘汰的 5 道,大多也是难度两极问题:目标模型要么稳定解出,要么完全做不出来。失效机理和 AutoDataBench 里被测 Agent 遇到的问题一模一样。差别只在于,我们的不合格样本会在内部质检阶段直接筛掉,驳回理由、rollout 记录全部归档,不会流进最终交付包。
自动化数据合成的瓶颈不在看懂模型弱点,而在于稳定可控的难度标定。在当前技术阶段,领域专家结合真实模型 rollout 的严苛质检仍是刚需。这个自动化 Agent 跨不过去的卡点,也是我们工业化交付里持续处理的常规工作。
如果你在做 RSI、agent 后训练或者长程智能体评测,需要配套的任务环境与数据,联系 contact@datamining.cloud。