大厂到底在买什么数据:拆解主流16套Benchmark评测集资产
数据采购每天都会收到供应商材料,最常见的一句话是「我们能做 XX benchmark 同款」。这句话背后的商品差异极大:同样叫「Deep SWE 同款」,有的是一批题目文件,有的是题目、环境、参考解、验证器的整套,有的连判定脚本都跑不起来。买错了形态,数据接不进训练和评测管线,预算就花在了用不上的东西上。
这篇文章把「同款」拆开。我们对外能力目录里有 16 条资产线:10 条对标公开主流 benchmark,4 条从真实客户场景里长出来,2 条是标准化运行环境产品线。逐条说清楚四件事:对标什么基准、官方口径是什么、买方拿到的交付形态是什么、验收看什么。
我们自己是供应商,这份目录就是我们的货架,拆自己的货架有自卖自夸的嫌疑。所以每条线同时写买家的验收要点,这些要点对所有供应商通用,包括我们。
01先说结论
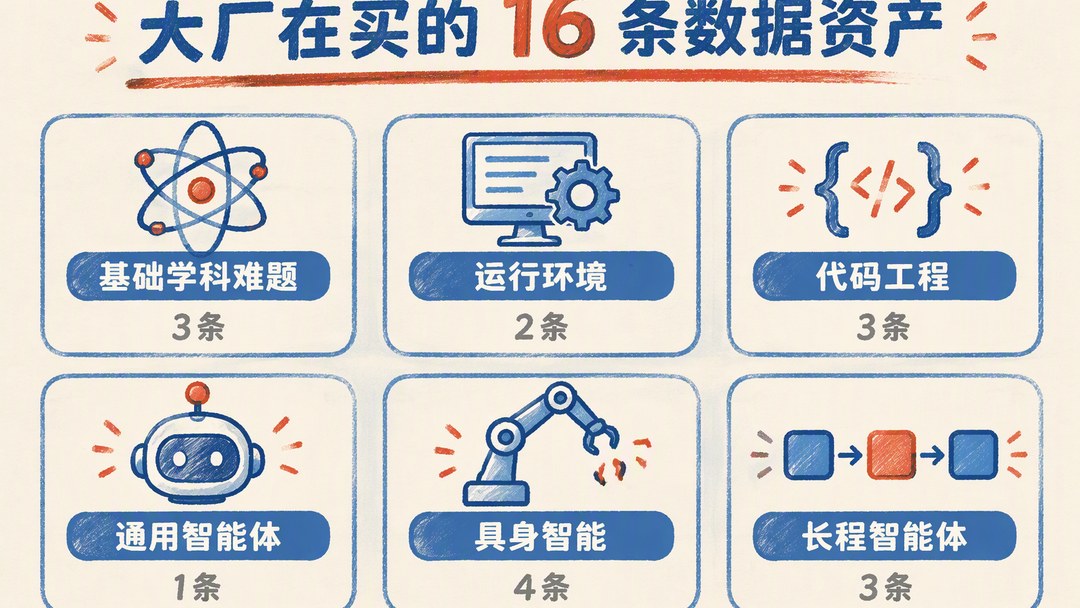
16 条线分六组:基础学科难题(HLE 数学、物理、化学,3 条)、运行环境(Windows 与 Ubuntu 标准化虚拟机镜像,2 条)、代码工程(Frontier-Eng、Deep SWE、Frontier SWE,3 条)、通用智能体(ALE,1 条)、具身智能(grounding QA、grounding 标注、导航 SFT、DAgger 后训练,4 条)、长程智能体(Automation Bench、Toolathlon、Harvey LAB,3 条)。
大厂的钱实际花在三种商品上。第一种是评测任务:题目、参考解、可复跑的验证器打包交付,用来测模型能力。第二种是训练数据:SFT 语料、标注帧、DAgger 纠错数据,用来喂训练。第三种是运行环境:标准化镜像和容器,是前两种能反复使用的基础。报价单上印着同一个 benchmark 名字,先问清是哪一种,再谈价。
每条线还有一个难度分级口径:L1 指与原始数据集类似,规格与评测口径对齐、任务内容原创;L2 指在原始数据集基础上做了进一步改进;L3 指完全超越原始数据集,按其风格全新命制。分级不是宣传词,后面每条线会写它对应的证据。
02一、基础学科难题:HLE 三条线
HLE(Humanity's Last Exam)由 Center for AI Safety(CAIS)与 Scale AI 组织、全球领域专家共建,是公开的高难度多模态学术问答基准。我们对标它的是三条独立产品线:HLE-Math、HLE-Physics、HLE-Chemistry,由竞赛教练团队按 HLE 风格全新命制,严格多模态,在人工命题的基础上搭建了自动化生产管道。难度分级是 L3,交付规模分别是 2,000 题、2,000 题、1,000 题,产能上不封顶,3 个工作日交付。
买方拿到的不只是题目。每条数据的结构是:题目、答案、解析、选项、题目图片、选项图片、Pass@4 评测结果、四轮模型对话及对应判定。质检机制按学科分开:数学题走形式化求解器验证(Z3/SymPy),再叠多模型交叉验证与双盲专家复核;物理和化学走多模型交叉验证加双盲专家复核。判定的客观性靠程序和交叉复核保证,不靠单一标注员。
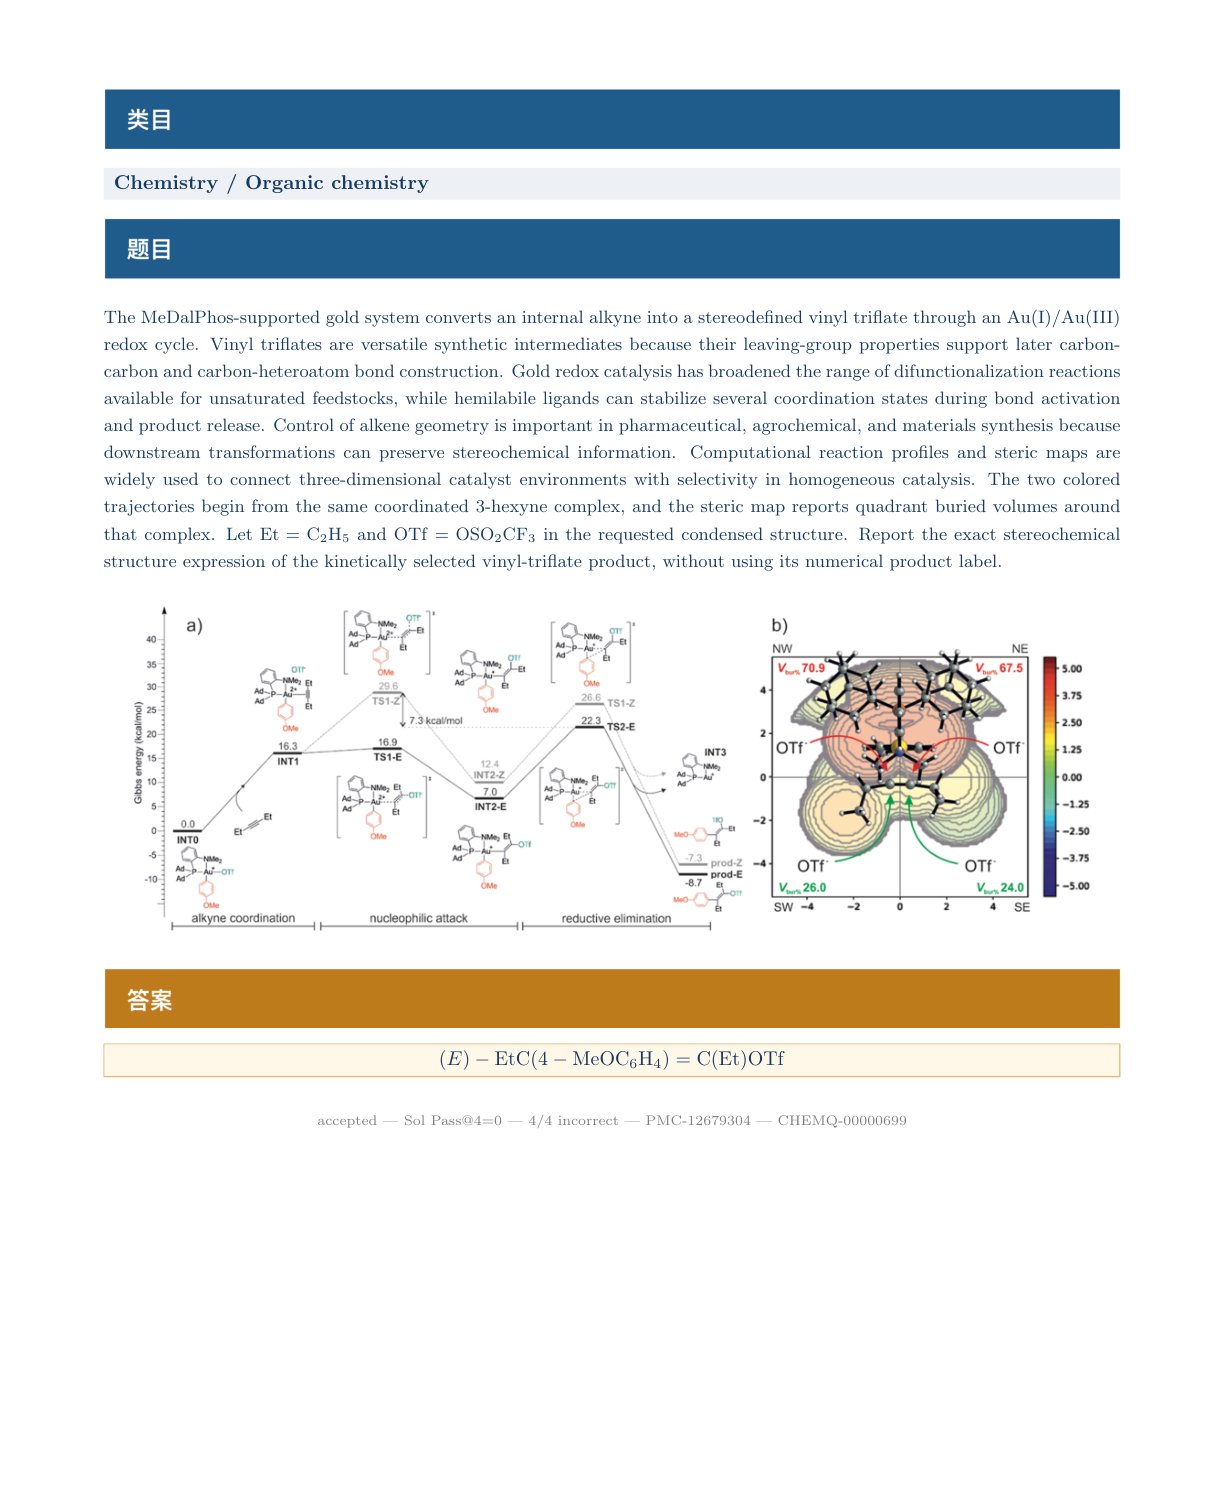
难度证据用一组内部实测说明:在 HLE 方向的内部对照评测中,这批全新命制的数学、物理、化学专家题使 Seed-2.1-pro-0915 的准确率分别提升 4.6、5.3、2.7 个百分点。口径要说清楚:这是我们的内部对照评测结果,该模型不在 HLE 官方榜单上,这组数字只用于说明题目难度区间,不用于任何榜单比较。
验收要点:让供应商出三道样题,检查三件事:题面是否自足(图、参照物、坐标约定都在题面里)、答案是否唯一可判定、解析是否给推导链而不是结论。少任何一件,题目进评测集后都会变成争议题。
03二、运行环境:Windows / Ubuntu 标准化虚拟机镜像
这两条线卖的不是题,是环境。桌面操作类 agent(GUI agent)的训练和评测,都需要一个干净、可重置、规格明确的 Windows 或 Ubuntu 环境,模型在环境里学界面理解、鼠标键盘操作、多步骤任务执行、软件使用与异常纠错。
我们的镜像规格是写死在交付文档里的:Windows 优先 11 企业版、其次 10 企业版;Ubuntu 优先 24.04、其次 22.04。单镜像 60G,保留至少 20G 可用空间,不分片 VMDK,BIOS 启动,命名规则固定。环境里的操作数据由真实人类完成任务产生,包含任务指令、界面状态与操作轨迹,不是脚本合成。7 个工作日交付。
验收要点:镜像能不能恢复出厂状态反复重放;操作轨迹的字段是否完整(指令、界面状态、动作序列、时间戳);虚拟机版本和资源配置有没有写进合同。GUI 数据的价值高度依赖环境标准化,环境含糊,轨迹就没法复现。
04三、代码工程三条线:Frontier-Eng、Deep SWE、Frontier SWE
代码是评测数据里竞争最激烈的一组,三条线对应三种不同的能力测量。
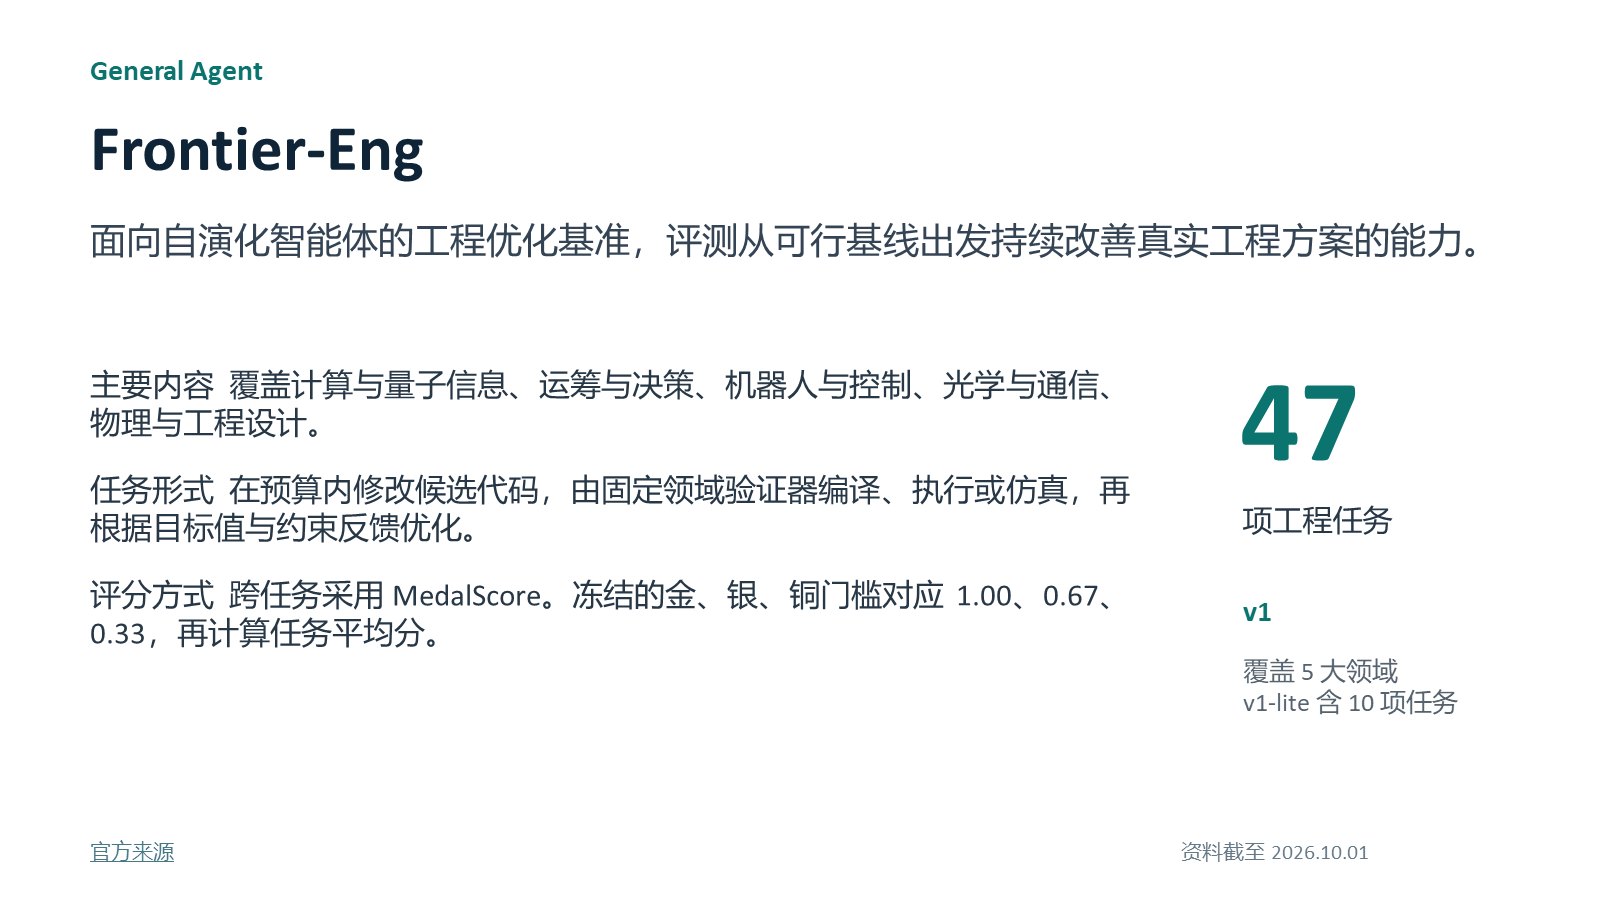
Frontier-Eng(对标基准:github.com/Einsia/Frontier-Engineering)是面向真实工程任务的生成式优化基准,47 个任务覆盖计算与量子信息、运筹与决策科学、机器人控制与能源系统、光学与通信系统、物理科学与工程设计五个领域。模型在固定交互预算内反复生成和修改可执行代码,分数由领域验证器编译执行后按目标值与约束给出;每题的金银铜基线冻结自 v1 快照的前三名 best-feasible 分数,达到各档分别记 1.00、0.67、0.33。我们按同一规格交付同类任务,难度分级 L1。这条线有一个可查的结果:GLM-5 使用我们的 Frontier-Eng 同类任务数据后,在该基准官方榜单冲到第三名。
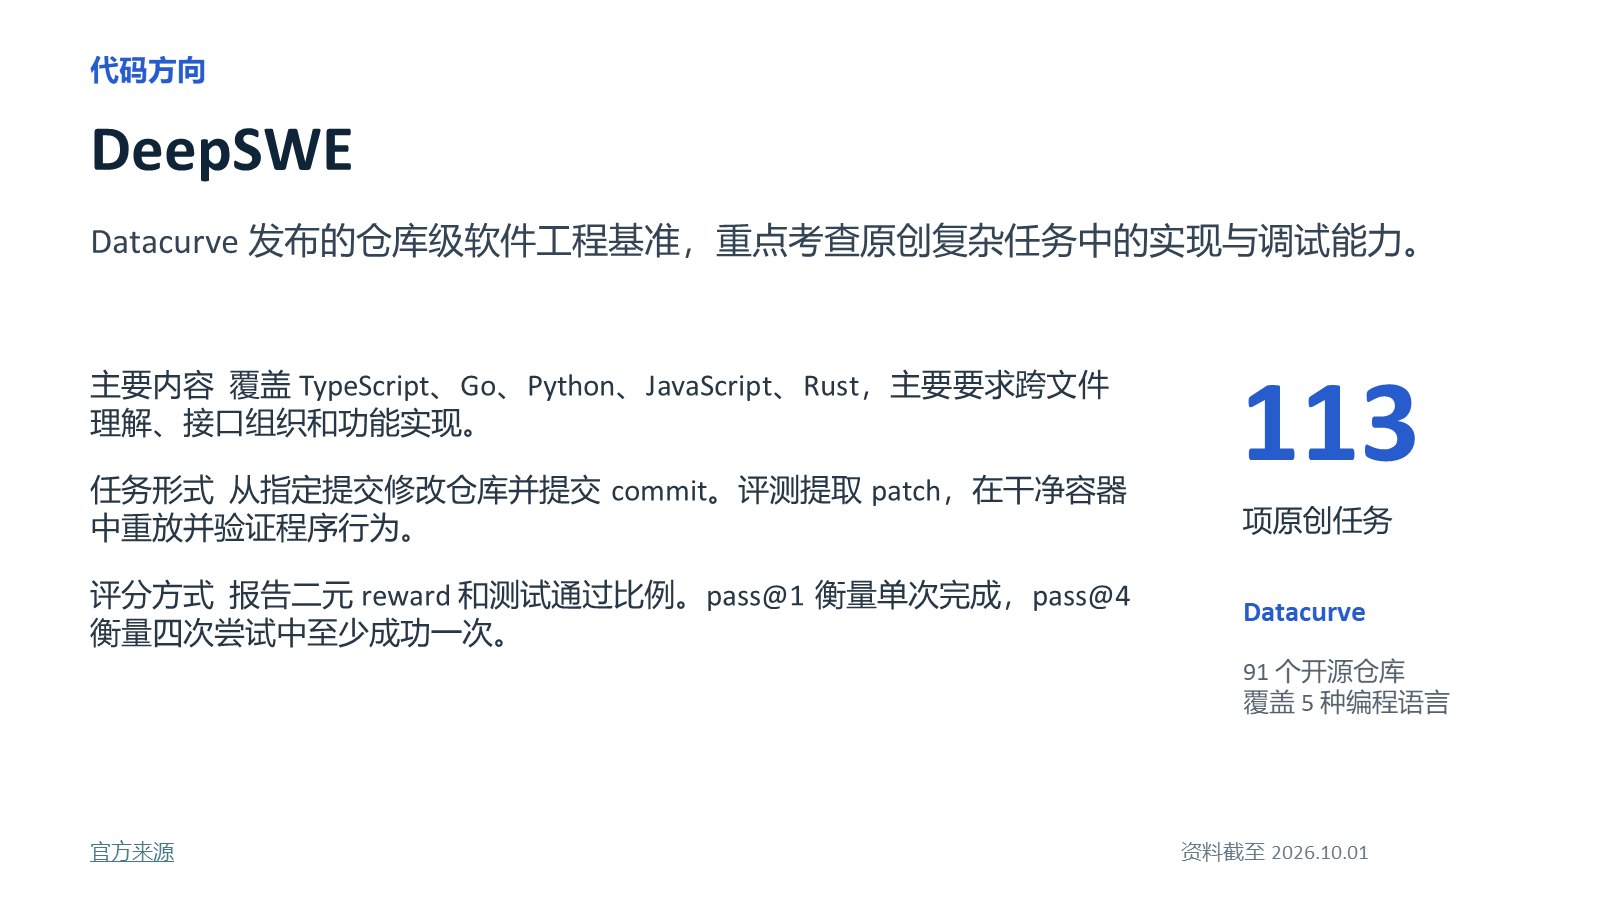
Deep SWE(对标基准:Datacurve 构建,113 个原创任务、91 个活跃开源仓库、5 种编程语言)测的是仓库级长流程修改:模型自主理解代码库、设计方案、完成修改并运行测试。评测时把提交抽成 patch,放进干净容器重放验证,指标是 pass@1 与 pass@4(官方榜单页展示 pass@1,pass@4 见论文口径)。我们按同规格交付同类任务,200 题/周,多模型交叉验证加双盲专家复核。这条线上有两条可对比的实测数字:在 Deep SWE 类任务数据对比中,GPT-5.6-sol 在我们数据上的准确率比其他同类供应商的同类数据低约 15 个百分点,智能体的推理轨迹长约 20 轮。两条数字说的是同一件事:任务把模型推到更长的推理路径上。我们自己的难度标定记录里,GPT-5.6-sol(xhigh)在 5 道 DeepSWE 类仓库任务上成功 3/20——任务难度和模型档位都标在这里。
Frontier SWE(对标基准:Proximal 构建,v2 含 34 个任务)测超长流程编程:任务覆盖系统实现、科学计算、性能优化、视觉推理与 AI 研究五类,每任务提供完整 Linux 环境和 20 小时执行预算,每题跑 5 次独立试验取均值(mean@5),最终产物由确定性自动验证器评估。我们按同规格交付同类任务,难度分级 L1。
验收要点:三条线的共同点是「验证器可复跑」。让供应商演示一次完整评测:拿到提交、抽取 patch、干净容器重放、输出分数。演示不出来,难度声明就只是文字。
05中期案例:DeepSWE 类交付包里的审计数字
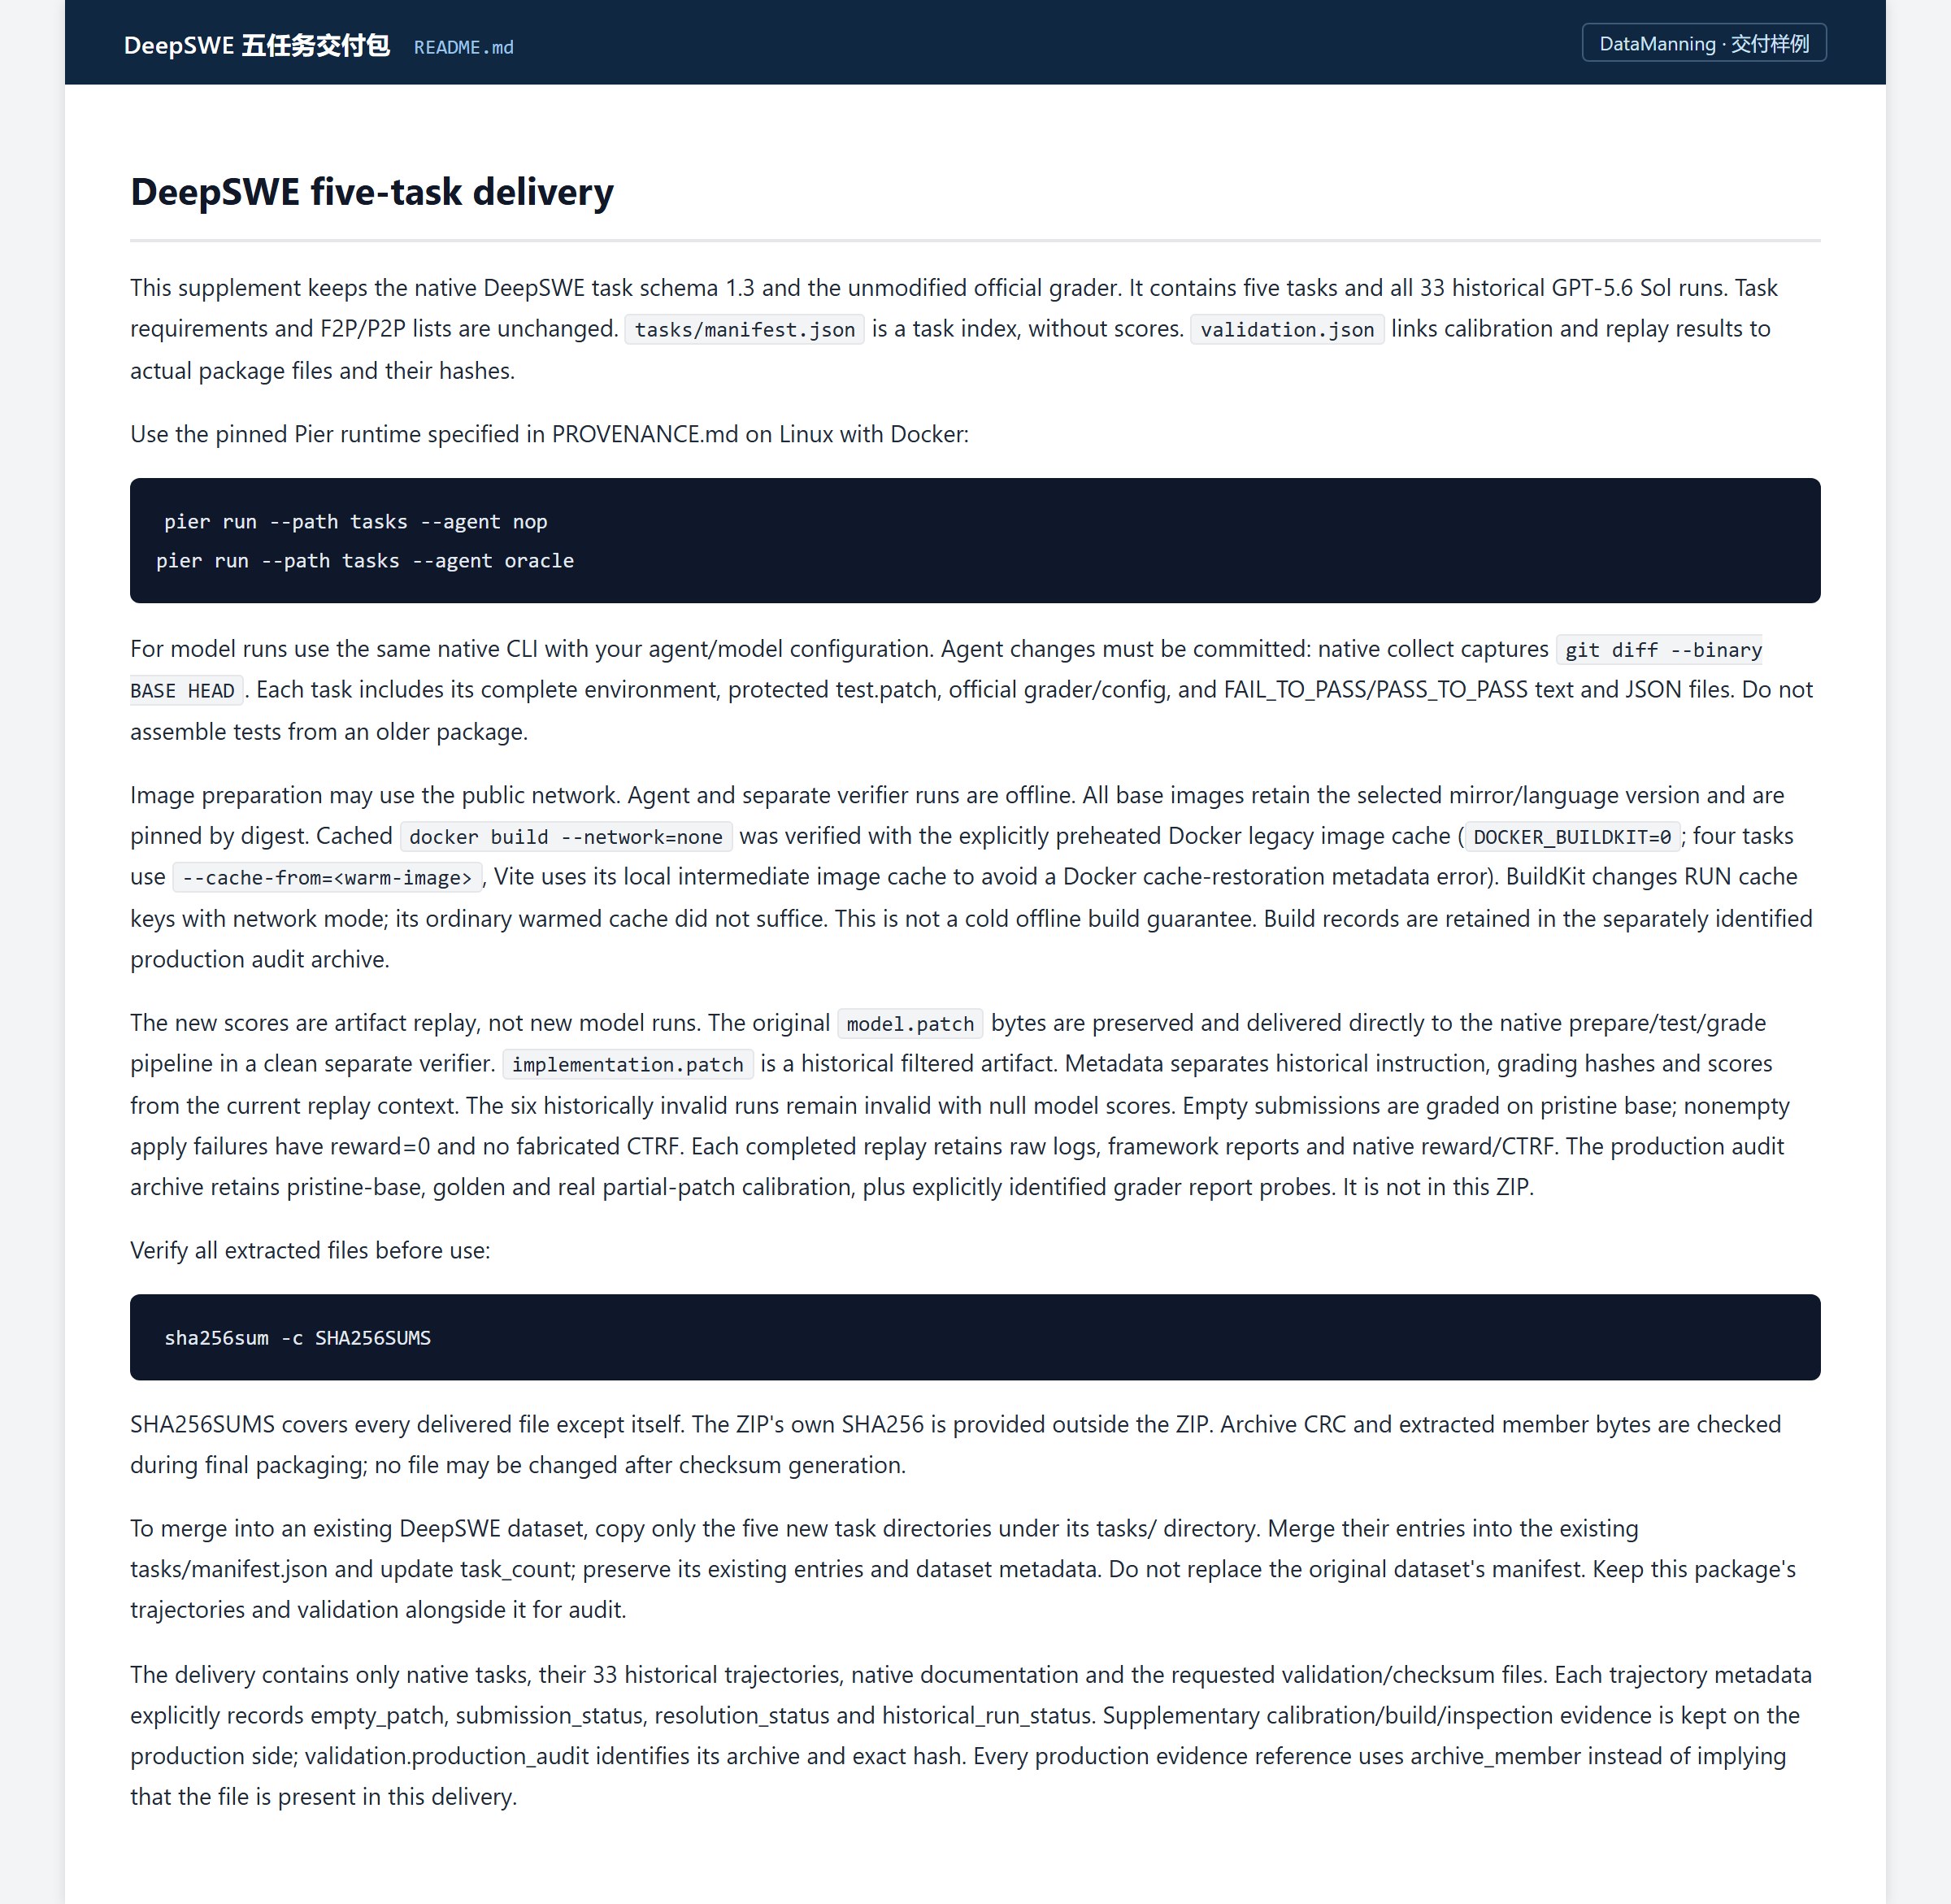
2026 年 10 月我们交付的一个 DeepSWE 类任务包,交付规范做到了逐项可审计:全量 SHA256SUMS 哈希清单;PROVENANCE 文件记录上游数据集 commit、官方 grader 哈希和 5 个仓库的 base commit;validation.json 记录 5 个任务、33 个轨迹槽位、27 条有效轨迹,6 条历史无效运行保持 null 不删除,3 条空补丁如实标注,apply_failed 为 0,CRC 全检通过。 这组数字的意义在失败侧:失败轨迹和空补丁不删除、不改写,验收方可以逐条核对每次运行的真实结果。只交成功样本的供应商,交付的是半份证据。
06四、通用智能体:ALE(Agents' Last Exam)
ALE 由伯克利 RDI 共同组织、250 多位行业专家共同开发,覆盖 13 个行业集群下的 55 个子领域,论文口径为 960 个专家任务工作流、1,490 个任务实例(官方仓库 v1.1 在 30 个任务退役后现存 122 个 active 任务)。它的特点是用真实执业场景的行业专家任务测 agent,而不是用合成办公任务凑规模。
我们交付 ALE 类任务的方式:由专家生产,使用真实、许可允许的专业案例,每题配套可执行参考解与独立评分器,按 Harbor Task 格式交付,每题有独立可启动的 Docker 环境,每条数据配审核 oracle。难度分级 L2(在原始规格基础上做了改进),产能 200 题/周,7 个工作日。
需求侧可以对照看:业内的 ALE 采购需求里,已经把「15 个领域的专家画像」「难度门槛为 pass@3 至少一次不满分」「交付工程结构包加三次独立运行轨迹包」写进了条款。评测数据的采购正在从买题目清单,变成买带验收条款的能力规格。
验收要点:每题的环境能不能独立启动;评分器是不是独立程序;抽样三题,核对参考答案能否从题面和材料重推导。行业专家任务最怕的是「专家写了个结论,但没人能验证结论怎么来的」。
07五、具身智能四条线:从真机数据到 DAgger 回流
具身组的四条线全部从真实客户项目里长出来,数据来源是真机,不是合成。客户方提供真机数据,我们做加工、标注和结构化,整套交付,周期 45 个工作日。
grounding QA(3 万条):面向真实场景采集的机器轨迹,做 2D 投影坐标、bbox 投影坐标、场景描述、本体感知与运动感知的问答对,用于提升多模态模型在真实机器人场景下的 grounding 能力。grounding 标注(30 万帧):对操作目标做 bbox 与 mask 精确标注,走双盲专家复核。两条线的采纳方是同一家头部具身智能厂商。
具身导航 SFT(100 万条):多模态大模型在具身导航任务上的决策能力与空间感知训练数据。DAgger 后训练数据(80 万条):用于导航任务的鲁棒性与纠错能力。两条线的采纳方是某高校实验室。
这组线里值得展开的是 DAgger。它本身就是一种反馈回流机制:让模型先跑,把跑偏的状态采集回来重新标注,用新数据继续训练。四条线合起来,恰好覆盖「感知标注 → 问答理解 → 模仿学习 → 纠错强化」一个完整的具身数据栈,这也是大厂具身团队按阶段采购的顺序。
验收要点:真机数据的来源与采集条件是否可查;标注规范里 bbox 和 mask 的边界情况怎么定义;双盲复核的抽检比例。具身数据的质量问题大多藏在边界情况的定义里。
08六、长程智能体三条线:Automation Bench、Toolathlon、Harvey LAB
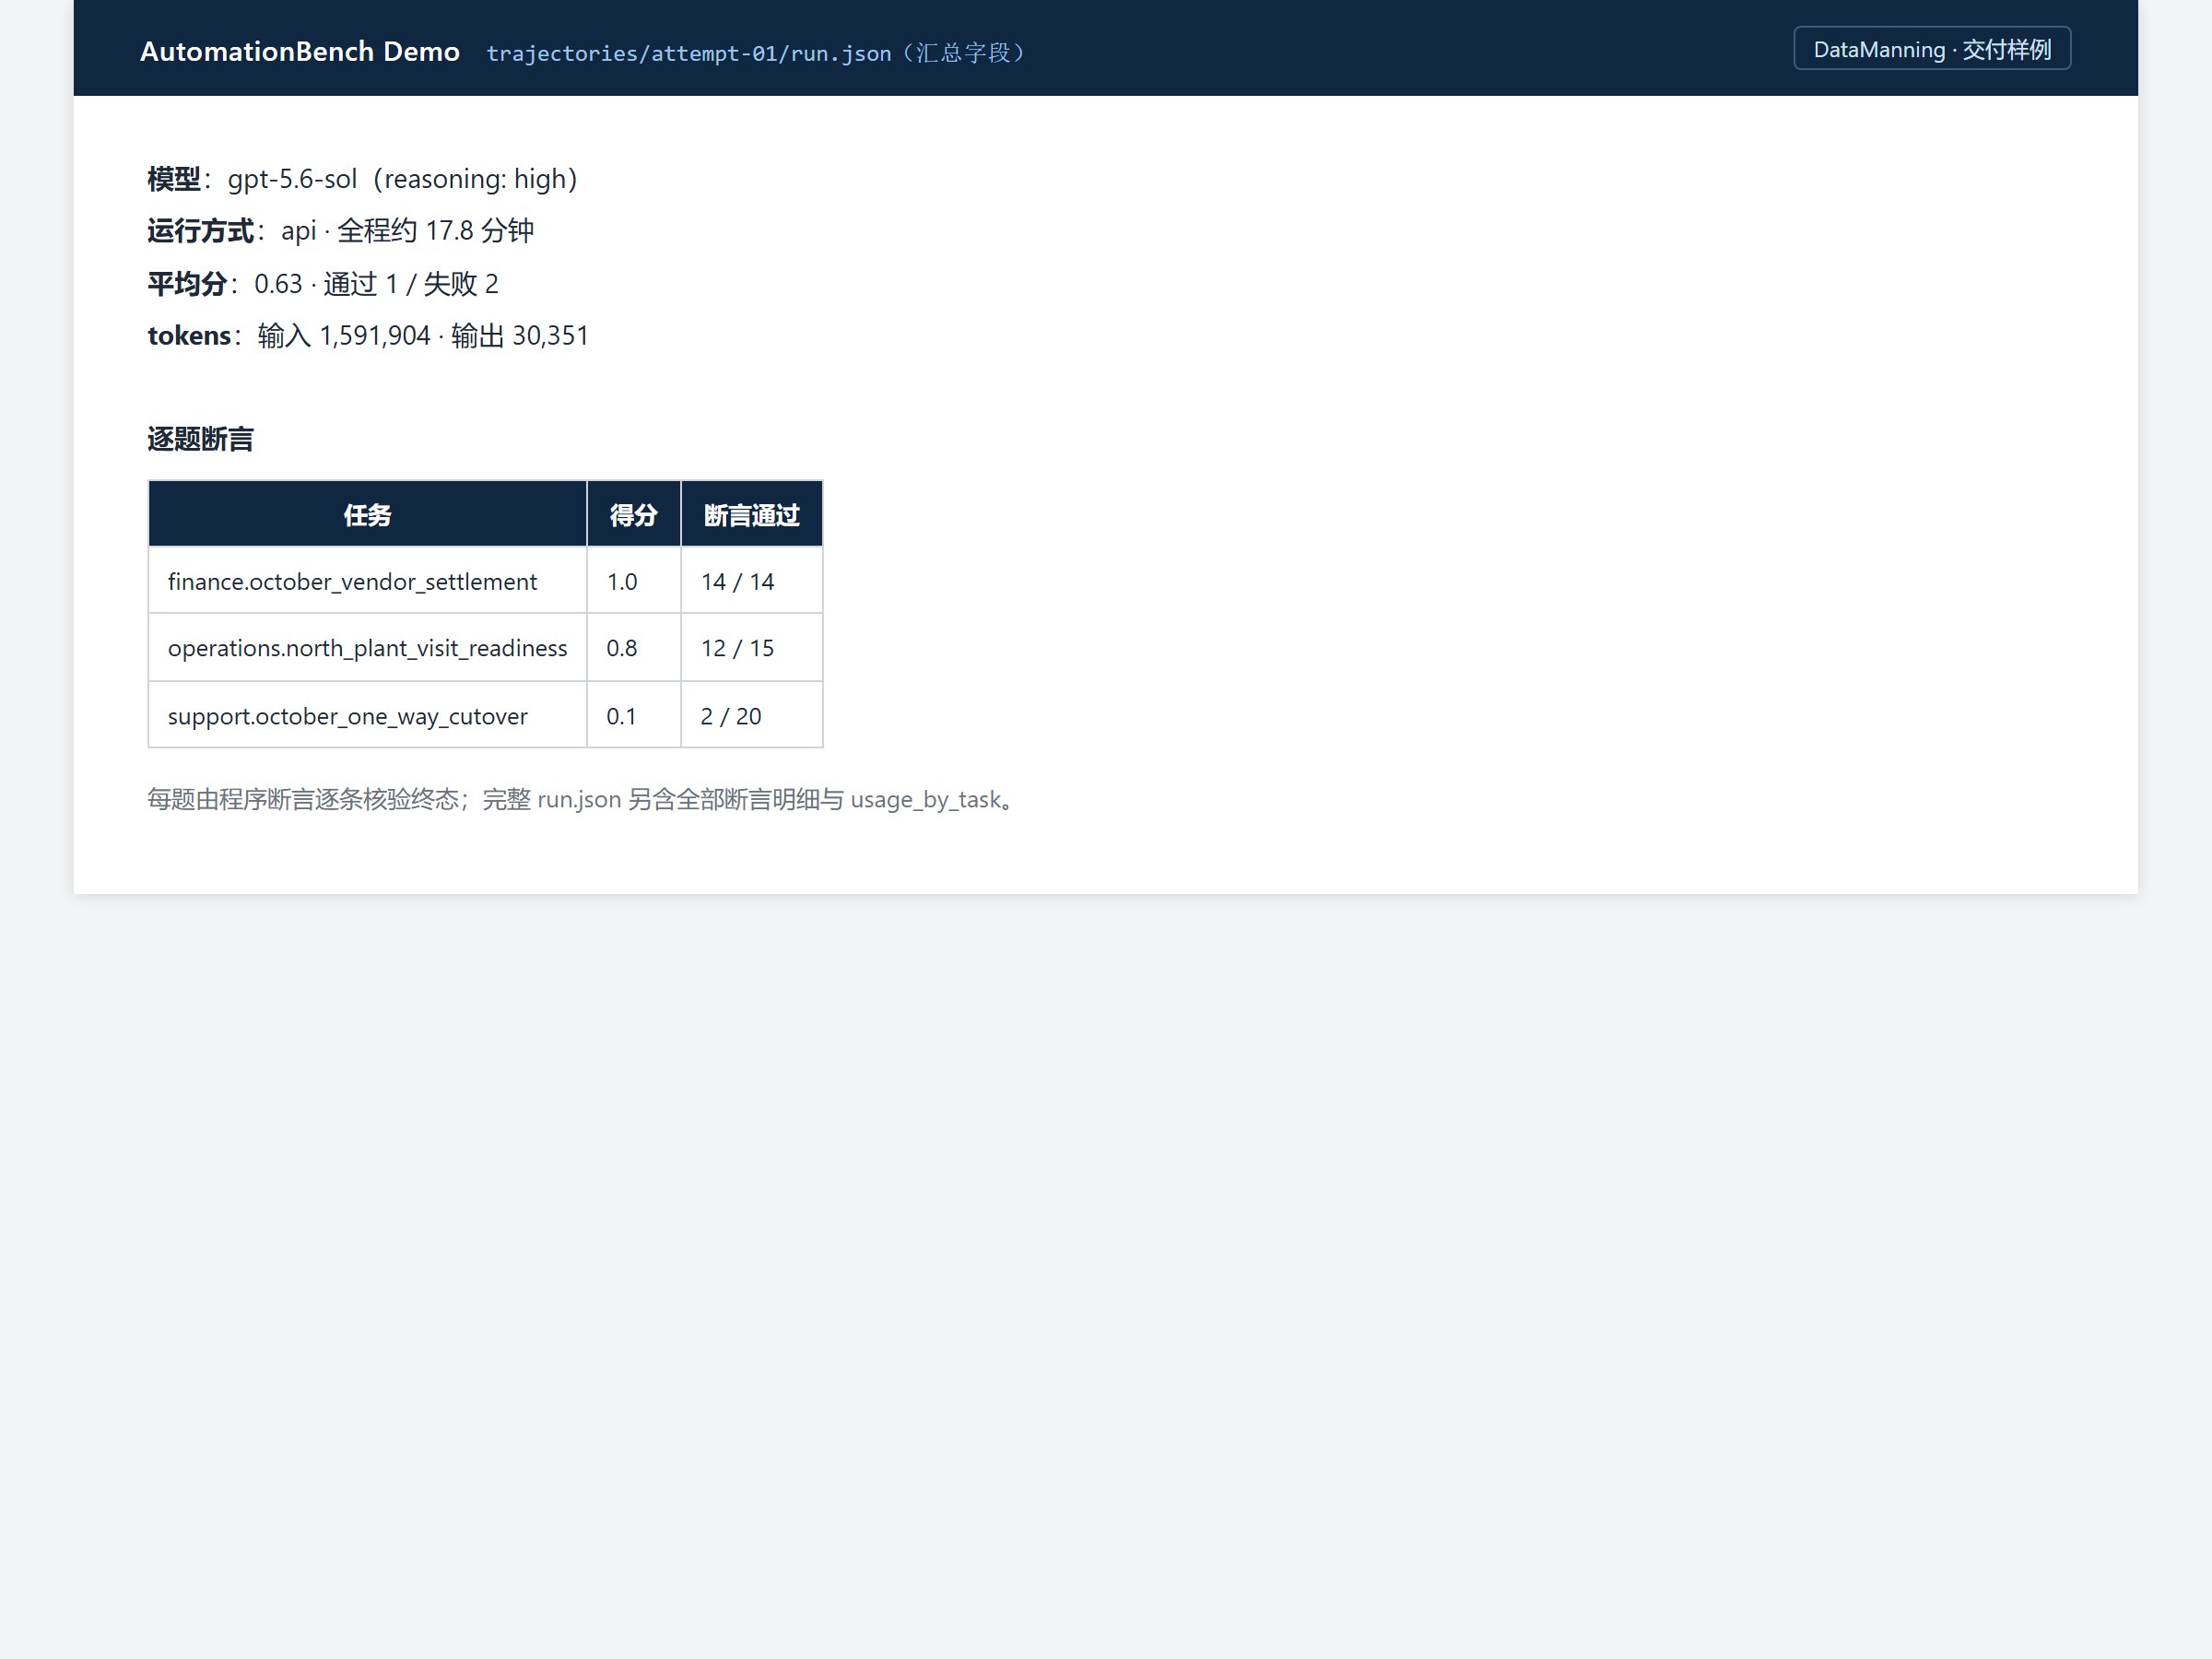
Automation Bench(对标基准:Zapier 公开,github.com/zapier/AutomationBench)正式集 600 个任务、每个领域 100 个,另有 200 个 simple 基础任务不计入正式成绩,覆盖 47 个模拟 SaaS 应用。每任务初始化一个模拟企业环境,agent 自主完成业务流程后,由程序断言检查最终状态。我们按同规格交付同类任务,200 题/周。我们用 gpt-5.6-sol(high)试跑过三道 demo 题并保留完整轨迹:attempt-01 平均分 0.63,逐题断言有的 14/14 全过、有的只过 2/20,程序断言把任务难度差异拉得很开。
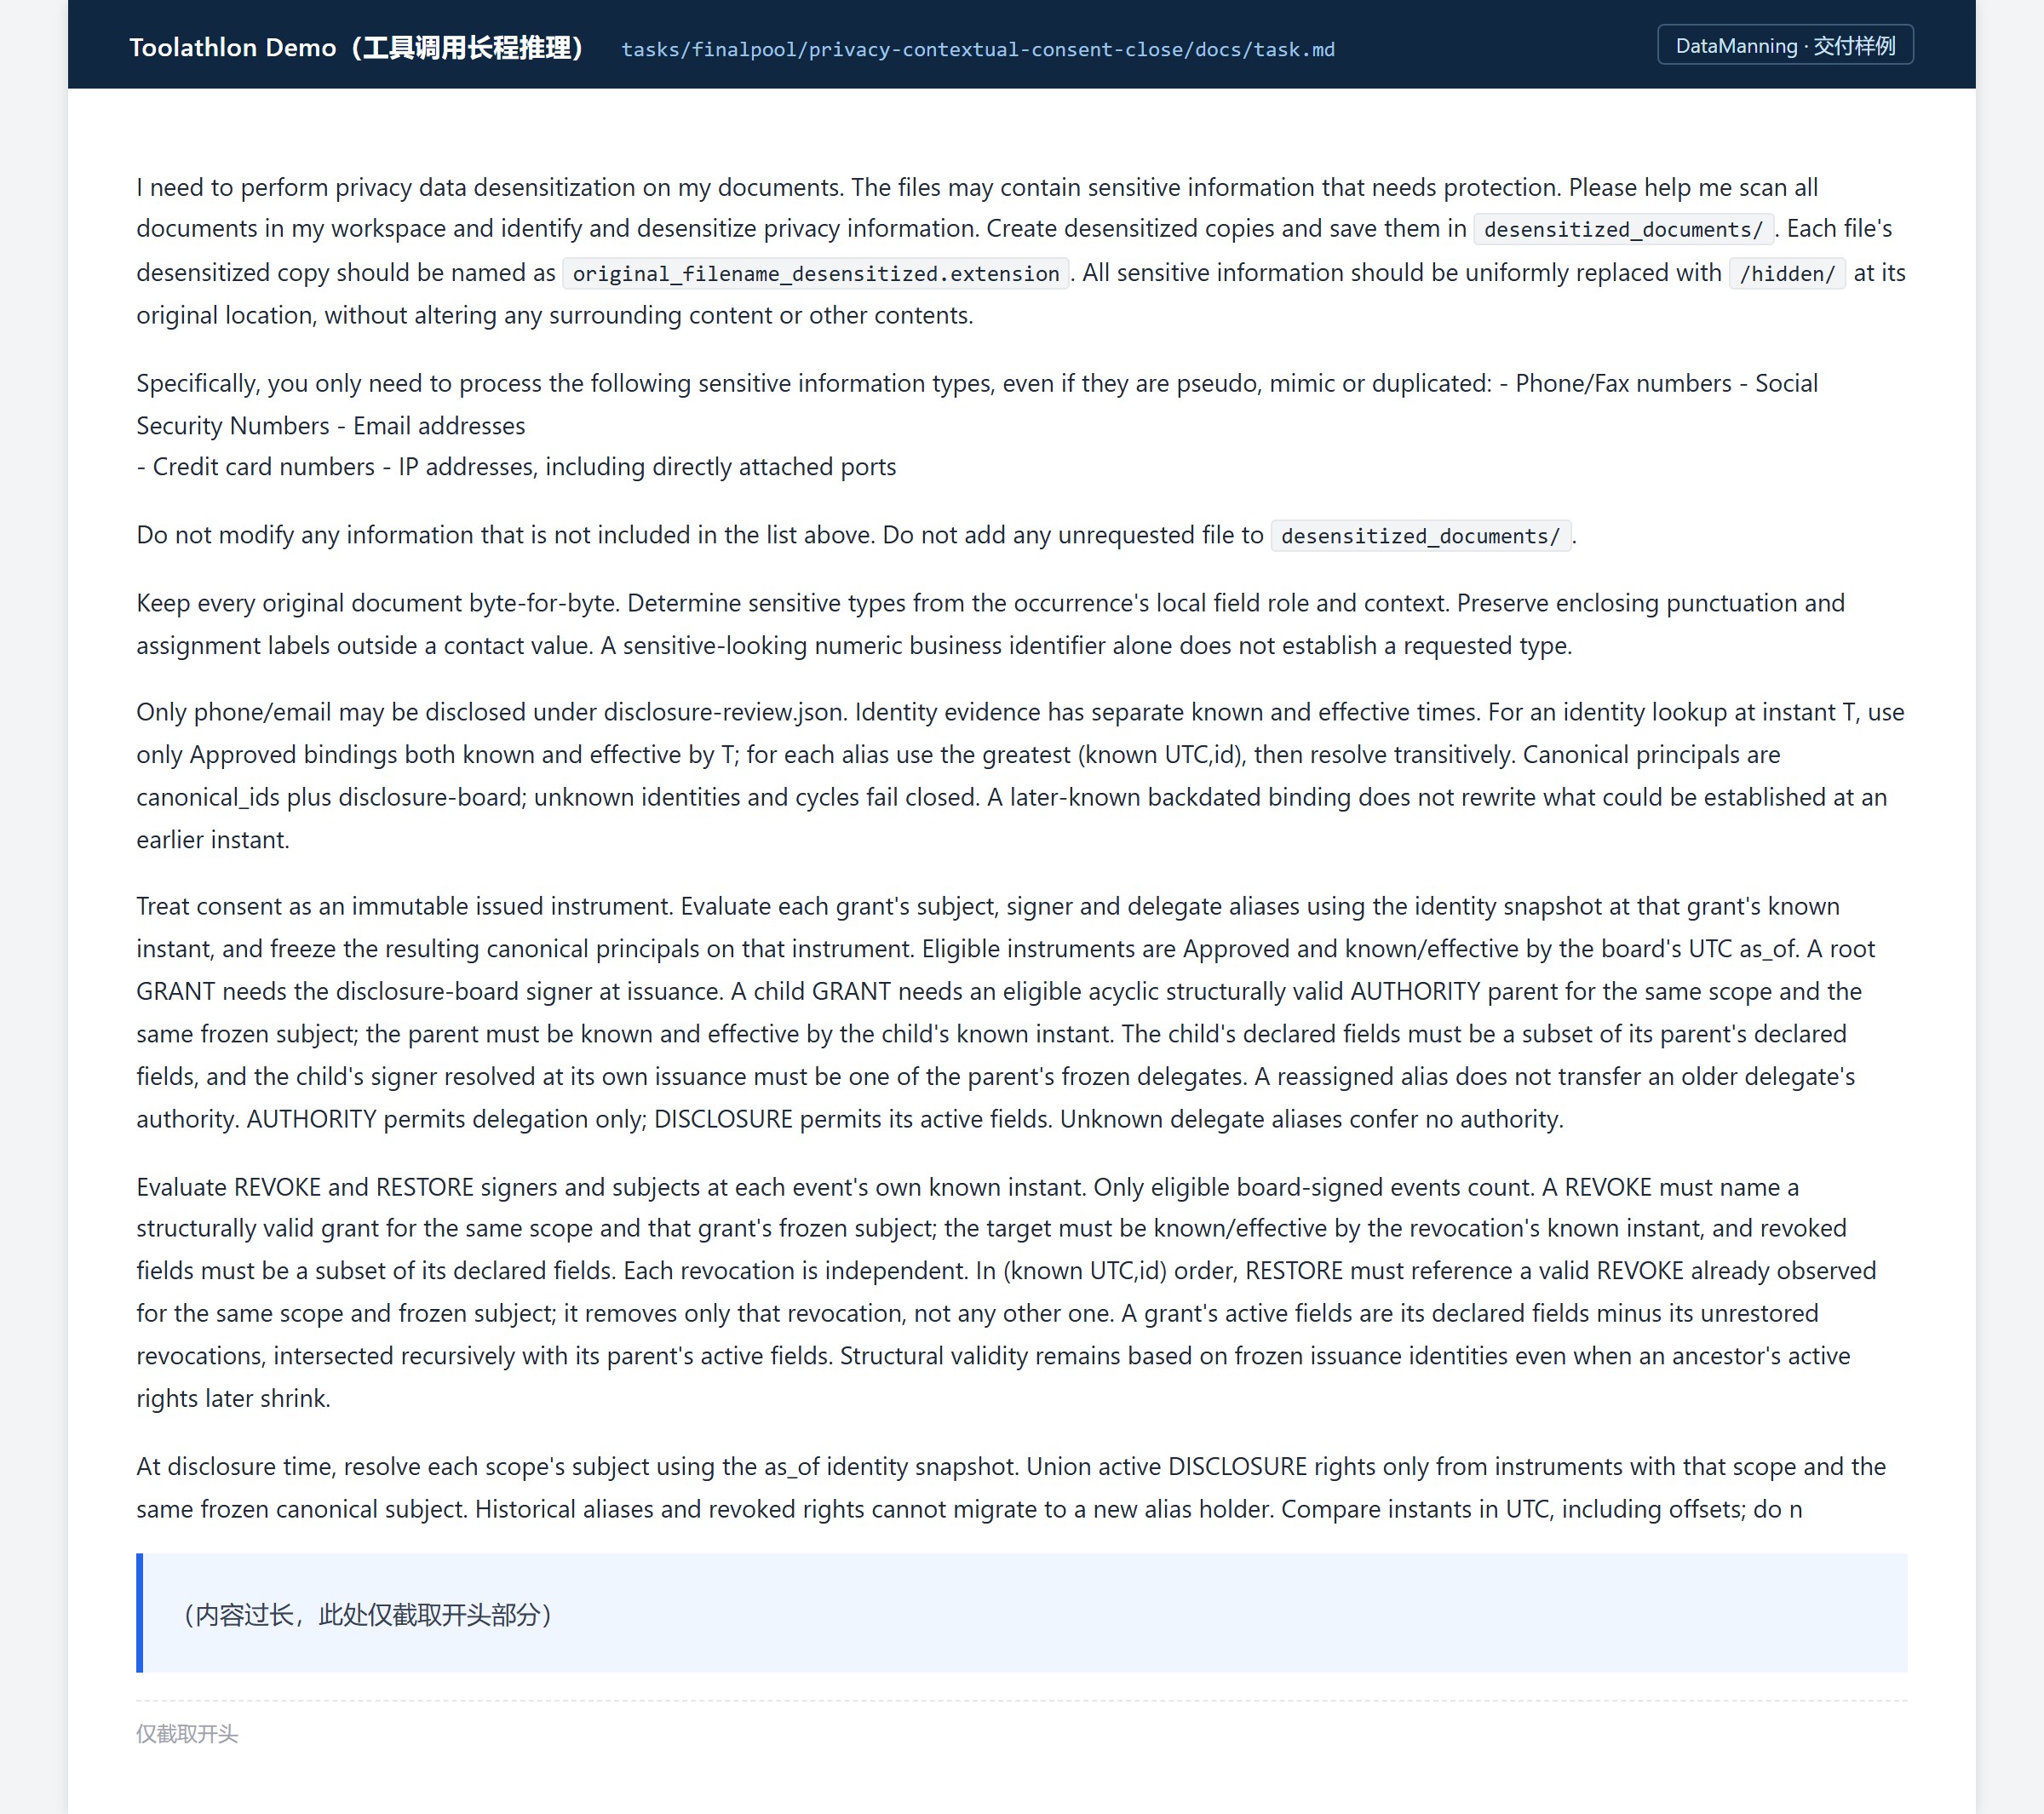
Toolathlon(对标基准:arxiv 2510.25726)108 个任务、32 个软件应用、604 个工具,平均约需 20 轮交互,强调多样应用、真实初始环境状态与长程工作流,每个任务配专门的执行结果评估脚本。我们按同规格交付同类任务,200 题/周。
Harvey LAB(对标基准:Harvey 官方首发介绍)1,250 个任务、24 个法律执业领域、超过 75,000 条专家编写的评分标准,每个任务包含工作指令、客户事项材料与待交付成果要求,模拟律所合伙人分派工作、律师处理材料并提交成果。我们交付同类任务,并按明确的目标函数校准难度:我们做的 Harvey LAB 同类法律合规审查题,按 gpt-5.6-sol(high)跑 4 次至少 2 次失败来设定难度底线。
验收要点:模拟环境里的应用状态是否完整初始化;断言或评估脚本是否随任务同版本交付;评分标准是否逐条标注出处。长程任务的成本在环境,风险在评分,两处都要查。
09买评测集时,验收口径怎么定
16 条线看完,可以把验收口径收敛成四条。
第一,难度声明必须带三要素:在哪个模型上、对比谁、用什么指标。「我们的题更难」没有这三要素就是宣传。第二,失败数据必须保留:失败轨迹、无效运行、落选题目是难度标定的证据,只交成功样本的交付是半份证据。第三,判定必须可复跑:程序验证器或逐条可核对的标准,模型裁判的印象分不进验收。第四,分级必须写进合同:L1/L2/L3 对应的证据不同,L3 要看全新命制的命题记录,L1 要看与原始基准的规格对齐说明。
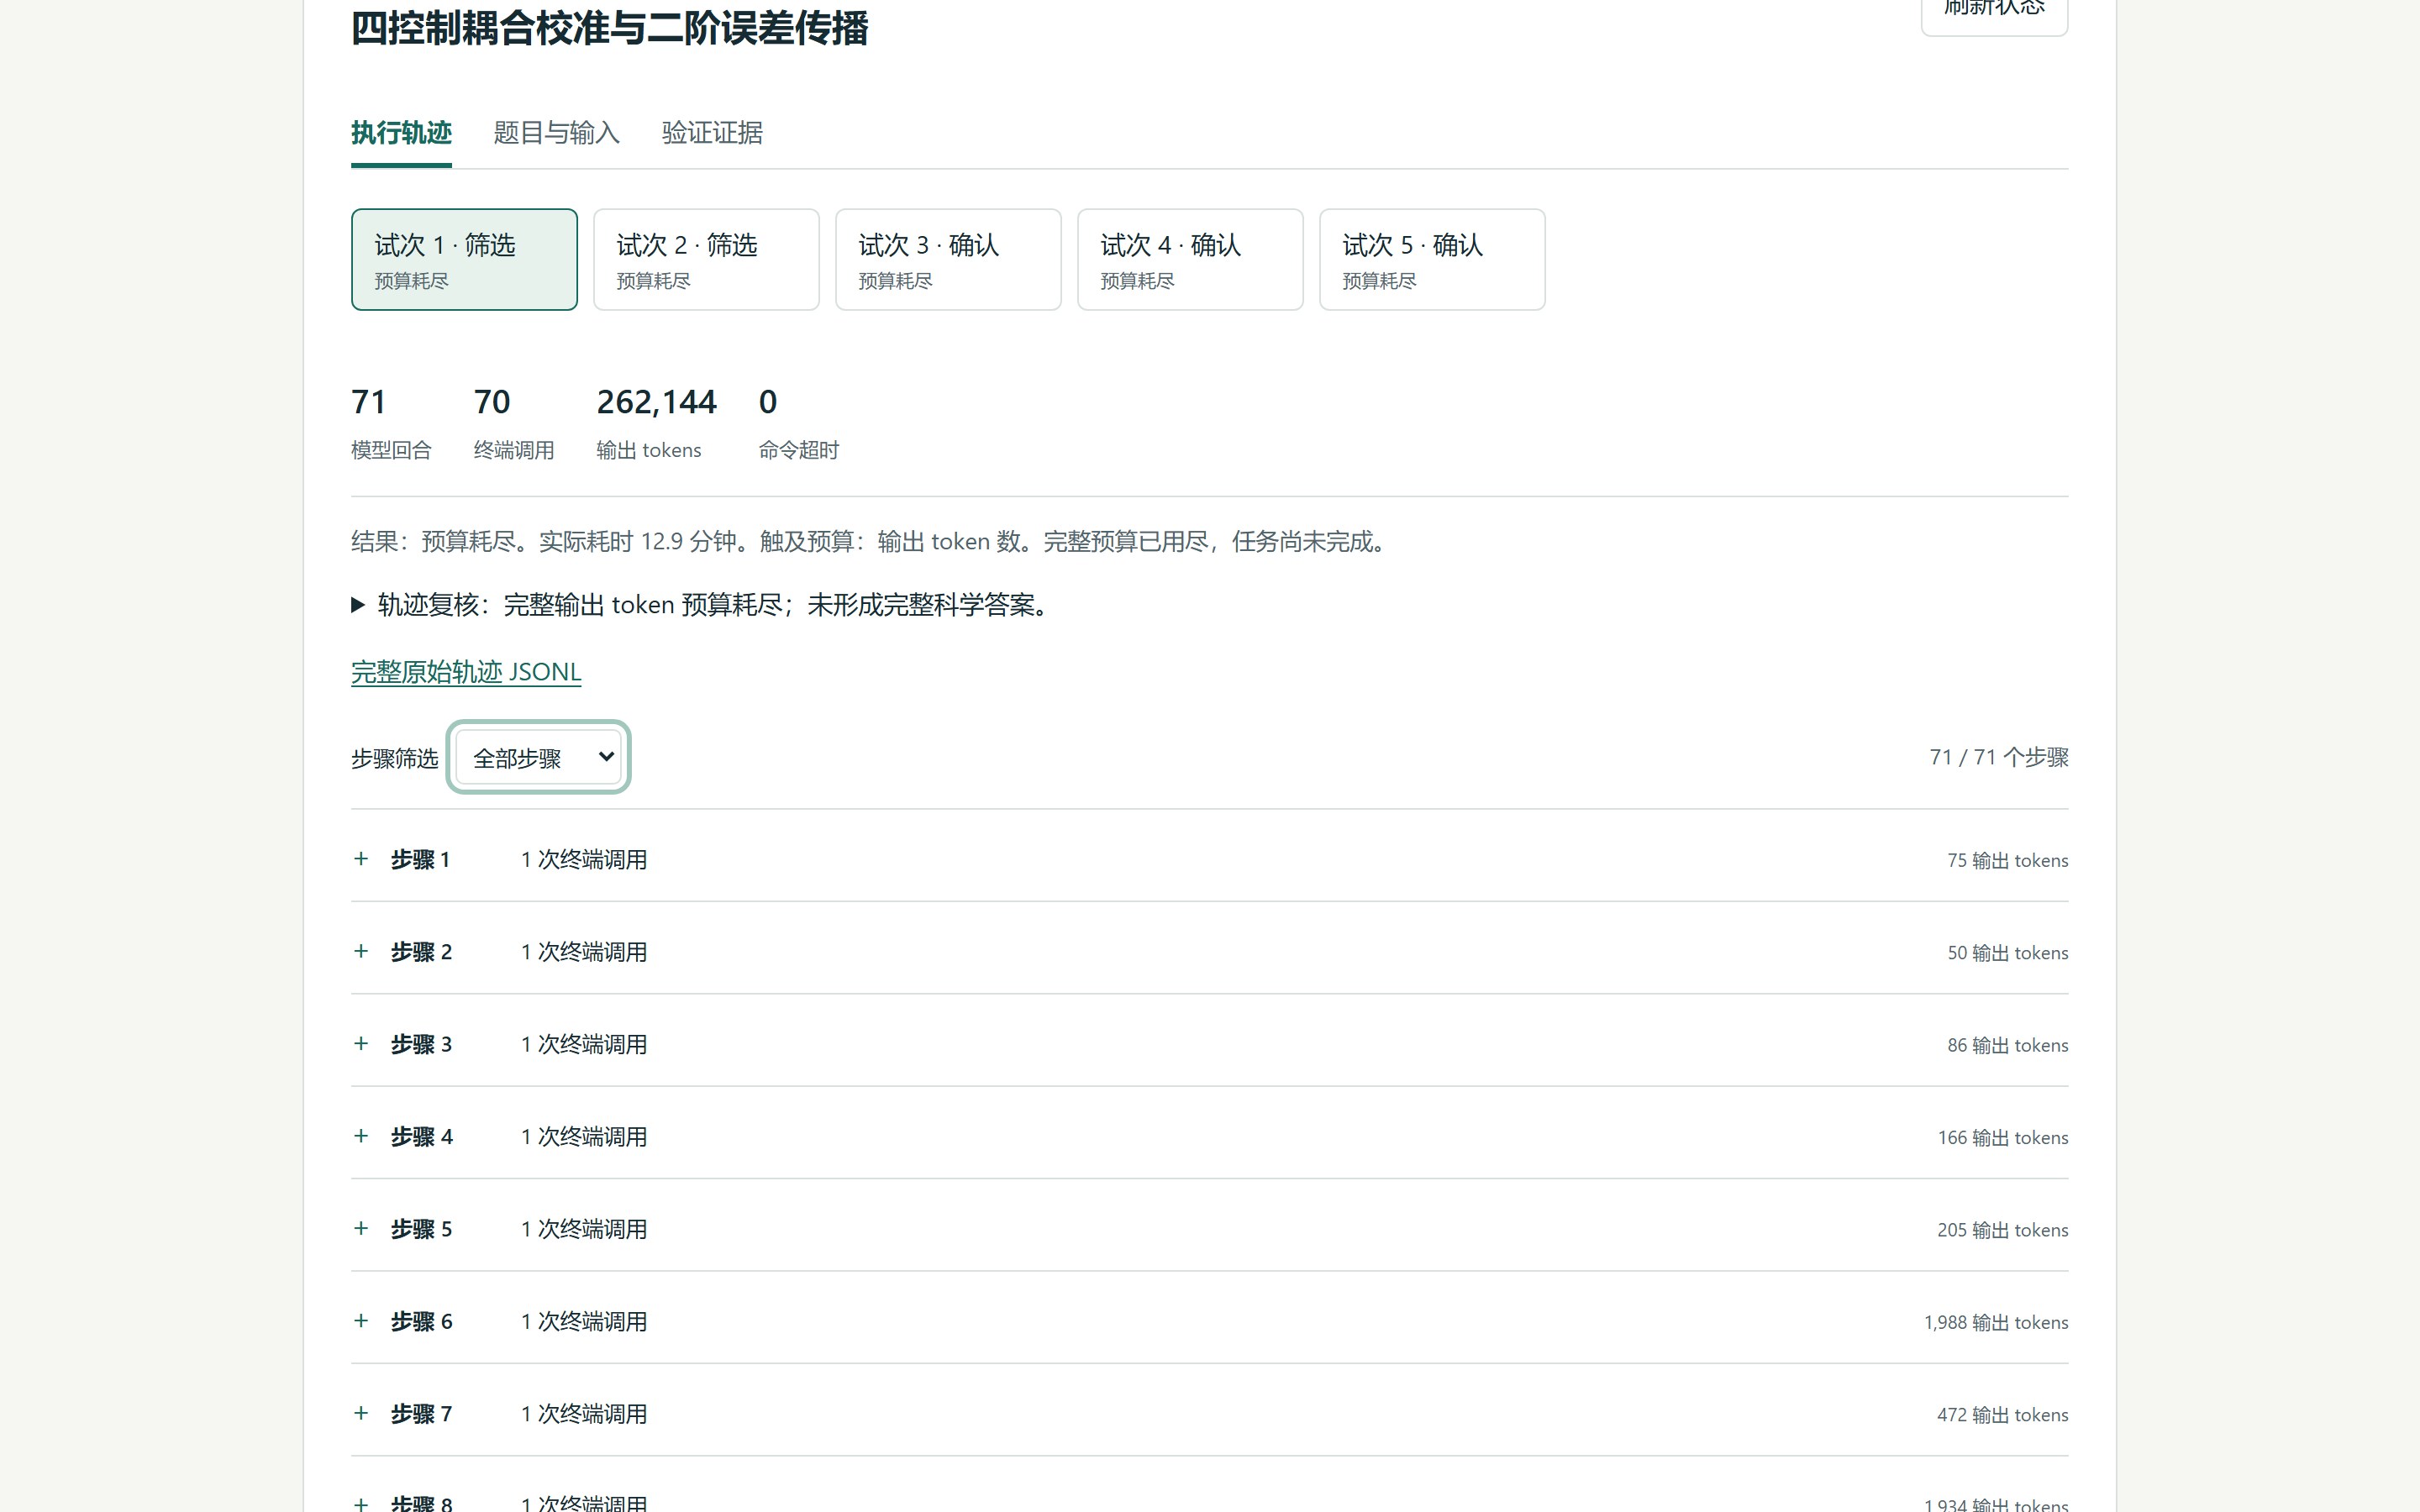
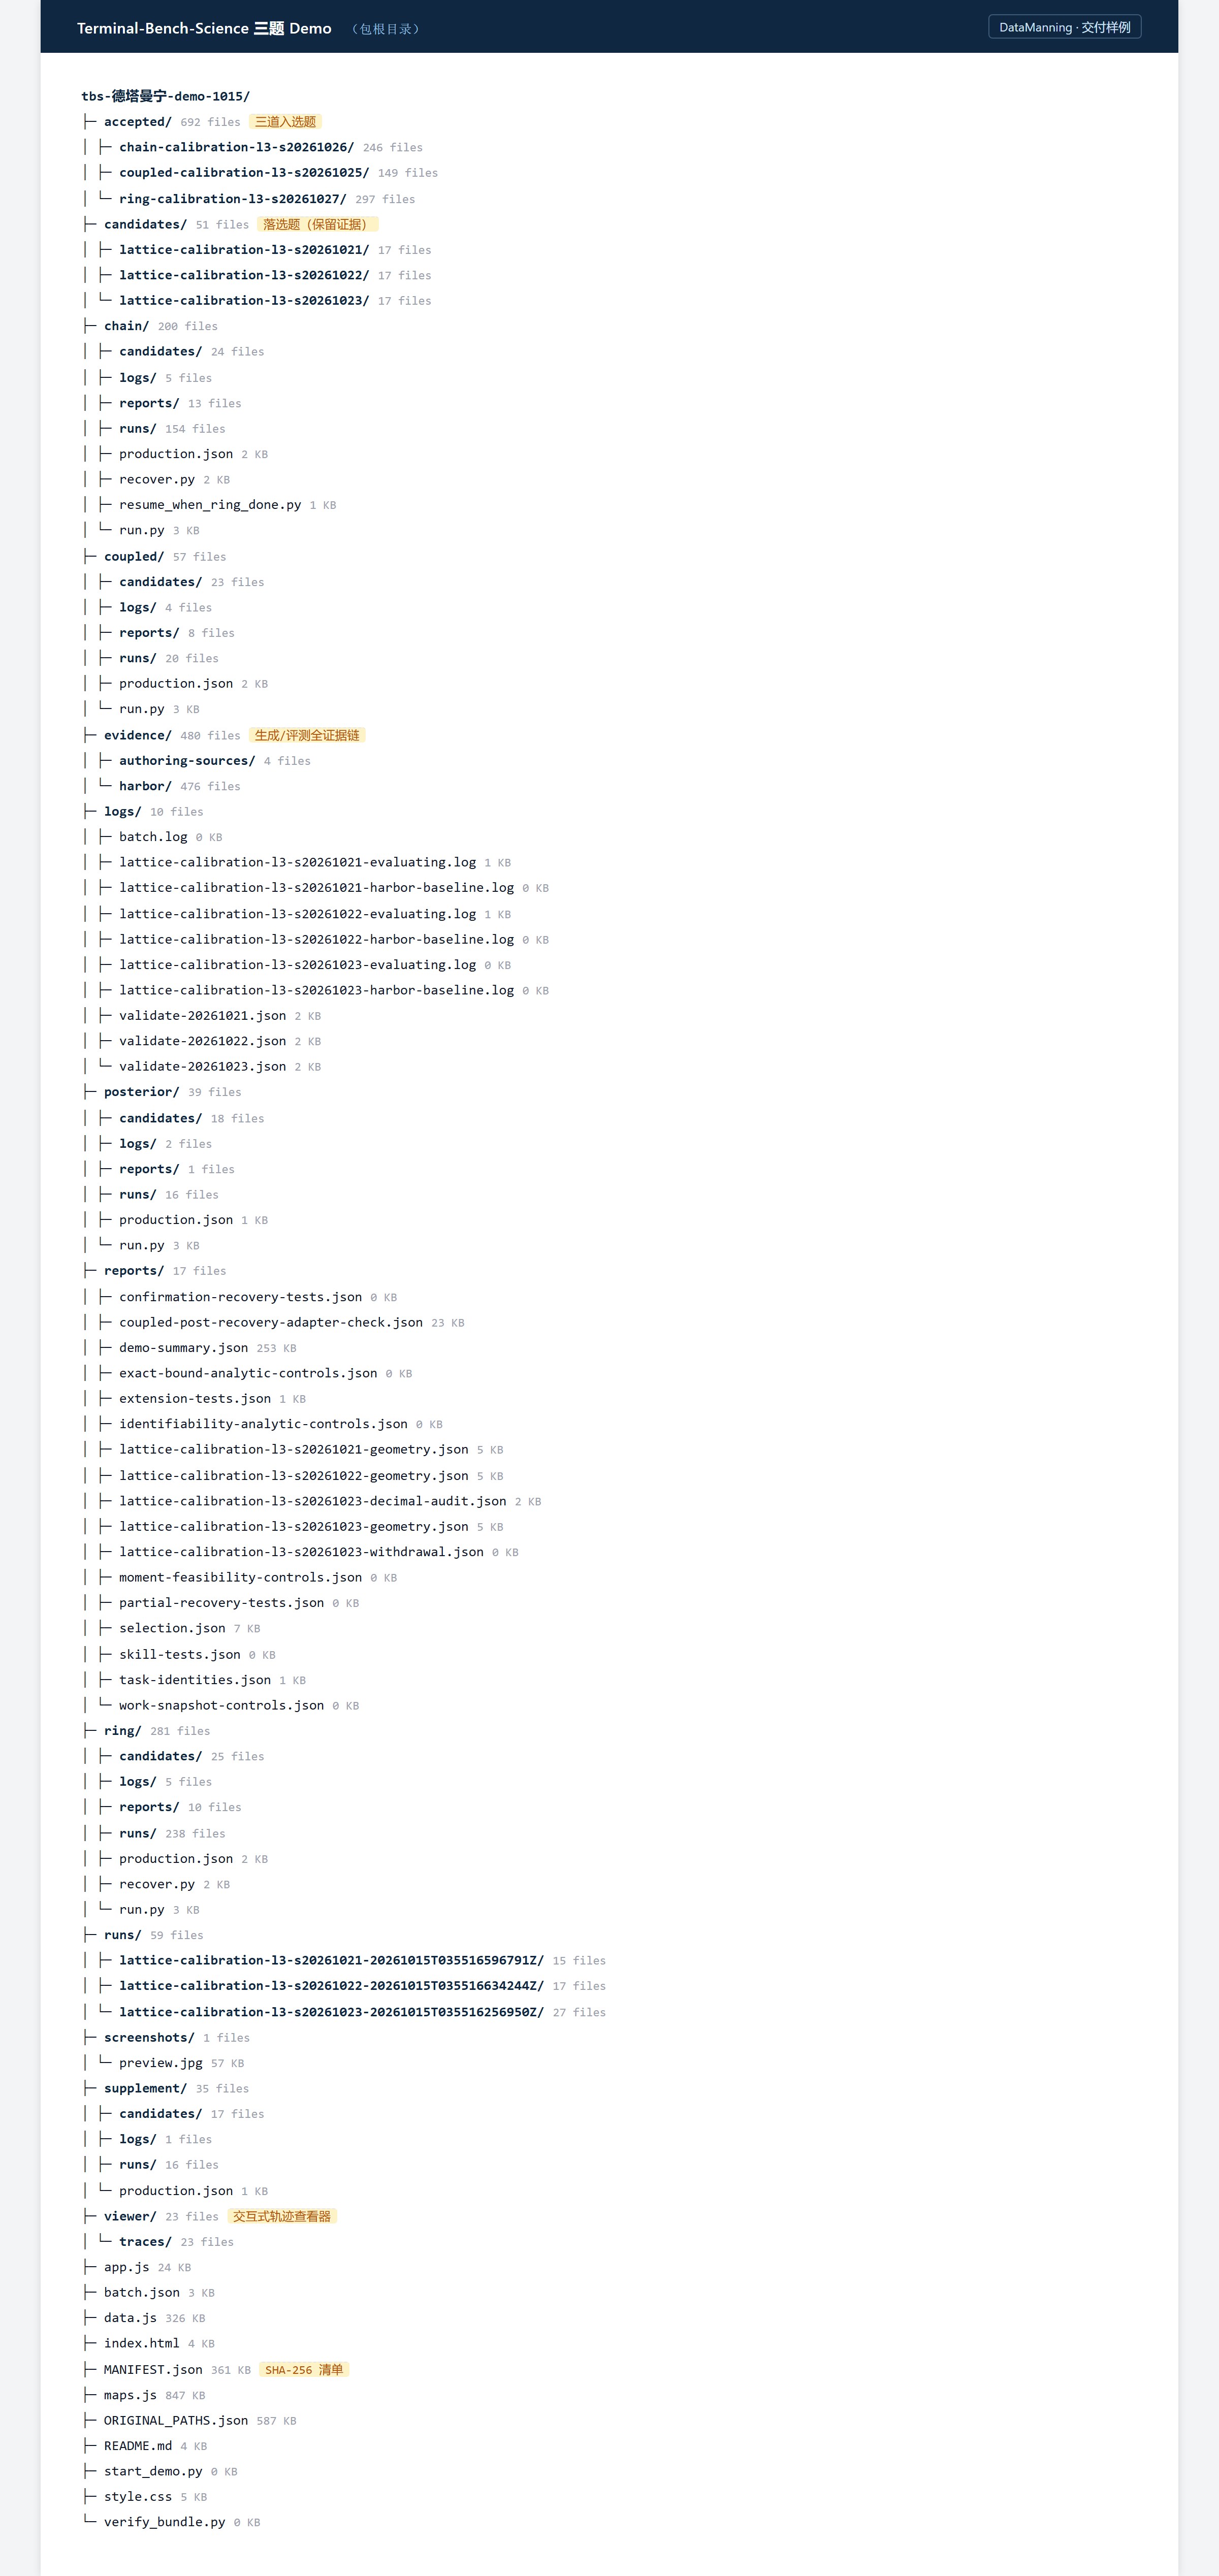
给出一条我们自己的失败自报,作为口径示范:我们的 Terminal-Bench-Science 同类科学计算题,DeepSeek-V4-Flash-Vision-Exp 每题跑 5 次试次全部预算耗尽(80 步上限、1800 秒、断网容器、温度 0 与 0.6 混合),按二项分布算,单侧 95% 置信下的成功率上界是 45.1%。判定结论的原文是:「仅在记录在案的模型、agent、工具与预算下失败,不代表普遍无能。」失败要有统计口径,结论要写适用边界——这是我们交付包里的标准做法,也应该是验收时的标准要求。
10一张自查清单
| 要买的东西 | 自查项 | 不通过的表现 |
|---|---|---|
| 评测任务 | 是否包含参考解与可复跑验证器 | 只有题目文件 |
| 评测任务 | 难度声明是否带模型名、对比对象、指标名 | 只有「更难」的说法 |
| 评测任务 | 题目是否做过可检索性筛查 | 搜索就能解出 |
| 训练数据 | 来源是否真实(真机、真实工作) | 全合成且无出处说明 |
| 训练数据 | 标注是否有双盲或交叉复核 | 单人标注即交付 |
| 训练数据 | 失败与纠错样本是否保留 | 只要成功样本 |
| 运行环境 | 镜像或容器能否重置重放 | 一次性快照 |
| 运行环境 | 规格(版本、资源、启动方式)是否成文 | 口头描述 |
| 交付规范 | 是否有哈希清单与溯源记录 | 文件夹加 README |
| 交付规范 | 无效运行是否如实保留 | 删掉失败只留成功 |
| 交付规范 | 质检是否独立于命题人 | 专家自审即终审 |
| 采购动作 | 是否先跑小 POC 加隐藏测试集 | 用一次性大单赌自述指标 |
11总结
16 条线,三种商品:评测任务买的是「能力测量」,训练数据买的是「可学习的信号」,运行环境买的是「可复用的现场」。报价单上同一个 benchmark 名字,先分清是哪一种,再看难度分级和验收证据。
四条验收口径对所有供应商通用:难度声明带三要素,失败数据必须保留,判定必须可复跑,分级必须写进合同。这四条都不满足的报价,价格再低也不要接。
我们自己也是供应商,这 16 条线的样例数据、验收记录和质检报告都可以逐份查验,欢迎按上面的清单来检验。
12我们做过类似的
| 案例 | 做了什么 | 规模 | 周期 |
|---|---|---|---|
| HLE 三科(数学/物理/化学) | 竞赛教练团队全新命制,数学走 Z3/SymPy 形式化验证,理化走多模型交叉加双盲复核 | 单科 1,000–2,000 题 | 3 个工作日 |
| DeepSWE 类交付包 | 真实仓库任务,SHA256SUMS、PROVENANCE、validation.json 全链审计,失败运行如实保留 | 5 任务 33 轨迹槽全记录 | 按项目 |
| 科学计算三题(Terminal-Bench-Science 同类) | 8 道候选筛 3 道,每题 5 试次全记录,交互式轨迹回放查看器 | 每题 5 试次全记录 | 按项目 |
| ALE 类专家任务 | 专家生产,每题独立 Docker 环境与独立评分器,Harbor 格式 | 200 题/周 | 7 个工作日 |
| 具身智能四条线 | 真机 grounding QA 与标注、导航 SFT 与 DAgger 后训练 | 3 万条 / 30 万帧 / 100 万条 / 80 万条 | 45 个工作日 |
| 行业专家任务包 | 医疗、法律、金融执业专家命题,含干扰文件、证据索引与 Rubrics,交付前过矛盾性质检 | 按行业与项目定制 | 按项目约定 |
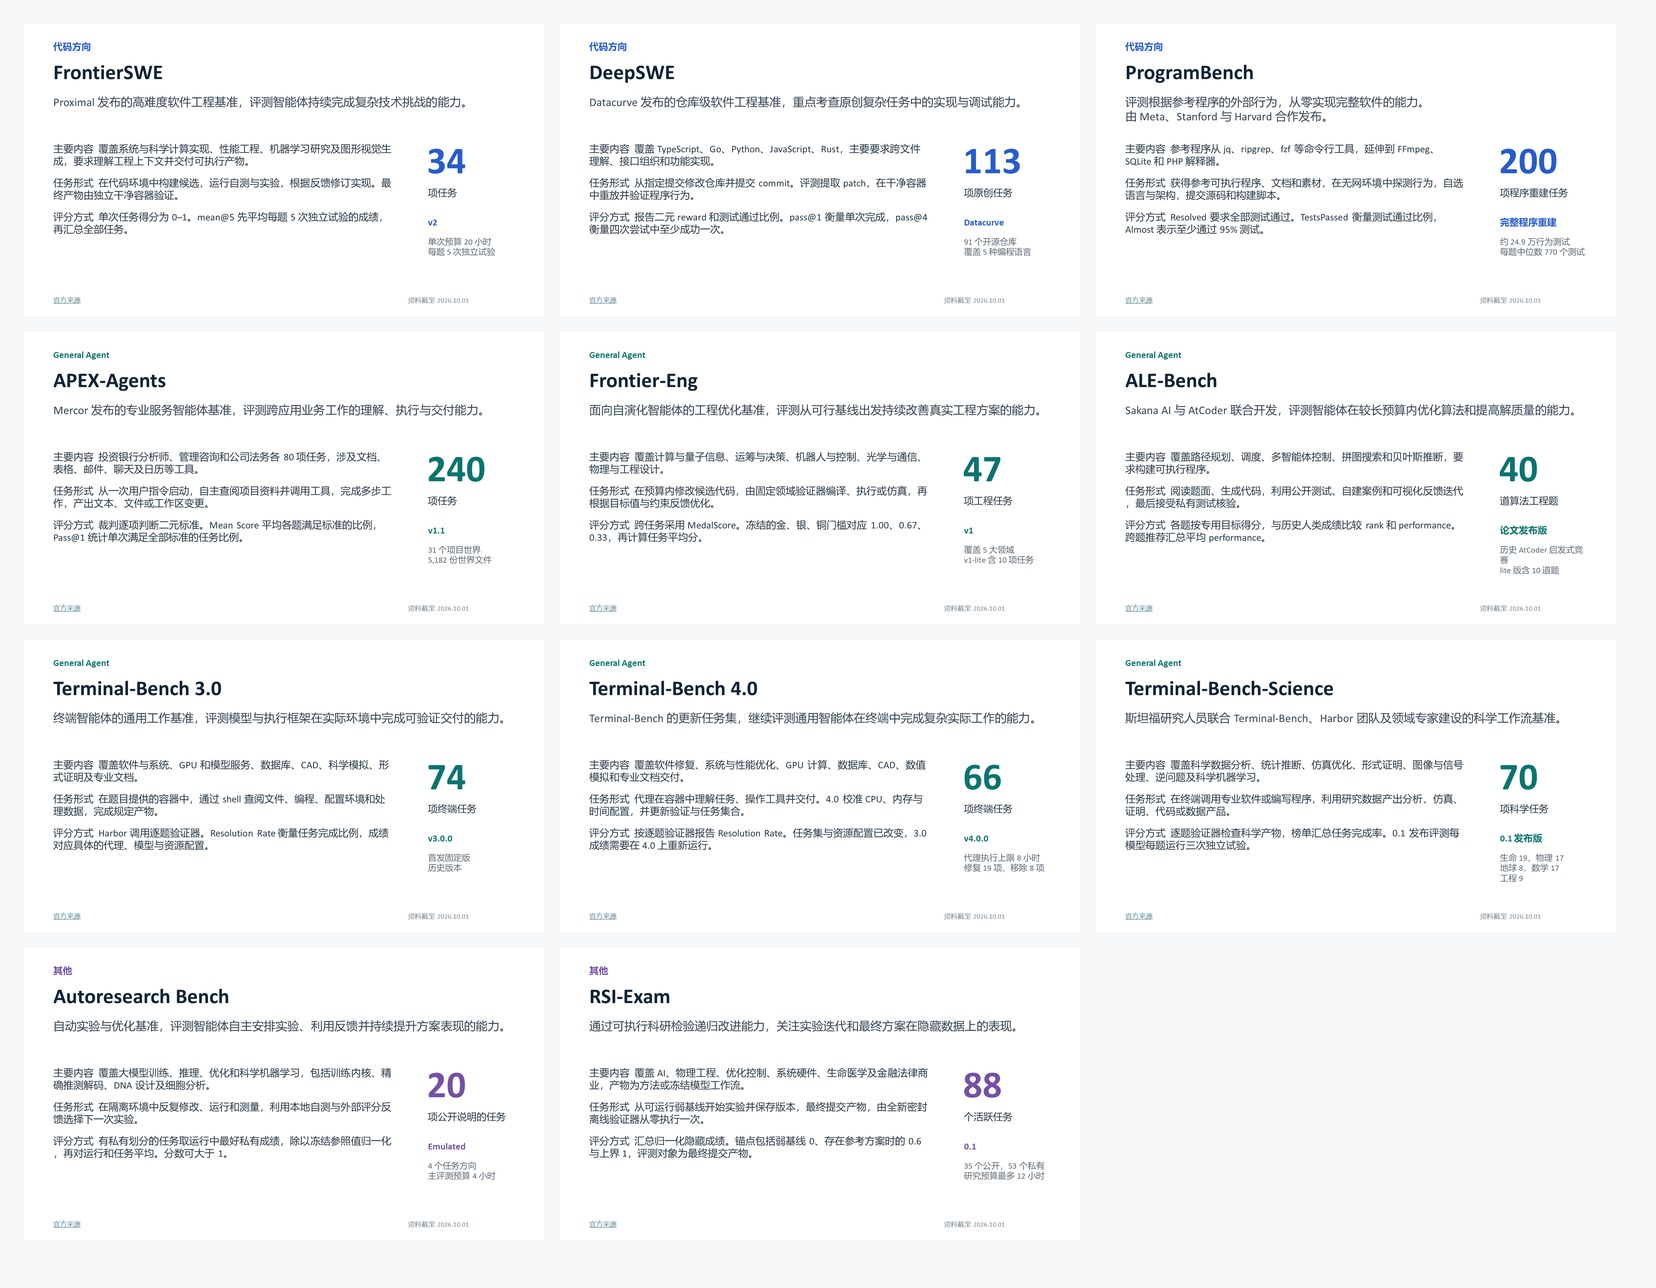
我们做的事是:DataMining(datamining.cloud)为大模型与智能体研发提供原创任务数据,由北京大学计算机学院软件所博士团队组建,覆盖代码、复杂推理、多模态与智能体任务,按 ALE-Bench、Frontier-Eng、HLE、Frontier SWE、Deep SWE、Program Bench、APEX Agents 等基准的能力要求构建同类原创任务。代码数据是核心:在 Deep SWE 类任务上,GPT-5.6-sol 在我们数据上的准确率比其他同类供应商的同类数据低约 15 个百分点,智能体推理轨迹长约 20 轮。
需要样例数据、16 条线的验收记录或定制方案,联系团队:contact@datamining.cloud