Terminal-Bench-Science 在测什么?一题科学计算 Agent 样例,难在找全而不是算快
全局最优解找到了,答案就一定对吗?
不一定。科学计算里,真正麻烦的有时不是找到一个最优点,而是确认所有可能的最优解区域都找全了。哪怕只漏掉一个很窄的区域,后面算出的概率、协方差和参数反演也可能一起偏掉。
这正是科学 Agent 任务有意思的地方:它不只看模型会不会调用 Python、能不能把程序跑起来,还要看它是否理解了问题的数学结构,能否把计算结果交代清楚,并让别人复核。
01Terminal-Bench-Science 想测什么?
Terminal-Bench-Science(简称 TB-Science)关注的是 Agent 能不能在终端里完成一段科学研究工作流。它不是只给一道知识问答题,再看模型能不能答出结论;任务通常要求 Agent 读懂研究问题,编写并运行代码,处理数据或模拟过程,最后产出可以检查的结果。
这个方向的关键在“工作流”。模型可能知道公式,却在实现时漏掉边界条件;程序也可能顺利运行,产物却没有回答题目真正问的东西。要评估这类能力,任务需要有明确输入、可执行环境和可验证的结果。Terminal-Bench-Science 的公开项目由科学领域专家参与设计和审阅,任务围绕真实研究流程组织。官方项目会持续更新,任务数量也随版本变化;本文不把某个版本的规模当成固定数字。
DataMining 做了一组参考这类能力方向的科学计算终端任务。它们是我们自己的样例,不是官方 Terminal-Bench-Science 题目、榜单成绩或合作项目。我们选的场景是整数相位校准与参数反演:给定一组控制参数和观测关系,Agent 要找出全局最优的整数解区域,再据此计算统计量并反推出参数。
02为什么“把网格扫密一点”还不够?
先把问题想得直观一些:控制参数连续变化时,整数解会随着参数跨过边界而改变。于是参数空间被切成许多小区域,每个区域对应一种整数解。题目要求的不是随便找几个点,也不是只找一个最低值,而是列全所有有正体积的全局最优解区域。
如果只在网格点上试算,窄小区域可能刚好夹在采样点之间。程序会给出一张看似平滑、看似合理的结果图,却把那块区域整个跳过去。后续计算再精细,也只是在错误的区域清单上做统计:边缘概率、协方差、高阶矩乃至最后反演出的参数都会受到影响。
所以这组任务把“找解”和“证明找全”分开看。求解程序要给出候选区域;验证材料还要检查有限搜索范围、区域覆盖、数值恒等式,以及参数是否存在、是否唯一。对 Agent 来说,这要求它在连续参数空间、整数优化和统计计算之间保持一致,不能只盯着某个局部结果。
03我们怎样筛掉不合格的题?
这组样例不是从三道漂亮题面开始的。候选记录里一共走过八道题:四道在指定模型和试跑配置下被解出;有一道则因为参考答案漏计了一个极小区域而撤回。最后留下三道,分别采用四控制耦合、八控制链式和八控制闭环结构。
撤回那题尤其值得讲。独立的区域叠加检查数出了 358 个正面积区域,冻结的参考答案只列了 357 个。漏掉的那一块面积约为 6.16×10⁻¹³,被参考解里的概率阈值筛掉了。它小到很容易被当成数值噪声,但题目问的是“全部区域”,这块就不能凭小而忽略。我们在难度评估开始前撤回了它,没有把这次缺陷算成模型失败。
这也解释了为什么不能只盯着跑分。若模型提交的区域数和答案不一致,乍看像模型漏算;但答案自己也可能先漏了一块。先对齐参考答案,模型分数才有意义。
三道入选题的参考解记录了完整区域审计,并配有独立数值校验、错误答案对照和参数存在性/唯一性检查。交付包里还保留题面、运行环境、参考解、自动评分测试、筛选记录和执行轨迹。它们让读者可以沿着“题目问什么—程序算出什么—评分如何判断”逐步检查,而不是只看到一个最终分数。
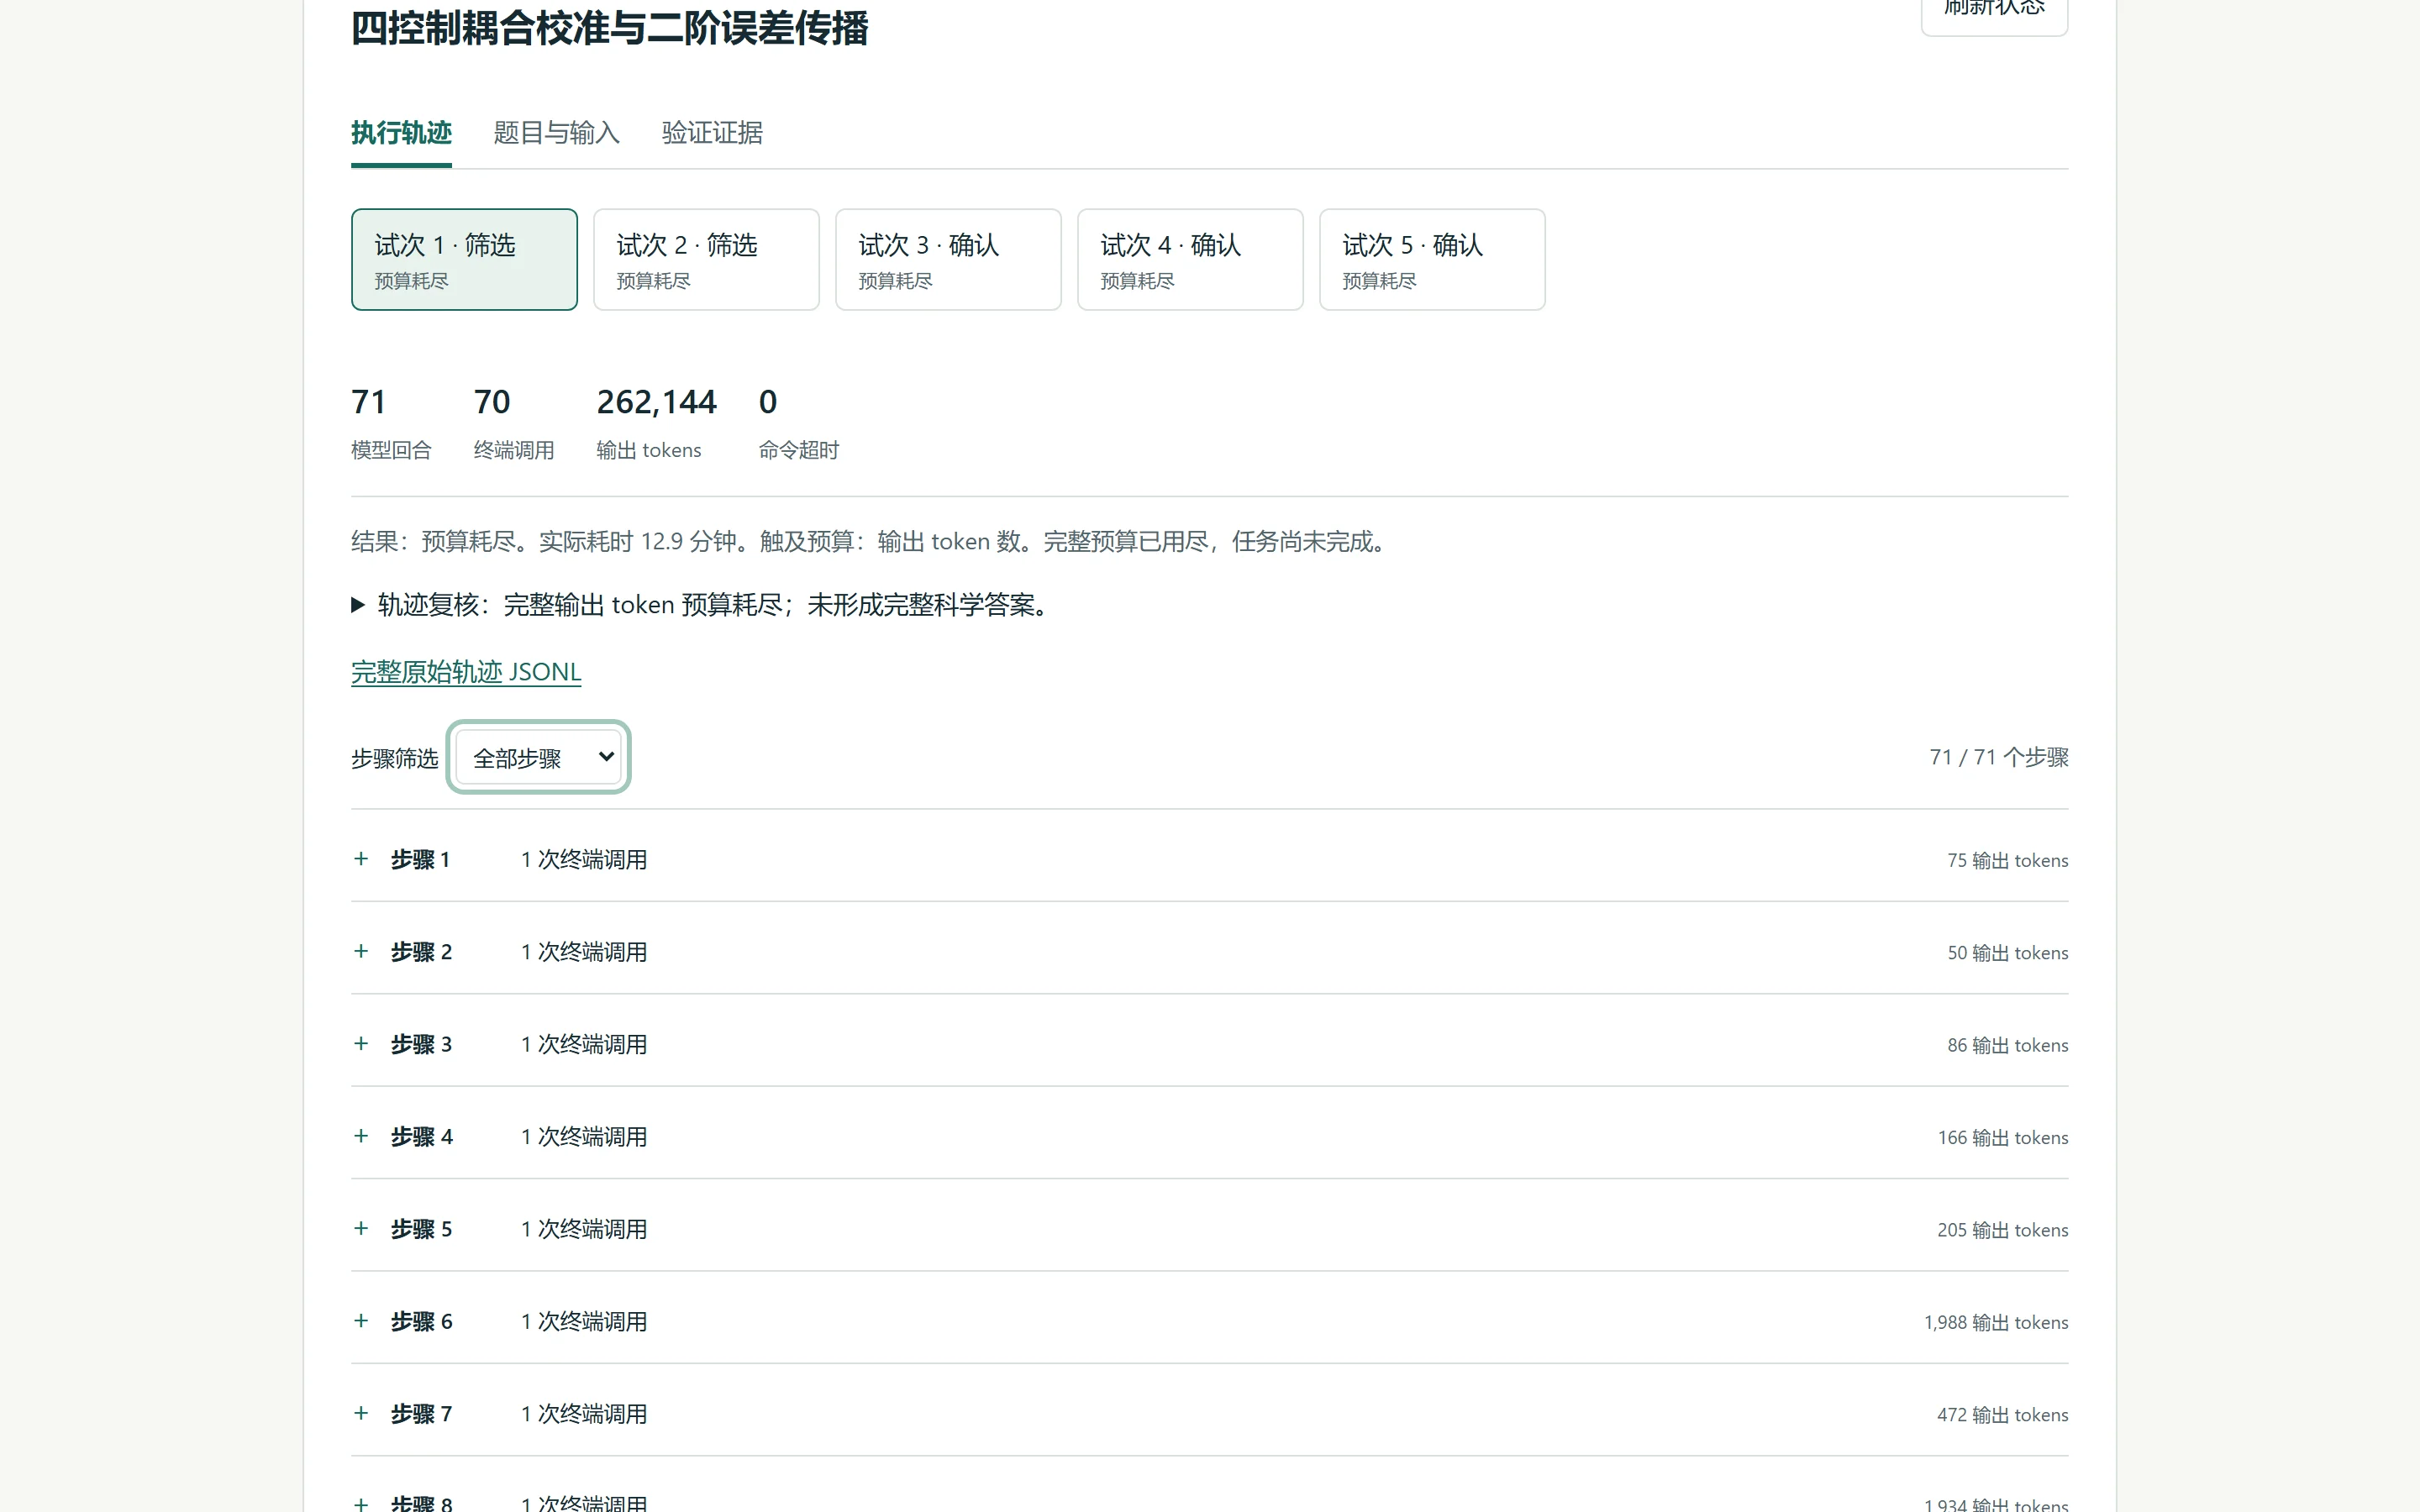
图:样例查看器中的一条运行记录。界面可以逐步查看模型响应、终端命令及输出;图中数据对应单次试验,不代表模型总体成绩。
04这类任务能帮助团队判断什么?
如果你在做科学计算 Agent、工程 Agent 或长程推理评测,题目“难”本身并不够。更实际的问题是:任务究竟卡住模型哪种能力?参考答案有没有独立核对?评分器能否识别看似合理但漏算区域的结果?失败轨迹能不能说明问题出在建模、实现还是数值校验?
这组科学计算样例把这些问题落在一个具体任务上。它并不证明模型在所有科学领域的能力,也不把包内某次评测外推成行业排名;它展示的是一种任务设计方法:把复杂计算拆成可执行的步骤,把关键假设写清楚,并让答案和失败过程都有复核入口。
DataMining 为大模型与智能体研发提供原创任务数据,覆盖代码、复杂推理、多模态和 Agent 任务。团队由北京大学计算机学院软件所博士生组建。正在设计科学计算或长程 Agent 的训练、评测数据时,可以围绕目标能力、运行条件和验收口径交流需求。
05标题备选
- Terminal-Bench-Science 在测什么?科学 Agent 难在把研究流程做完整
- 漏掉一个极小区域,为什么会让整道科学计算题的答案变掉?
- 科学 Agent 不只要算出答案,还得证明自己没有漏算
- 从 8 道候选到 3 道样例:我们怎样检查科学计算任务的参考答案
- 一道科学计算题,为什么要审计所有最优解区域?