数据配比这件事,为什么越洗越玄?(上)
DataMining · 2026年11月6日
先把话说清楚。很多人一听大模型训练,第一反应是“堆数据、堆算力、堆参数”。但真正做过的人知道,现在卡点已经不在“有没有数据”,而在“这些数据该怎么用”。
从2018年左右到现在,预训练的核心变化其实就三步:
- 洗数据(减法):互联网原始文本里有大量重复、低质、污染内容。不去掉,模型会把垃圾当知识学进去。
- 造数据(加法):高质量的数学、代码、推理数据本来就稀缺,靠人工写不够,于是开始用模型自己生成,但必须带可验证机制,否则模型容易学会走捷径。
- 配数据(核心决策):总token预算是固定的。你给代码多一点,其他数据就一定少一点。这是零和博弈,不是想给多少就给多少。
这三步是连环的。前两步做完,你手里才有一堆“能用”的数据;第三步决定模型每天到底在学什么、学到什么比例。很多人把精力都花在前两步,结果配比阶段随便一配,效果直接打折。
0101 洗数据为什么是必须的
早期Common Crawl直接拿来用,效果很差。后来大家发现,精确去重、模糊去重、质量过滤、去污染(避免测试集泄露)每一步都能带来可观提升。
HuggingFace做FineWeb、FineWeb-Edu时,把过滤和去重做到极致,最后用更少的token就能打过更脏的大数据。Meta在Llama 3里也明确用了分类器做降采样,把过度代表的类别(娱乐类等)压下去。
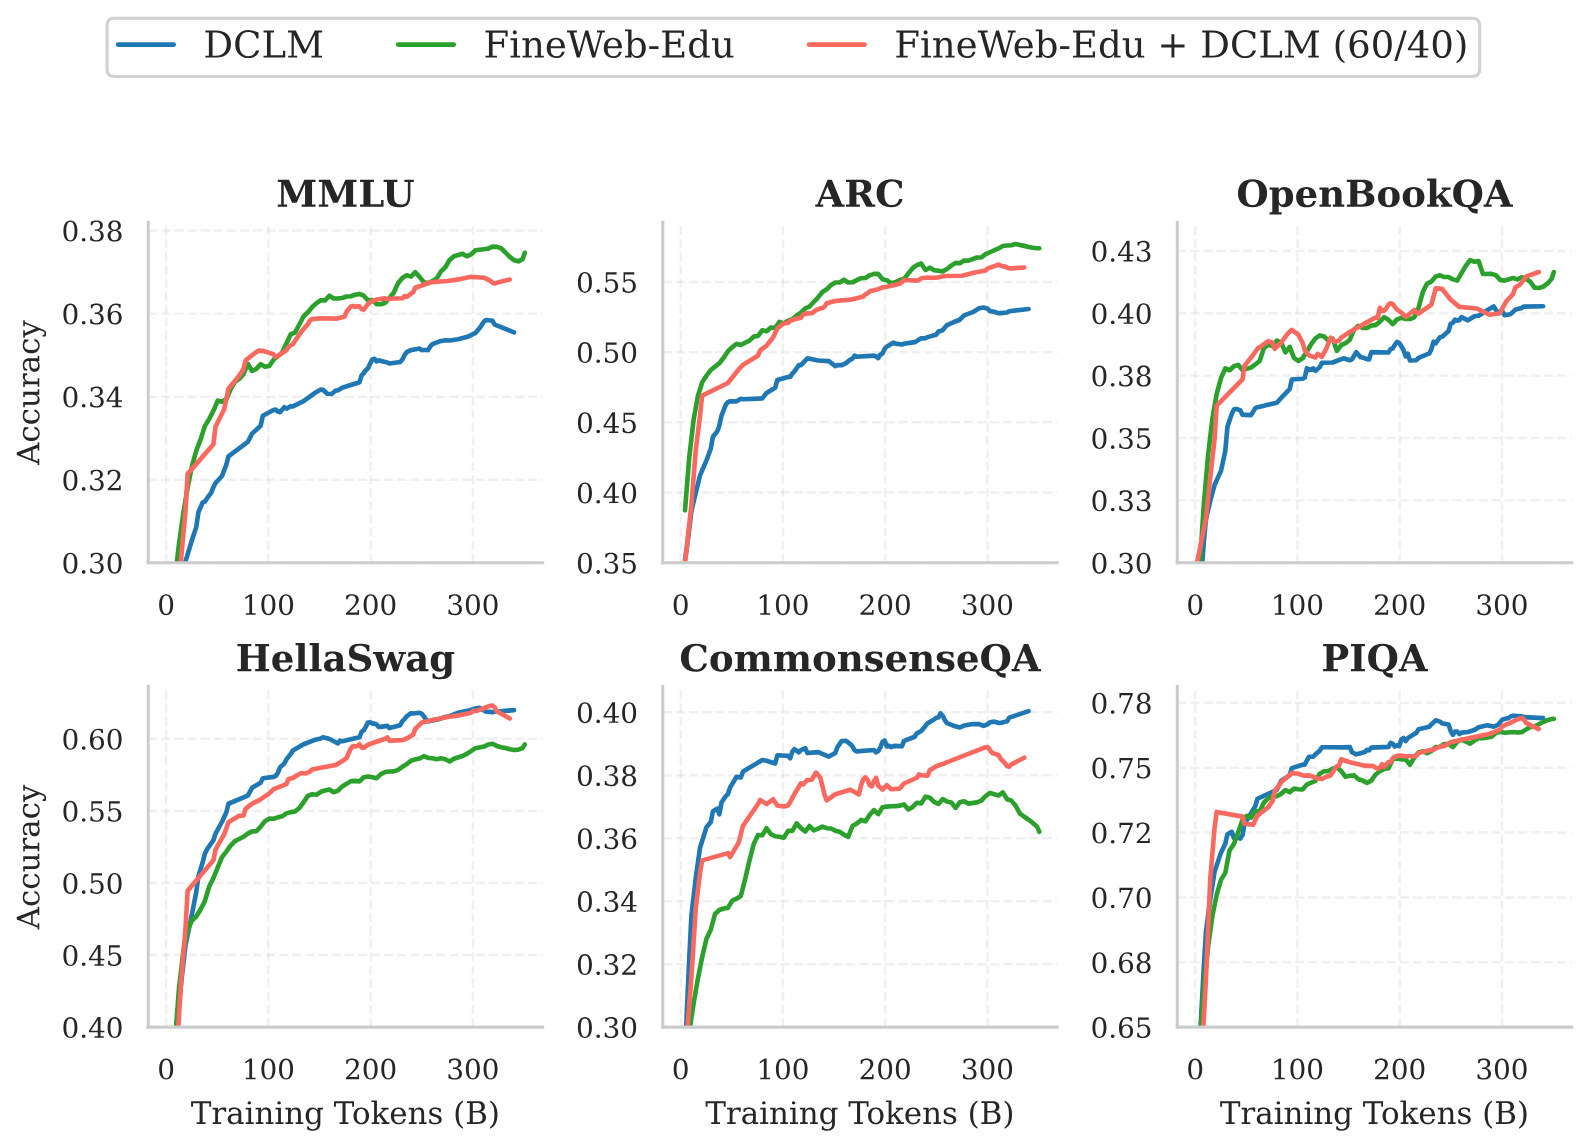
六张折线图标题依次为 MMLU、ARC、OpenBookQA、HellaSwag、CommonsenseQA、PIQA,横轴 Training Tokens (B) 从 0 到 300,纵轴 Accuracy;图例三条曲线分别为 DCLM、FineWeb-Edu、FineWeb-Edu + DCLM (60/40)
洗得干净,后面配比才有意义。如果数据里还大量重复和垃圾,你再怎么调比例,模型学到的也是噪声。
0202 造数据的边界在哪里
高质量数学和代码数据天然稀缺。FineMath3+和InfiWebMath3+加起来只有大概54B tokens,多语言的高质量语料也远少于英语。于是大家开始用合成数据补。
但合成不是随便生成就行。Meta团队做过大规模实验(超过1000个模型),发现纯教科书风格的生成数据单独用,在小预算下很多下游领域损失更高;重写型合成数据(rephrased)和自然数据混着用,最优比例常常收敛在30%左右。再高就容易出现多样性下降。
Marin那边最近也提到,他们大概25%左右是已知AI生成的数据,但前提是自然数据还得占健康比例。
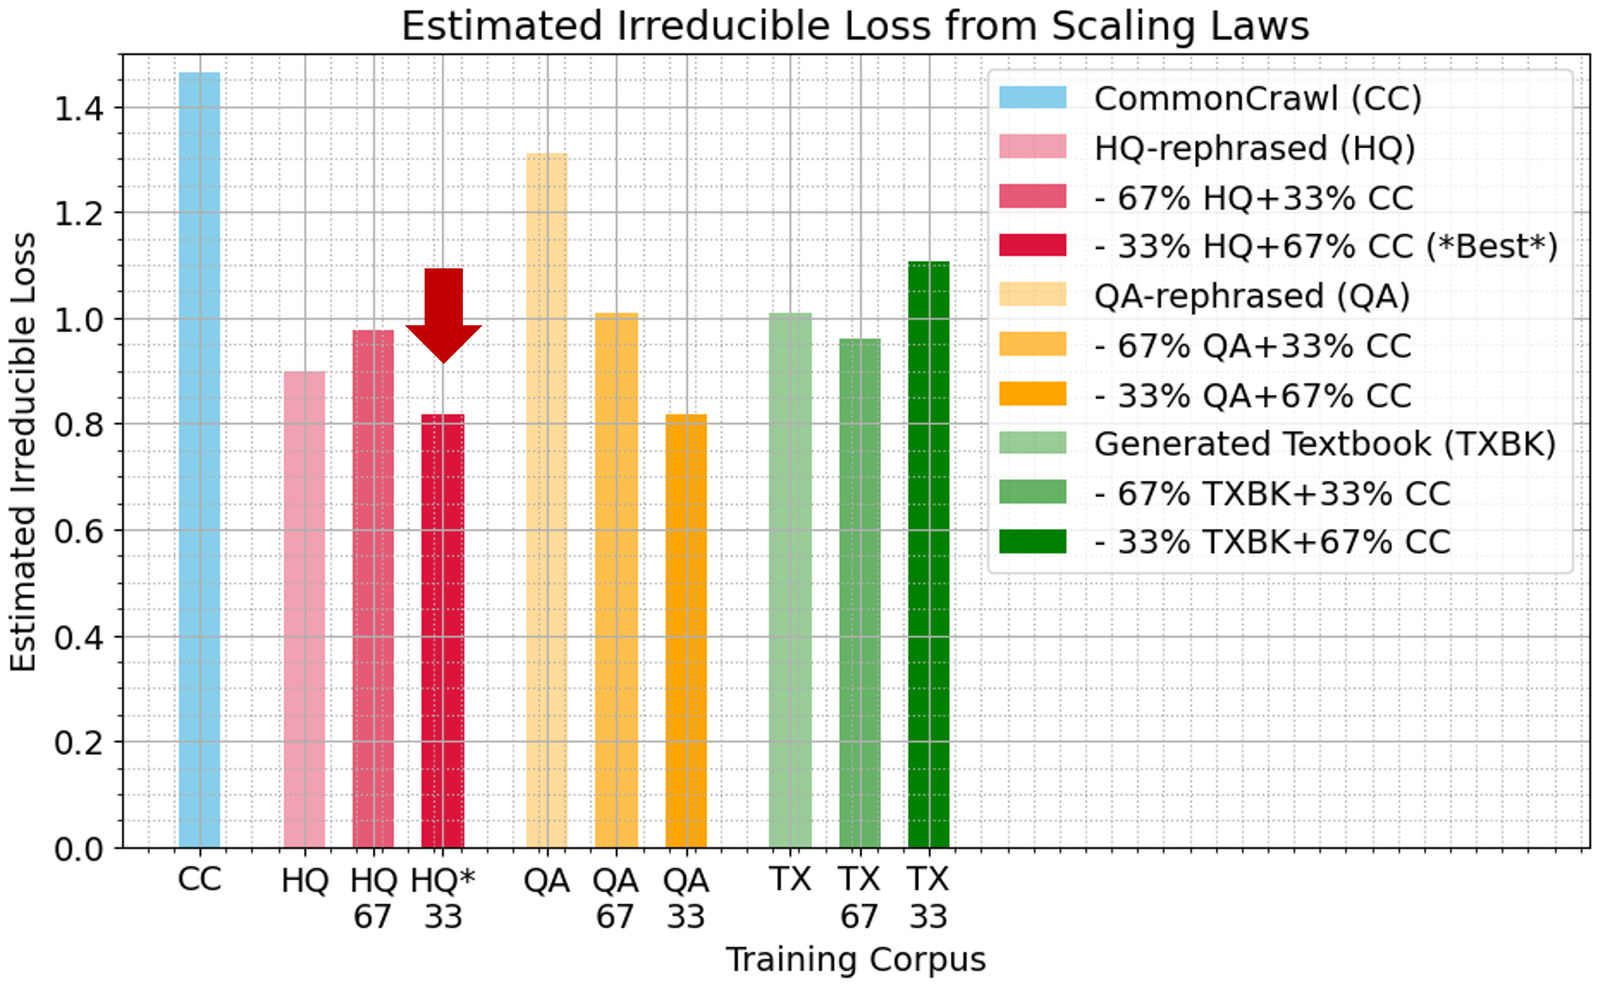
柱状图标题 Estimated Irreducible Loss from Scaling Laws,纵轴 Estimated Irreducible Loss 从 0.0 到 1.4,横轴 Training Corpus 列出 CC、HQ、HQ67、HQ\*33、QA、QA67、QA33、TX、TX67、TX33 共十根柱子;红色箭头指向 HQ\*33,图例列出 CommonCrawl (CC)、HQ-rephrased (HQ)、QA-rephrased (QA)、Generated Textbook (TXBK) 各自的 67% / 33% 混合,33% HQ+67% CC 标注 \*Best\*
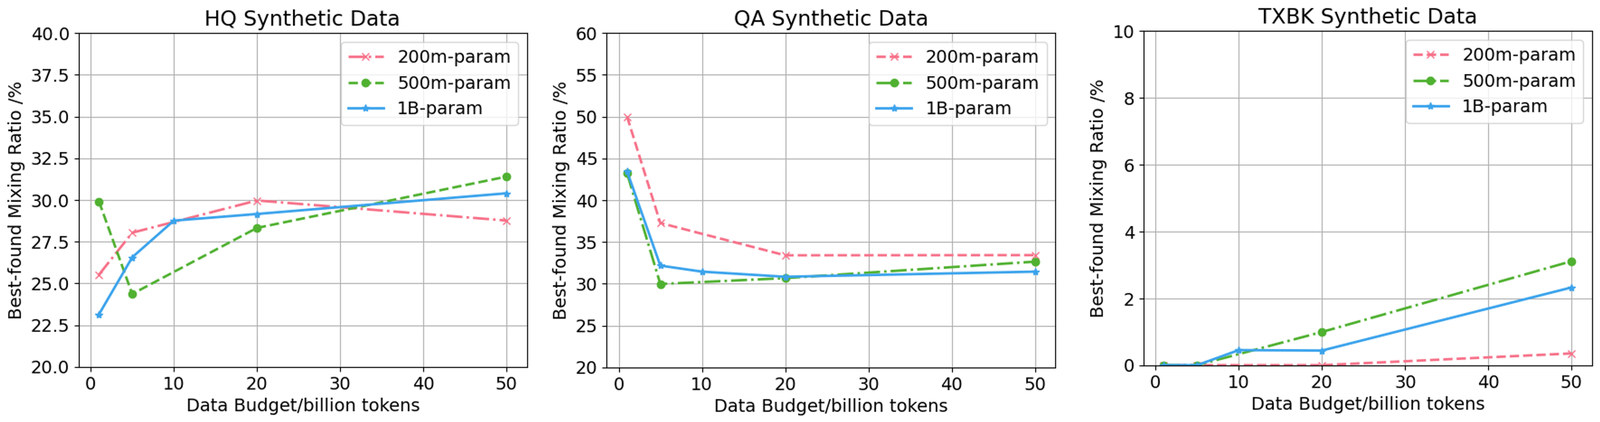
三张折线图标题依次为 HQ Synthetic Data、QA Synthetic Data、TXBK Synthetic Data,横轴 Data Budget/billion tokens 从 0 到 50,纵轴 Best-found Mixing Ratio / %;每张图三条曲线分别对应 200m-param、500m-param、1B-param;前两图纵轴为 20–60,第三图纵轴只有 0–10
造数据的核心是“可验证”。没有verifier或者明确标准答案,模型很容易学会作弊。这就是为什么现在高质量推理数据越来越依赖带验证的生成流程。
0303 配比为什么是最难的那一步
洗完、造完之后,问题就变成了:在固定的总token数下,web、代码、数学、多语言各占多少?
这听起来像买菜,但本质上是排课表。语文、数学、英语每门都重要,但一天只有24小时。你强行给数学加课,英语时间就被挤掉。大模型一样:总token固定,某类数据占比提升,其他类别必然被压缩。
更麻烦的是,配比上限往往不由你想要什么决定,而由“手里有多少不重复的好数据”决定。数学数据如果超过一定比例,就会被反复训练很多个epoch,模型开始记题面和答案分布,而不是学可迁移的推理。多语言也是同样的道理。
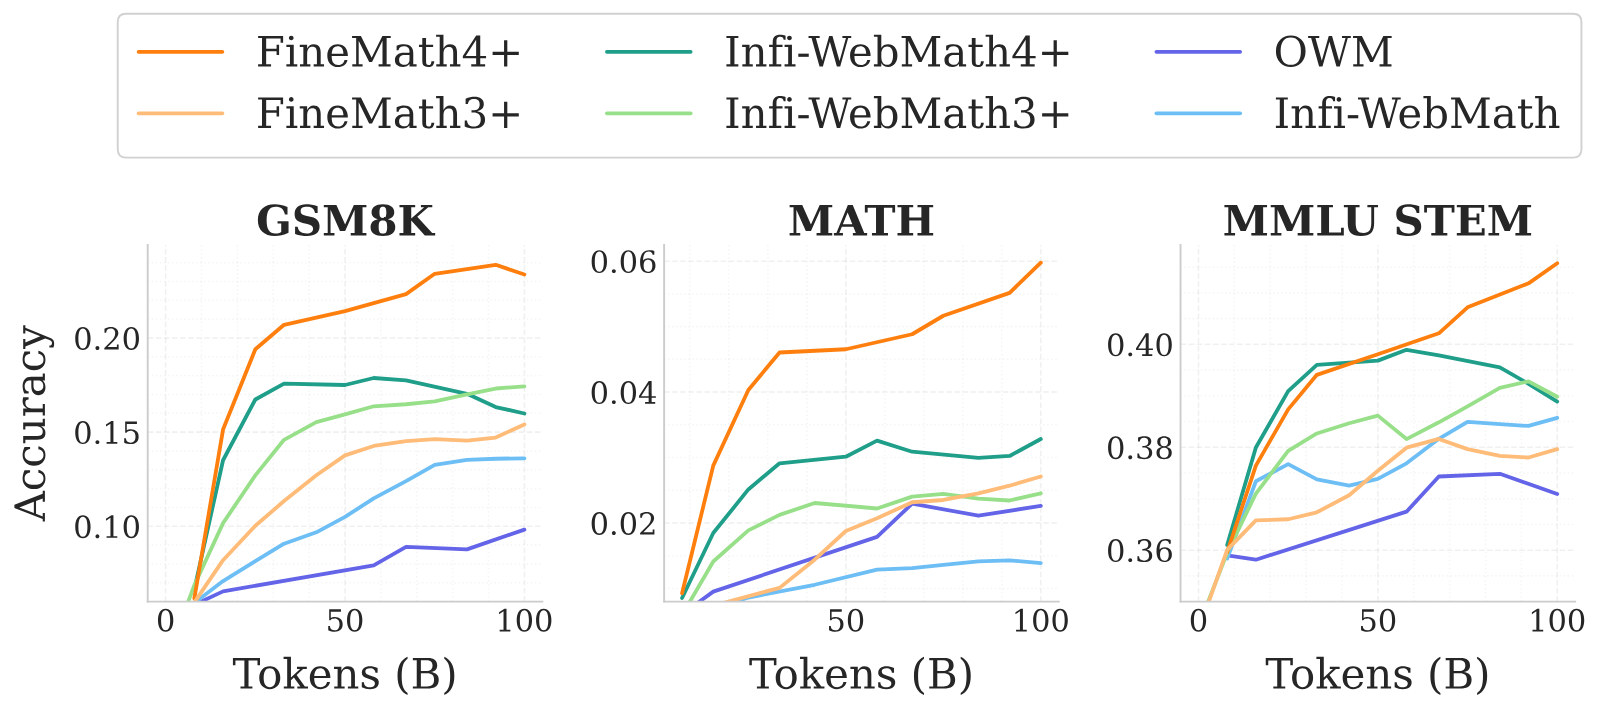
三张折线图分别为 GSM8K、MATH、MMLU STEM,横轴是 Tokens (B) 从 0 到 100,纵轴是 Accuracy;六条曲线分别标注 FineMath4+、FineMath3+、Infi-WebMath4+、Infi-WebMath3+、OWM、Infi-WebMath
SmolLM3是目前公开讲得最细的案例。他们第一阶段代码试过25%,英语基准明显掉;最后稳定在10%左右。数学卡在3%,因为库存就那么多。多语言消融出12%。这些数字不是拍脑袋,是在3B模型上反复跑消融得出来的。
但Smol只是开源团队能说出口的版本。大厂内部的情况更复杂:Llama 3最终大概是50%通用、25%数学与推理、17%代码、8%多语言,而且训练过程中还会动态调整。OLMo 2则明确做了两阶段,后期退火阶段切到更高质量的混合。
下一篇我们把配比这件事拆开讲:为什么要分阶段投放、退火消融是怎么省钱的、自动配比算法为什么还替代不了人工、以及那些隐藏的工程坑(比如loss spike到底是怎么来的)。
这些才是真正决定最终模型手感的东西。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
[1] SmolLM2: When Smol Goes Big — Data-Centric Training of a Small Language Model,arXiv:2502.02737,Figure 4
[2] Demystifying Synthetic Data in LLM Pre-training,Kang 等,EMNLP 2025,arXiv:2510.01631,Figure 3
[3] Demystifying Synthetic Data in LLM Pre-training,arXiv:2510.01631,Figure 4
[4] SmolLM2: When Smol Goes Big — Data-Centric Training of a Small Language Model,arXiv:2502.02737,Figure 1