大厂自建数据部门之后,外部数商还有活路?
大厂自建数据部门,收回的是验收权而不是全部产能。长程代码、高阶科学推理与专业 Agent 原创难题,反而被推给了外部数商。
DataMining · 2026年11月7日
今年下半年,国内数据行业出了几个挺明显的信号。
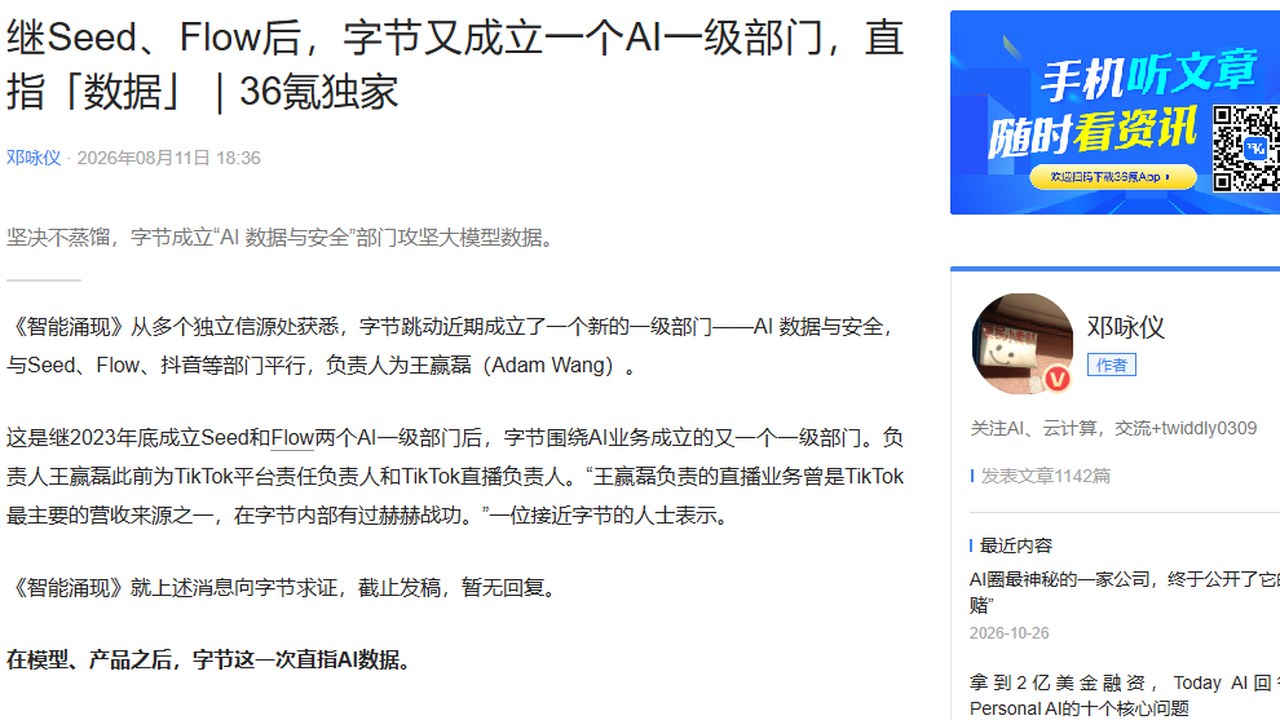
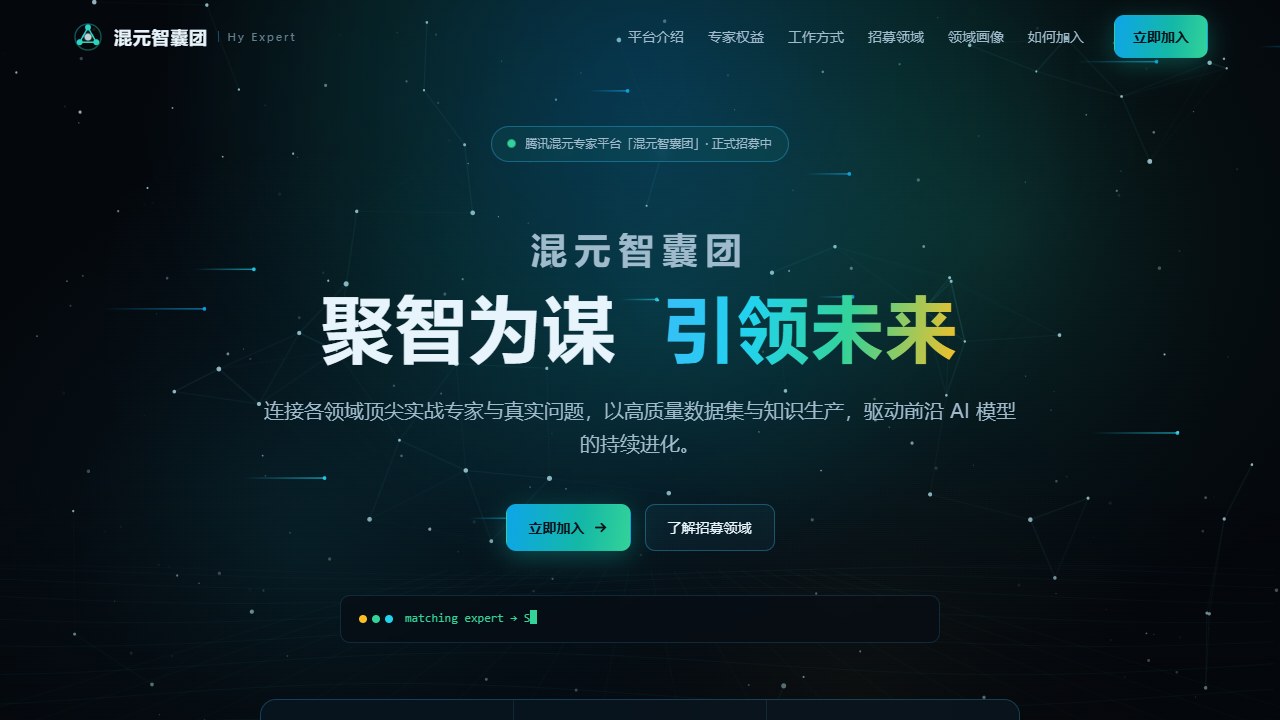
先是字节把原来的 Global Data 团队、集团数据中台 DMC 和 Flow 下面的 AI 数据平台 AIDP 合到一块,直接升格成了 "AI 数据与安全" 一级部门,跟 Seed、Flow、抖音平起平坐;紧接着 9 月下旬,腾讯混元自己上线了 "混元智囊团",公开招募十几个垂直领域的专家在线接单;再去翻翻阿里的招聘页面,40 到 60K 月薪招大模型数据采购专家,职责里明明白白写着要做供应商技术尽调、把采购品类从 "买数据" 转向 "买能力"。
很多做数据外包的朋友看到这架势,心里多少有点发慌:大厂既把数据部门升成了一级部门,又自己搭平台招专家,是不是准备把数据生产全部收回内部,外部数商的好日子要到头了?
要是你还指望靠以前那种 "攒几百个兼职大学生、按条数卖静态问答" 的路子赚钱,日子确实到头了。但如果你去看看大厂内部数据部门真正在干什么、卡在什么地方,就会发现大厂自建团队不仅没把外部数商的路堵死,反而在把那些真正高单价的硬骨头往外推。
0101
要搞清楚外部数商还能赚什么钱,得先看懂大厂自建数据部门到底接管了什么。
两年前,国内模厂买数据基本是散装的。哪个算法小组训模型缺数据了,组里的 researcher 自己找相熟的师兄弟或者外包团队下个单,几十万人民币的小项目,跑完觉得还行就继续加。那时候数商对接的其实就一个人 —— 那个急着用数据的算法工程师。
但现在预算到了千万美金级别,光是为 Seedance 配套的数据评测团队就已经上千人,原来的小作坊采购法根本转不动了。
字节把数据与安全升成一级部门,核心收回内部的是三样东西:标准制定、质检运营、安全合规。
换句话说,大厂自建团队首先接管的不是全部产能,而是 "验收权"。
现在一家外部数商再去大厂交货,面对的不再是一个好说话的算法同学,而是采购、质检、合规、算法四方会审:算法看这批数据放进小批量实验里能不能拉动评测集涨点;质检盯着抽检一致率和返工口径;安全合规查数据从哪来、经过谁的手、有没有跨境和版权风险;采购最后再来核算单价和排期。
大厂为什么要费这么大劲建这套常设组织?恰恰是因为它们发现,未来两三年内,外部采购不仅停不下来,规模还会越来越大。如果不先在内部把筛子立起来,几千万美金花出去,买回来的全是被污染的题库和注水的专家轨迹。
0202
那既然大厂自己都建了上千人的评测和数据团队,还搭了自营专家平台,为什么不干脆把生产也全包了?
道理很简单:大厂的内部编制和流水线管理,天然干不了 "高损耗、强专业壁垒、需求还忽高忽低" 的原创难题。
大厂自营的专家平台,管管日常的文本润色、常规翻译、基础代码打标和模型常规评测是非常顺手的。因为这些活有现成的标准,招几千个兼职按件计费就行。
但到了今年下半年,后训练真正卡脖子的地方早就变了。
比如模型现在急需补齐长程系统工程能力(像 Deep SWE、Frontier SWE 这类复杂仓库任务),或者高阶数理化多模态推理(像 HLE-VL 这类博士级科学难题)。
这种任务怎么造?绝对不是发个众包链接、让兼职专家填个网页表单就能交差的。
拿一道合格的 Deep SWE 原创任务来说,出题的人自己首先得是个懂大型软件架构的熟手。他得在几万行代码的真实项目里找到一个跨模块的复杂缺陷,不仅要把重现故障的依赖环境、测试数据集完整打包进一个可秒级重置的独立 Docker 容器,还得写好防作弊的独立评分器(verifier),最后用多个前沿模型交叉跑一遍,确认模型没法靠猜题或改测试脚本混过去。
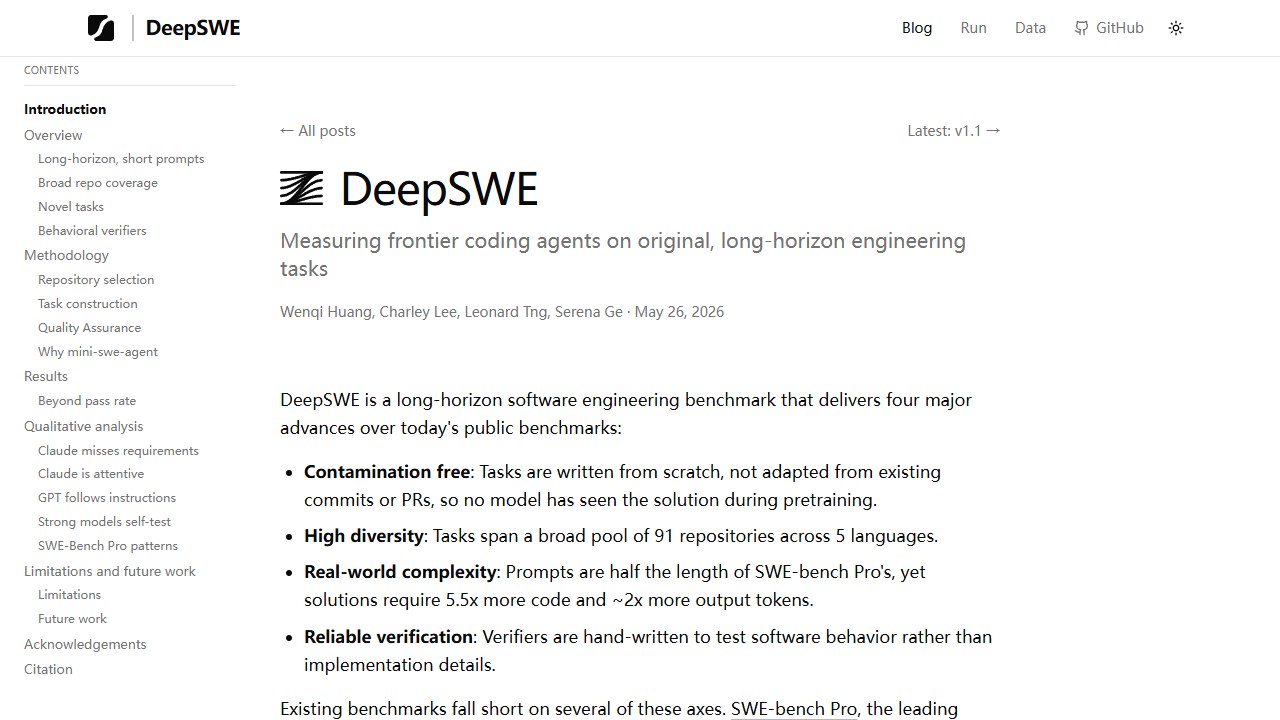
我们在做 Deep SWE 类任务数据对比时就拉过一组实测:拿同一前沿闭源模型去跑,它在我们构建的原创代码任务上的准确率(ACC),比当时对比的另外几家供应商同类数据要低 15 个百分点;而模型在我们数据上跑出来的智能体推理轨迹,平均要比其他几家长约 20 轮。
为什么别的供应商交上来的同类题,模型轻轻松松就能拿高分、十几轮就跑完,到了我们这儿准确率直接掉下 15 个百分点,还得逼着模型多跑 20 轮?
因为把题目做出 "看似复杂的表面工作量" 很容易,找外包按条数凑就行;但要把任务刚好卡在前沿模型的能力边界上,逼出它长程排查报错、跨文件回溯的完整轨迹,这完全是个科研级的精细活。大厂内部的运营团队背着月度吞吐量的 KPI,根本没法像攻克科研课题一样,让几个博士围着十几道题反复磨环境、抠边界。
0303
除了长程代码和沙箱环境,大厂内部团队更难自己消化的,是跨学科的复杂验证逻辑。
以前买数据,交付物就是一个 JSON 文件,左边是问题,右边是答案。现在买专业领域的后训练数据,最值钱的往往不是那个答案,而是 "怎么证明这个答案是对的"。
比如在多模态科学推理里,我们做过一批参照 HLE-VL 能力要求的有机化学和数学物理历史任务样例。
在反应能垒和立体选择性那道化学题里,模型必须同时读取反应路径能垒图(16.9 与 29.6 kcal/mol)和四象限空间位阻图,才能判断出正确的动力学分支和精确构型;在另一道材料题里,模型得先从给体 / 受体材料图像里选定结构状态,再按化学式单位去核算电荷转移和钌(Ru)的平均氧化态,最后输出三个相互约束的精确分数。
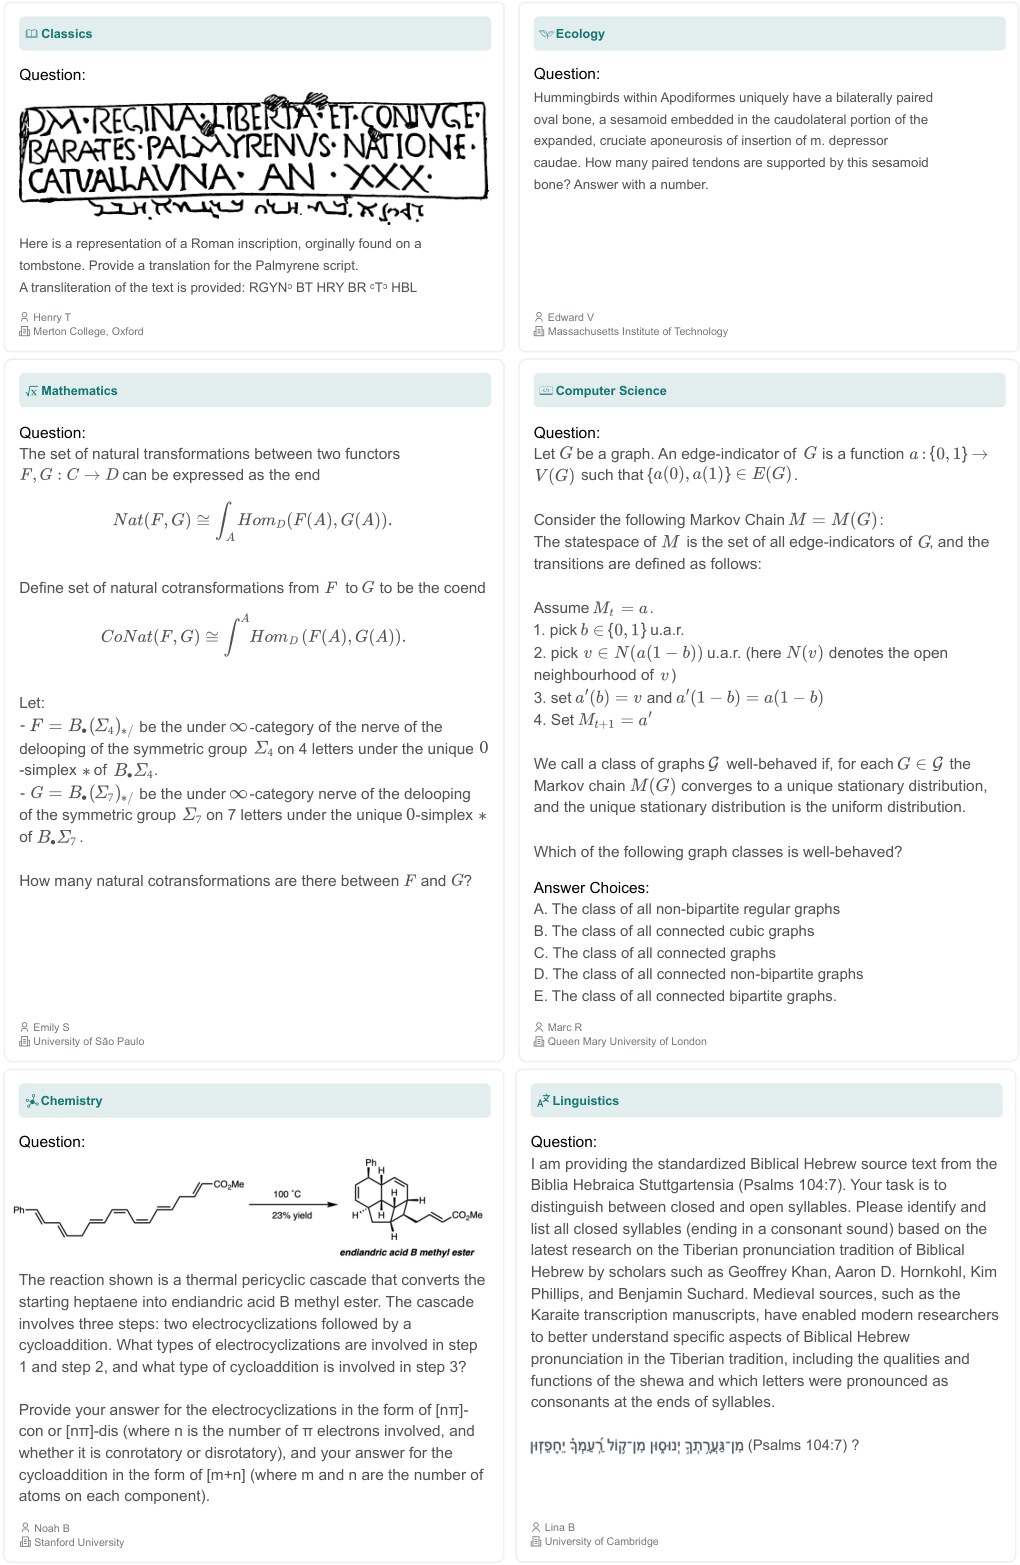
这类题如果交给普通的标注平台,连审题的人都看不懂图里的箭头和位阻代表什么,更别提去检查模型是在读图阶段看错了分支,还是在后续守恒计算里算错了化合价。它只能由竞赛教练和对应学科的博士生从头原创命题,再用求解器、多模型交叉验证和双盲专家复核一层层筛出来。
到了专业工作流 Agent(比如医疗流行病学调查、法律长文本尽调)和具身智能上,情况也是一样。
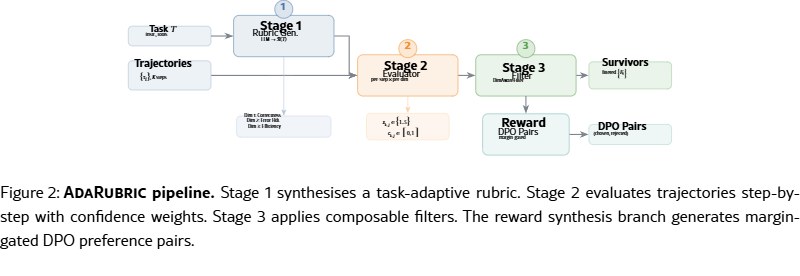
我们做过的一份公共卫生任务样例,要求模型读取五份原始材料(里面故意混了一份非必需的干扰表),输出两份 Word 报告和一份 Excel 汇总表。要验收这种任务,交付时必须连同十五项评分细则(Rubric)和专家证据索引一起给过去 —— 不仅要查三份文件里的数字能不能跨表对上,还要专门设置负向权重:只要模型把材料里没写的信息脑补成确定事实,直接扣分。
而在具身智能方向,无论是真机场景下的目标 grounding 标注,还是导航 DAgger 后训练里最缺的 "偏离状态纠错样本",都需要懂算法逻辑的团队盯着真机坐标和动作边界做双盲复核。
大厂不可能在内部同时养齐有机化学、拓扑纽结、流行病学、高速电路和机器人控制的全套博士命题组。某个专项能力这季度急需攻关,下季度可能就换了方向,在内部养庞大专职团队的账根本算不过来。
0404
这么一拆解,大厂自建数据部门之后,留给外部数商的活路其实非常清晰。
正在被迅速清退的,是夹在中间赚信息差和人头费的 "二道贩子"。以前靠关系从算法组拿个需求,转手发给地方标注基地或者兼职大学生群,抽三成水就交货的日子,在采购、质检、合规、算法四方会审面前,连第一关的试验批都过不了。
反过来,真正能接住大厂千万美金预算的外部数商,正在往两个方向收敛:
第一,是从 "按条卖数据" 转向 "按评测增量交钥匙"。大厂现在算账非常精,你的数据交上去,跑完消融实验(ablation),到底让内部 held-out 测试集涨了几个点?为此,数商自己手里必须先有懂模型训练和评测的算法团队,在交付前就把环境封装、反作弊测试、多模型交叉验证全部跑通,把废题和容易被钻空子的评分规则自己先筛掉。
第二,是死磕大厂内部流水线造不出来的 "高密度原创难题"。越是通用的环境(比如小米开源的那七千多个基础 RL 环境)越不值钱;越是卡在 SOTA 模型能力边界上的长程代码仓库、强依赖视觉结构的科学推理题、带严格证据核验的专业 Agent 工作流,溢价反而越高。行业调研里有结论,独家定制环境的价格是非独家通用环境的四到五倍,复杂软件工程任务单题就能卖到上万美金。
说到底,大厂把数据采购升成一级部门,不是为了消灭外部数商,而是为了结束数据行业过去两年的草莽期。
以前这行拼的是谁能快速凑齐五万个注册专家的数字,哪怕里面一大半人连题目都看不懂;以后这行拼的,是谁能真正拿出让前沿闭源模型和 Claude 都得折腾几十轮才能啃下来的硬骨头。当买方手里的尺子变得足够专业、足够硬的时候,那些只靠攒人头混日子的外包商自然会退场,而真正懂模型短板、能从头造出 "真问题" 和 "严判据" 的技术型数商,反而迎来了最好谈价格的时候。
我们(DataMining /datamining.cloud)由北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据,曾为字节跳动、阿里巴巴、腾讯等头部科技企业提供数据服务。如果你们的数据或算法团队正在构建复杂代码(Deep SWE / Frontier SWE)、长程专业 Agent、HLE-VL 级数理化多模态推理或具身智能的训练与评测集,欢迎围绕具体的目标能力和验收标准与我们交流原创任务数据需求。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境,曾为字节跳动、阿里巴巴、腾讯等头部科技企业提供数据服务。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE-VL 严格多模态产线;Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线。 如果你们的数据或算法团队正在构建复杂代码、长程专业 Agent、HLE-VL 级数理化多模态推理或具身智能的训练与评测集,欢迎围绕具体的目标能力与验收标准与我们交流原创任务数据需求。 🌐 官网:datamining.cloud|📮 样例申请与技术对接:contact@datamining.cloud
📚 配图来源
36 氪:36kr.com/p/3934936980667776
DeepSWE 官网:deepswe.datacurve.ai/blog/deepswe
Humanity’s Last Exam,arXiv:2501.14249v8,Figure 2 原图
AdaRubric,arXiv:2603.21362v1,Figure 2 原图
腾讯混元智囊团:hyexpert.tencent.com
以上 5 张均为新闻页面或论文公开原图,按行文顺序插入;图注只描述画面可见内容。