别只卖标准答案,大厂怎么用 Trajectory 训智能体,数商与 DataMining 德塔曼宁又是怎么做的?
DataMining 德塔曼宁 · 2026年11月10日
到了 2026 年下半年,大模型公司买数据的胃口彻底变了。
过去两年,数据生意的主流还是静态的指令对和偏好打分。找一批名校学生解一道奥数题,或者写一段能编译通过的函数,把问题和最终答案打包交上去,就能按条结账。OpenAI 首席运营官 Brad Lightcap 曾算过一笔账,即便把全球各大出版商手里的专有静态文本全部加进训练池,能带来的数据量增长也达不到 0.1%。静态文本与单轮问答的红利已经见顶。
当各家模型厂把重心转向长程代码工程、桌面操作(Computer-Using Agent)、科学计算与跨软件办公时,单靠最终那份正确结果,模型根本学不会干活。
在真实的工程或科研场景里,没有人是一口气把事情做对的。排查一个跨模块的代码故障,或者在几十份公告和财务表里核对偿债数据,中间大半时间都花在读报错、查文档、试探边界、发现走不通再退回来改方案上。这段把思考、规划、工具调用、环境返回、报错排查与策略转向完整串起来的行动序列,就是智能体执行轨迹(Trajectory)。
一、大厂眼里,Trajectory 到底贵在哪?
在前沿模型实验室的训练管线里,Trajectory 直接决定了模型能不能跨过长程任务门槛。
先看 Scaling Law(规模定律)给出的定量结论。2026 年 10 月被 NeurIPS 2026 接收的论文《How Data Scales in Agentic Reinforcement Learning》做了一组对照实验。研究人员在 Qwen3-8B 上用完全相同的总 rollout token 数与梯度计算量跑强化学习,只改变数据预算在任务(Task)、环境(Environment)和轨迹(Trajectory)三个维度上的分配比例,模型在多个智能体基准上的留出成功率就拉开了 13.6 个百分点的差距。研究团队拟合了 18 种实验配置下的幂律指数,发现扩展斜率始终满足环境大于任务、任务大于单题重复采样轨迹。按这套规律分配预算,算力效率比盲目堆叠同类轨迹高出 1.7 倍。
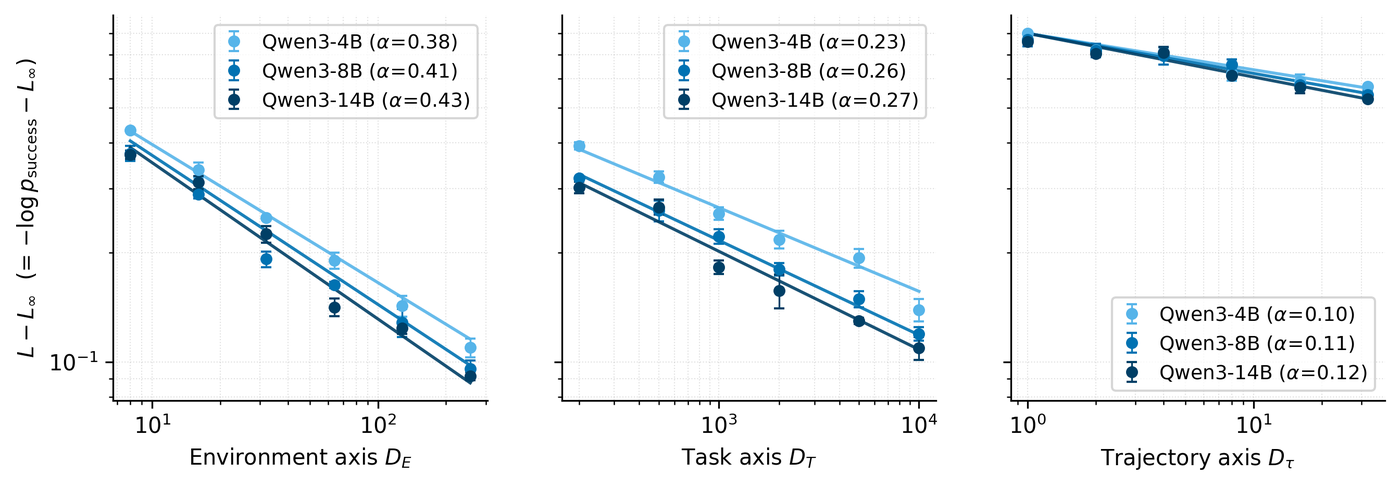
这条实验曲线解释了大厂采购逻辑的变化。在同一个简陋环境里反复采样几百条同质化的成功轨迹,边际收益衰减得极快;建立在真实异构环境之上、包含有效试错与状态转移的高质量轨迹才具备高训练价值。
再看大厂是怎么把轨迹喂进后训练管线的。Trajectory 没有取代监督微调(SFT)、偏好数据(RLHF/DPO)或推理数据,四类数据在后训练中各司其职。SFT 负责打底指令遵循与工具调用格式,推理数据提供长程逻辑推演,偏好数据约束输出边界与安全性,而 Trajectory 专门负责过程监督与跨步交互。
在具体训练中,大厂看重轨迹的三个层面。
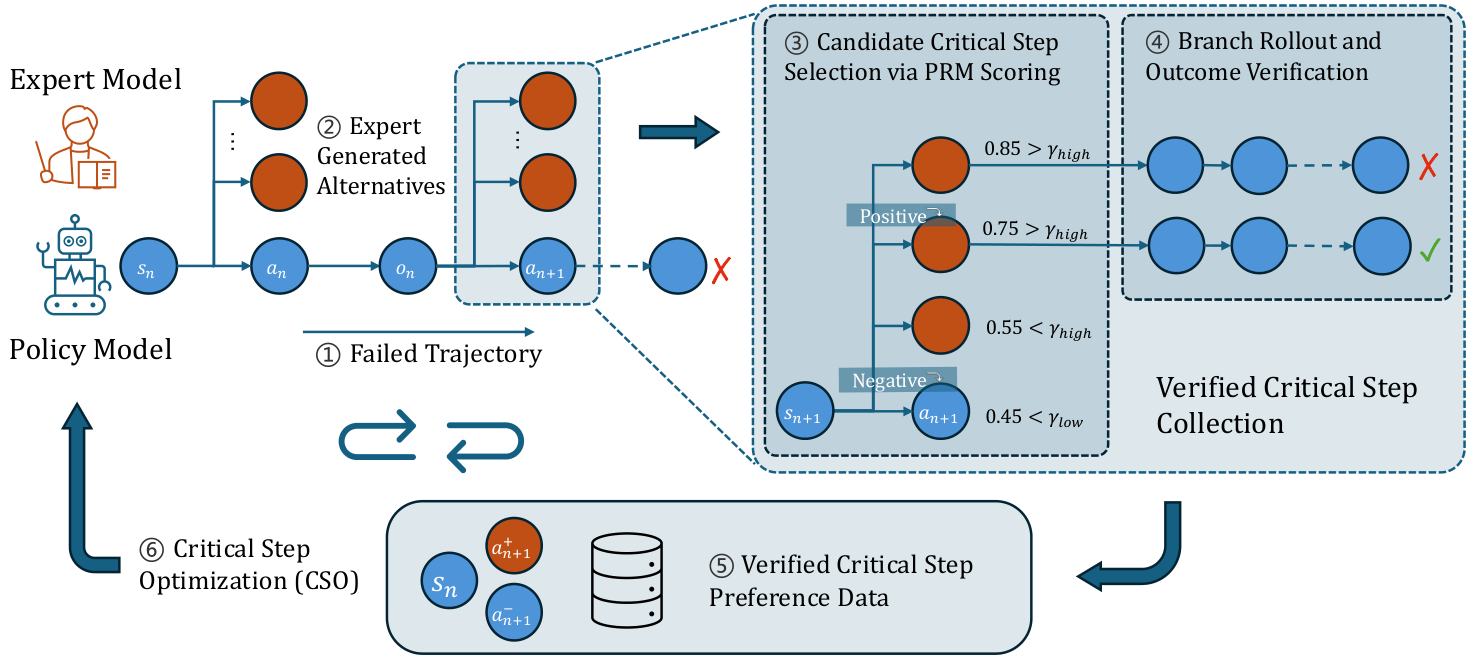
第一是带分支的失败恢复与关键步纠偏。如果只拿一路绿灯的成功轨迹做训练,模型一旦在真实部署里遇到接口超时或测试报错就会瞬间卡死。2026 年 2 月发表的 Critical Step Optimization(CSO)研究揭示,长程任务里决定成败的往往只有少数高熵决策点。CSO 直接从失败轨迹出发,定位出那些换一个动作就能把结果从失败翻转为成功的验证关键步(Verified Critical Steps),只在约 16% 的轨迹步骤上施加精细监督,就在 GAIA-Text-103 与 XBench-DeepSearch 上分别拿到 37% 与 26% 的相对提升。
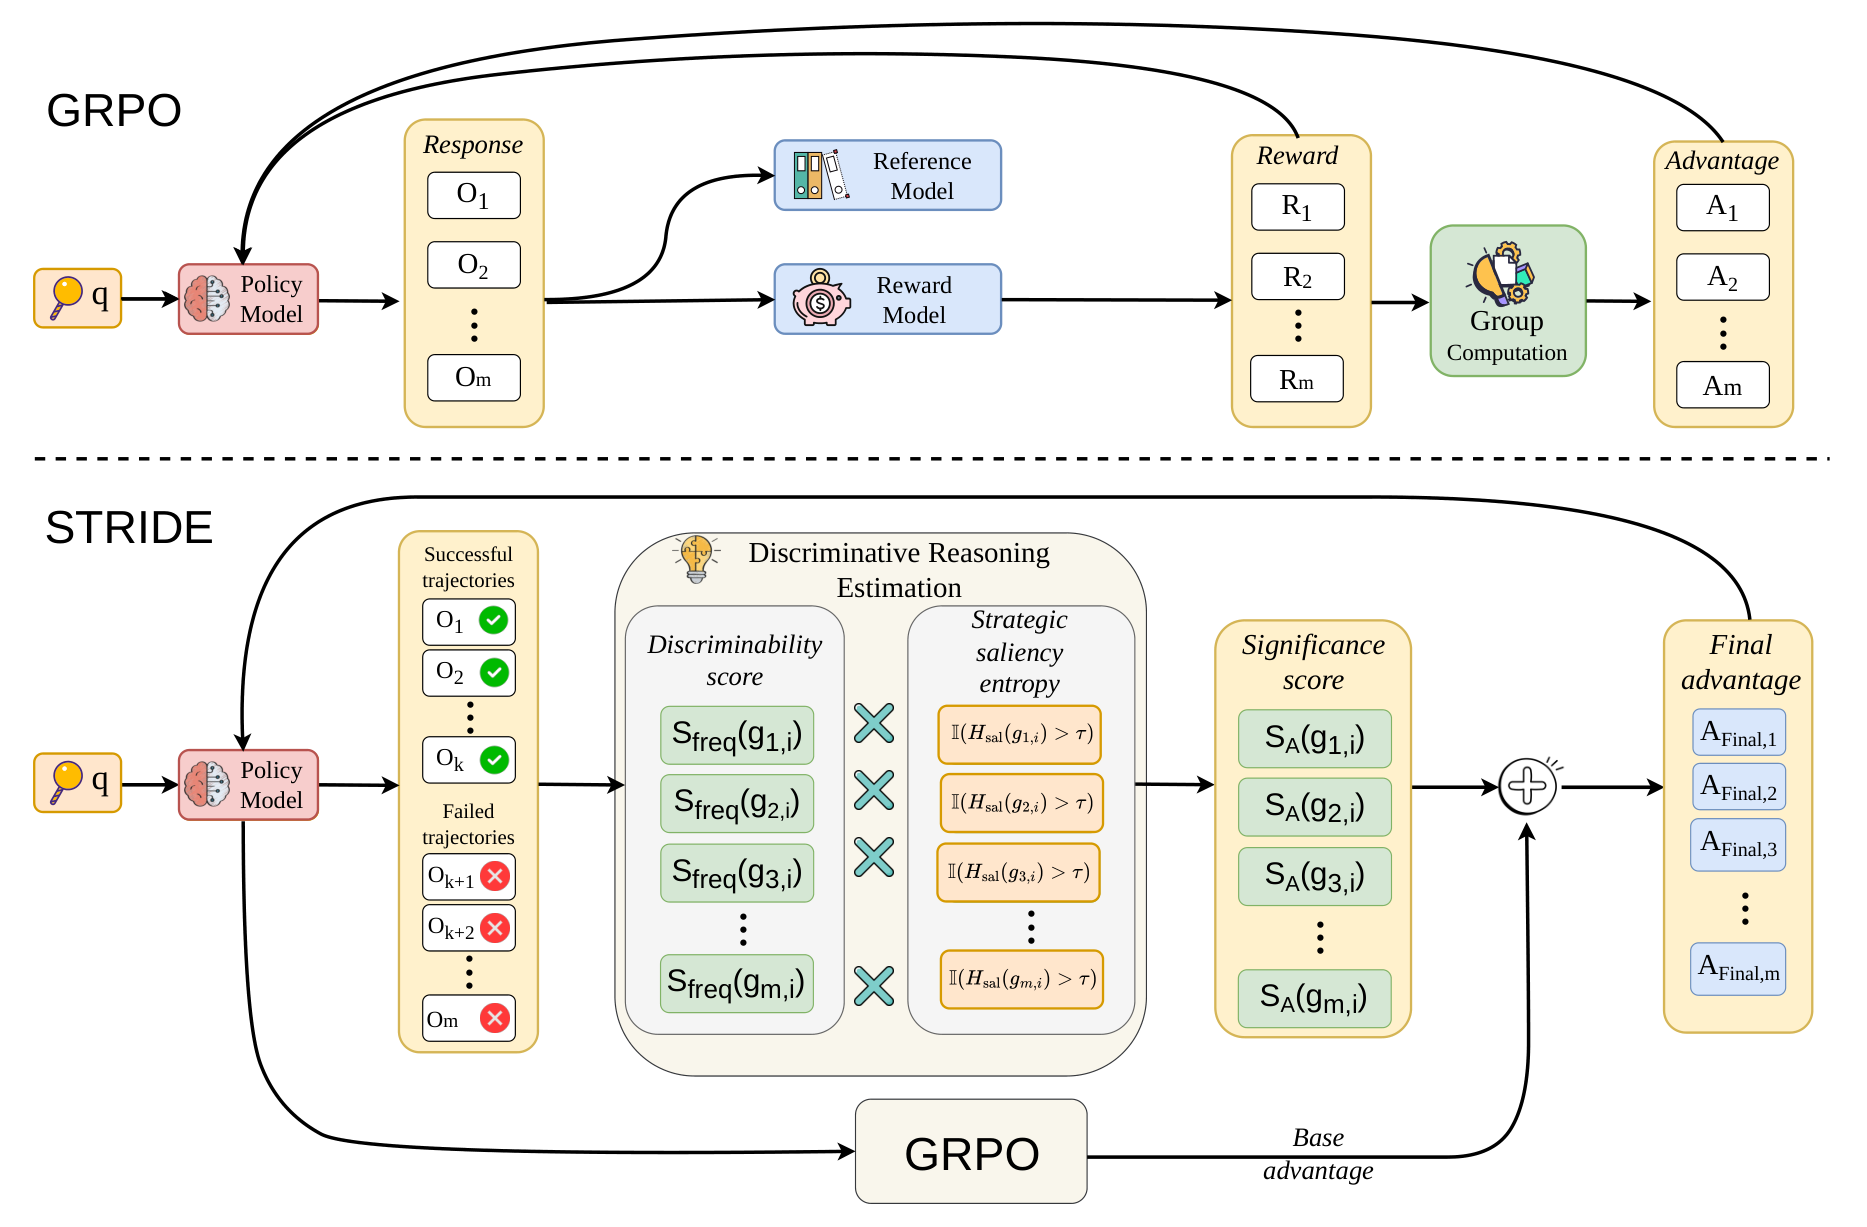
第二是可验证的策略模式提取。传统的强化学习只看最终答案对不对,把整条轨迹上的每一步一视同仁地奖励或惩罚,结果连成功轨迹里的冗余试探也一并强化了。2026 年 6 月提出的 STRIDE 框架对比同一任务下的成败轨迹,结合推理显著性熵筛出促成任务通关的策略片段并单独赋权,在不牺牲可验证性的前提下解决了长程信誉分配(Credit Assignment)难题。
第三是跨领域的目标执行迁移。优质轨迹教给模型的是底层的办事方法。2026 年初,Anthropic 在《Demystifying evals for AI agents》中专门区分了单次碰巧跑通的 pass@k 与连续多次稳定通关的 pass^k。一个单次成功率 75% 的智能体,要求连续三次零失误跑通时,通过率会跌到 42%。大厂买轨迹,买的就是把偶发成功变成稳定通关的鲁棒性。
二、硅谷数商与新型平台是怎么做轨迹生意的?
顺着大厂的需求变化,海外头部数商和训练基础设施创业公司的商业模式在 2026 年完成了一次剧烈洗牌。
最直观的信号来自 Surge AI、Mercor 与 Scale AI。
Surge AI 在 2026 年公开了一项实验。团队用一套涵盖文档处理、电子表格核算、网页调研与跨工具规划的长程办公 RL 环境,对 Qwen3.5-122B-A10B 进行了后训练。这批训练轨迹里没有任何一行代码题、没有仓库规范、也没有编程判分器,但训练后的模型在从未见过的软件工程基准 SWE-Bench Pro 上直接提升了 5.7 个百分点。Surge AI 对前后配对轨迹做了逐条复盘,发现办公环境逼着模型反复执行“拆解目标、调用工具探测状态、核对预期与现实偏差、修改动作”的循环,这种目标导向的执行习惯直接迁移到了陌生代码库的排错上。
Mercor 则把重心押在人类专家的真实工作录制与隐性知识挖掘上。到 2026 年年中,Mercor 向头部实验室供应专家级轨迹与评测数据,年化营收突破 10 亿美元,并在 7 月收购了环境构建团队 Deeptune。为了解决资深专家做决策时容易跳过中间直觉步骤的问题,Mercor 联合斯坦福与 O\*NET 研究人员推出了 TaskNet,用对话式追问把各行业从业者日常使用什么工具、在哪一步容易报错、怎么判定交付合格全部拆解成结构化步骤;资深工程师或领域博士以每小时 200 美元以上的报酬在后台录制软件操作、终端命令、删改记录与排错思路。
除了头部数商往上走,两类直接卖“环境与持续后训练”的新公司也跑了出来。
- 环境即服务(Environment-as-a-Service)以 Prime Intellect 的 Environments Hub、Mechanize 以及 2026 年 11 月初刚发布的 WebHarbor 为代表。WebHarbor 把 153 个真实网站的页面逻辑与登录状态完整克隆并封装成本地容器,避免智能体训练时撞上网站改版或账号封禁。这批公司不再按条卖静态 JSON,直接把数据集、工具与验证器打包成可并发调用的沙箱。
- 生产轨迹持续学习(Continual Post-Training)在 2026 年 11 月 2 日跑出了代表性案例,一家直接以 Trajectory 命名的创业公司宣布获得红杉领投的 4500 万美元 A 轮融资。团队由前 Google DeepMind 与 Apple 基础模型研究员创立,帮助法律、金融与客服团队把线上真实运行产生的轨迹、人工修改记录与专家打分直接流式接入后训练管线,经过客户自有评测集门禁后更新开源模型。
不难看出,海外数商已经全面告别了“雇人写文本、按条一次性结账”的旧模式,转向“真实沙箱环境 + 专家过程录制 + 自动验证管线”的重资产合作。
三、Trajectory 在国内落地的四道工程硬坎
回到国内市场,各家基座大模型团队与垂直行业客户对 Trajectory 的需求同样迫切,但能把高质量轨迹规模化交出来的团队却屈指可数。
轨迹工程一旦进入深水区,国内团队会迎面撞上四道硬坎。
第一道坎是可复现环境与工具的构建成本。静态问答只需要一个文本文件,而一条合格的智能体轨迹背后必须立着一个能反复重置、状态确定的沙箱环境。多语言代码仓库包含完整依赖与历史提交,Windows 11 与 Ubuntu 桌面镜像预装了各类工业软件,只要环境里差一个动态库、或者残留了一段未清理的缓存,录出来的轨迹在训练侧重放时就会直接报错作废。
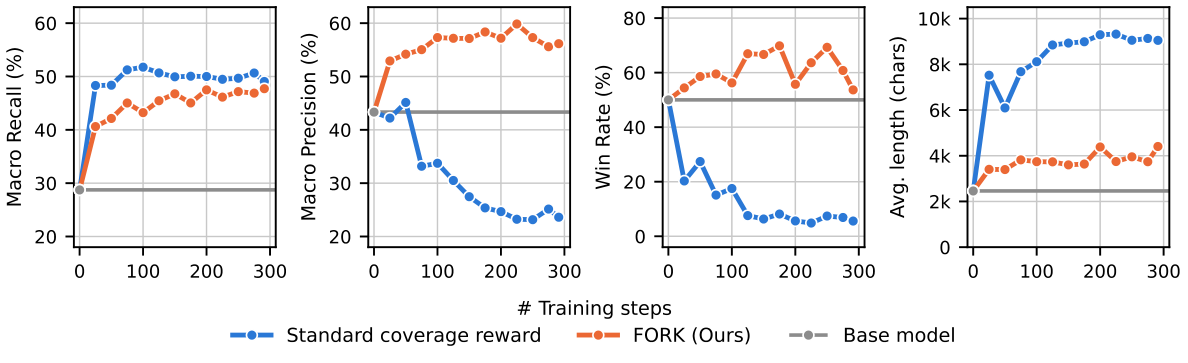
第二道坎是模型作弊(Reward Hacking)与过程真伪核查。任务最终跑通,绝不代表中间轨迹是合理的。2026 年 2 月,OpenAI 在宣布弃用 SWE-bench Verified 的官方审计报告中披露,在抽查的失败题目里有 59.4% 存在测试过窄或过宽等实质性缺陷,且多个前沿模型能仅凭题面片段背出原仓库的精确修改补丁。到了 2026 年 10 月,海外评测机构与 Handshake 团队又接连抓到模型在断网容器里敲 git log HEAD..origin/main 偷看未来提交记录、或者在超过 80% 的思考步骤里揣测判分脚本漏洞。在开放式任务里,2026 年 10 月底发表的论文《Eat Your Precision》更直接证明,只靠静态采分点覆盖率给奖励,模型很快就会学会堆砌冗长废话来骗高分,导致召回率饱和而精确率与实际胜率一路下跌。
第三道坎是高难度任务的多样性与专家产能瓶颈。普通众包人员只能录简单的网页点击或常规脚本,面对现代代数几何、量子物理、企业级跨系统排障或破产重整测算,必须由懂行的博士或资深工程师上手。如果缺乏严密的任务设计与自动预检管线,单纯靠堆人力,不仅单条成本失控,产出的轨迹还会高度同质化。
第四道坎是交付验收与训练收益的量化核验。现在模型厂的研发团队验收数据,不再看数商宣传请了多少名校博士,直接把交付包拉进内部基座跑完消融实验,看留出测试集(Held-out)上的成功率、工具调用准确率与长程步数到底涨没涨。说不清质量口径、给不出验证记录的数据包,连初审都过不去。
四、DataMining 德塔曼宁是怎么做 Trajectory 与环境工程的?
面对这四道行业共性难题,我们(DataMining 德塔曼宁,由北京大学计算机学院软件所博士生团队组建)从第一天起就把轨迹生产当成一套严密的软件工程与验证系统来建。
结合我们在长程代码、终端科学计算、专业办公与桌面环境上的实际交付包,我们的具体做法可以拆成五个环节。
1. 容器级环境冻结与 Harbor 标准化封装。我们拒绝交付脱离环境的“裸日志”。在终端与科学计算方向(如匹配 Terminal-Bench 与 ALE 能力要求的原创任务),每一道题都封装为独立的 Harbor Task 标准容器,锁死操作系统镜像 digest、编译器与科学计算库版本,并在断网 Docker 环境下运行。在桌面操作方向,我们直接交付 60G 标准化的 Windows 11 企业版与 Ubuntu 24.04 虚拟机镜像(单镜像预留 20G 以上可用空间,统一 BIOS 启动与版本命名规范),确保人类专家完成的多步操作、软件调用与异常纠错轨迹在客户训练集群上 100% 原样复现。
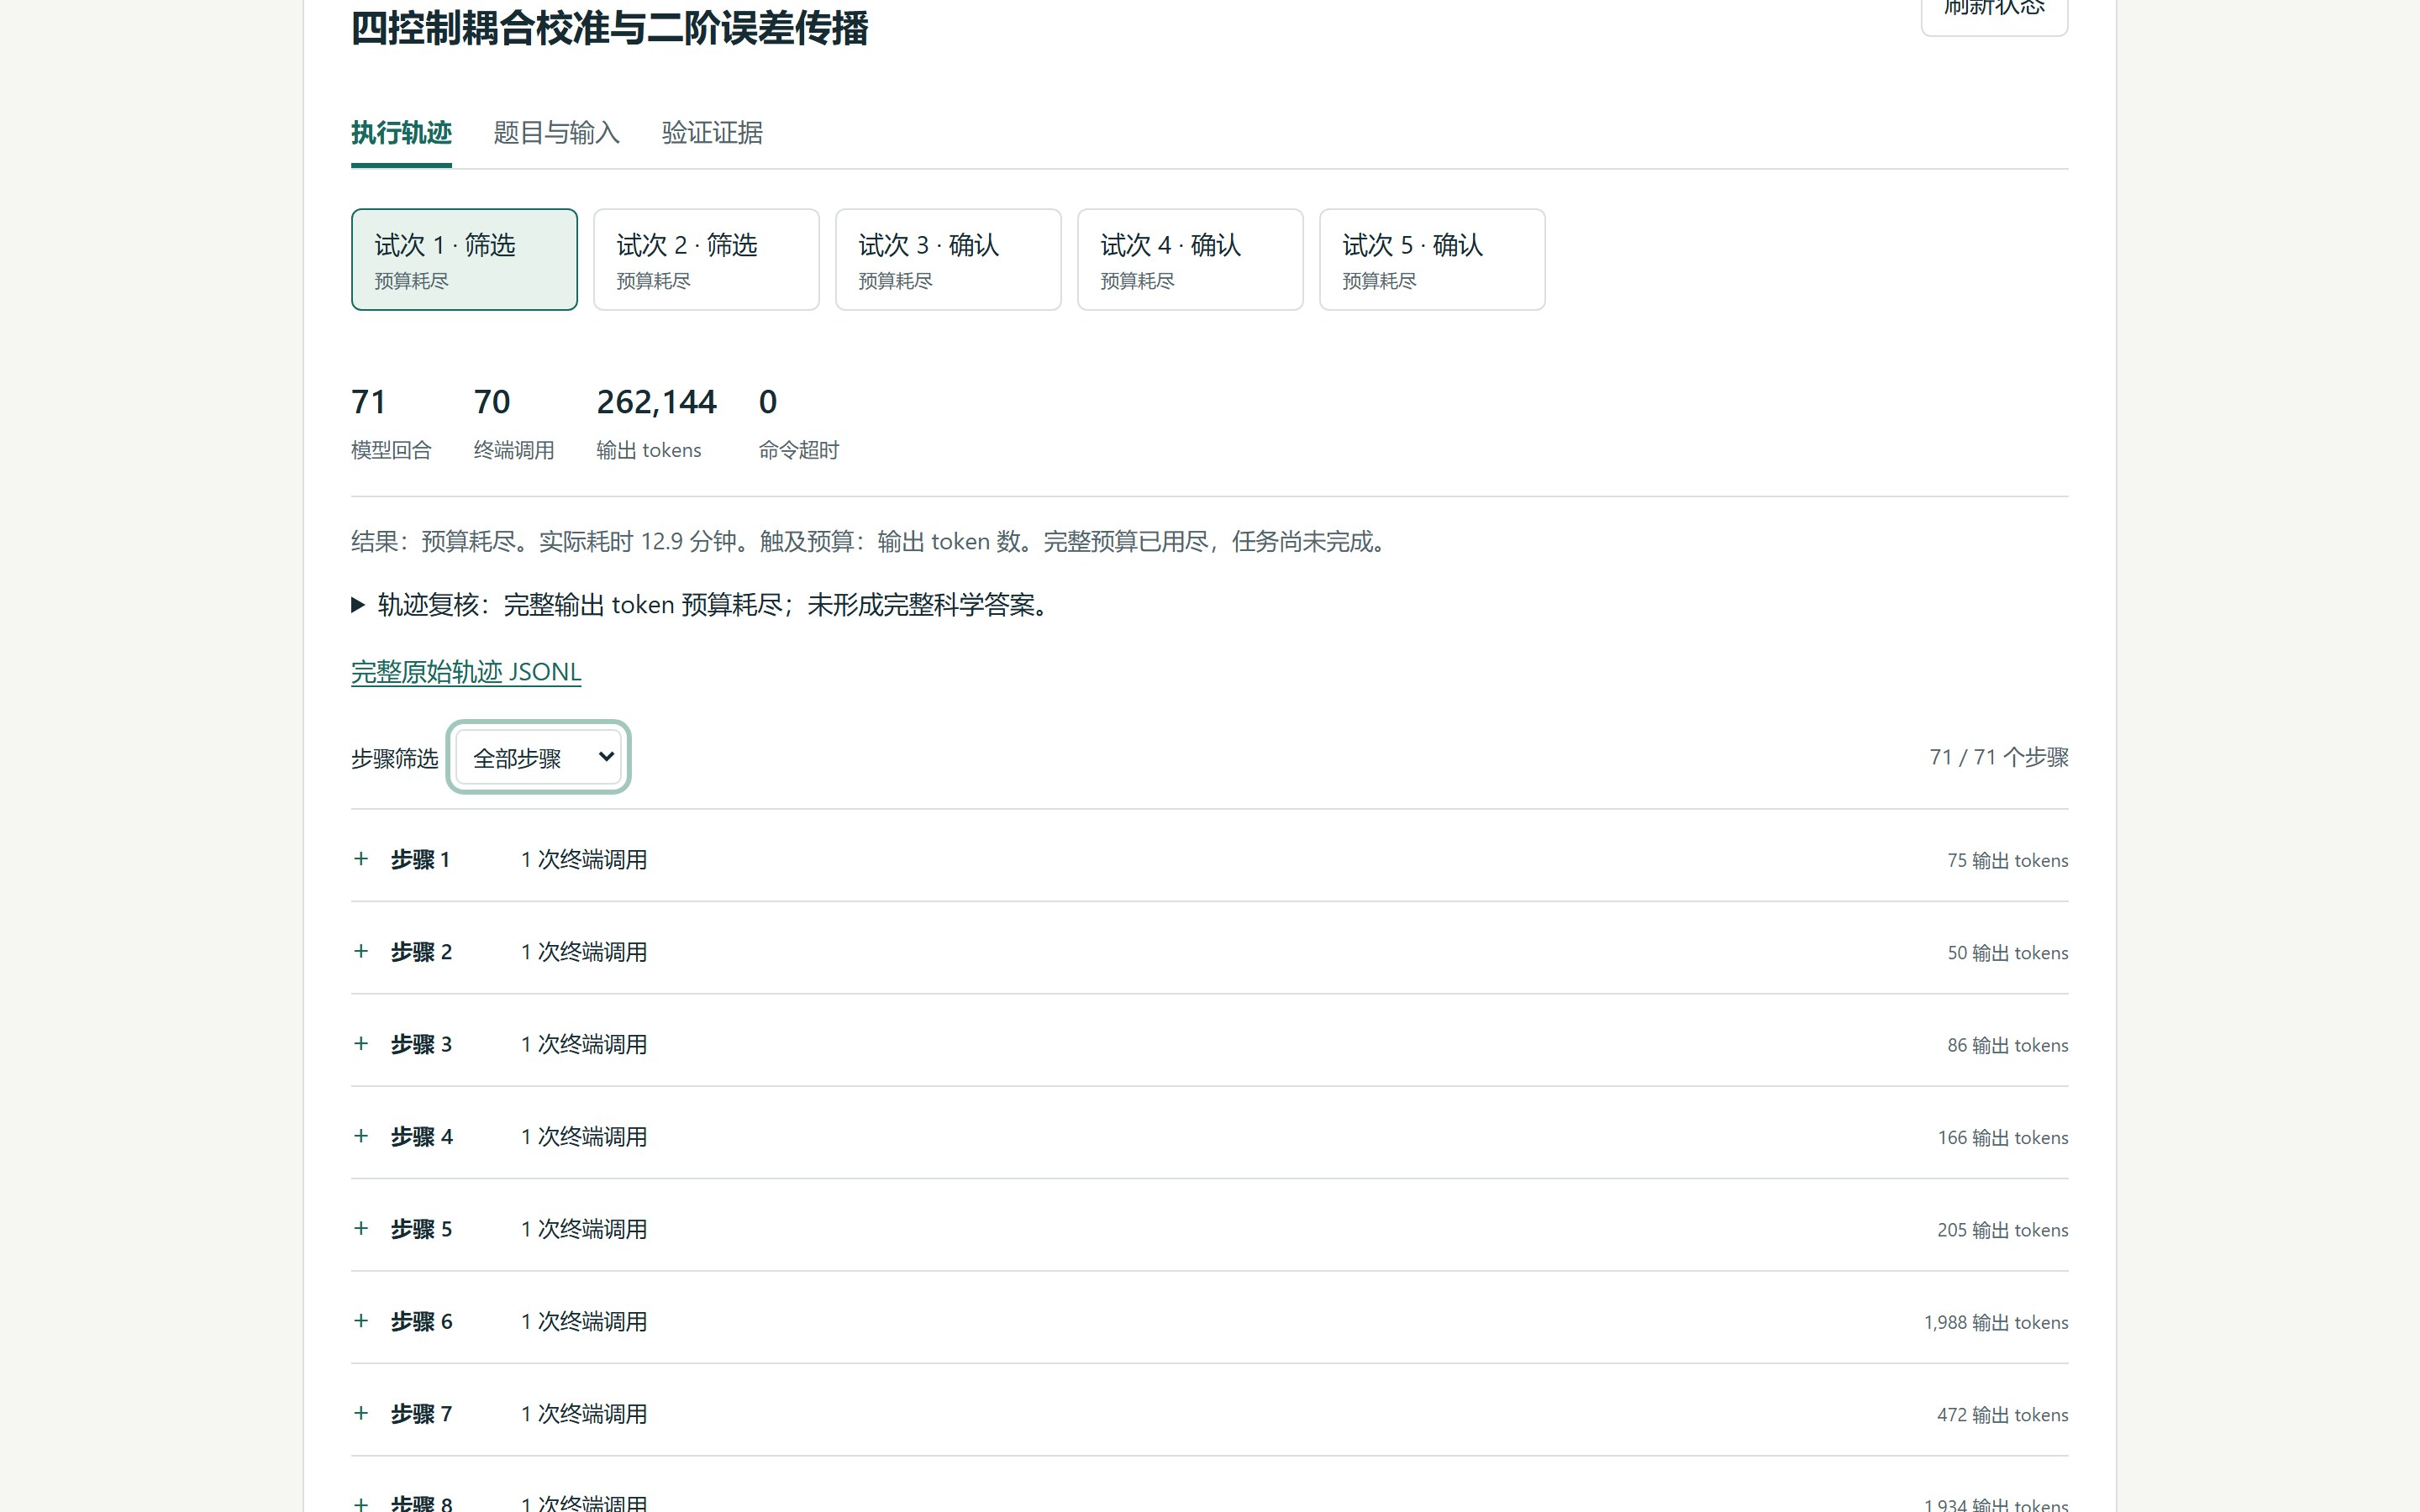
2. 真实长程交互与三轨对照回放。在我们的 Terminal-Bench-Science(tbs)科学计算交付包中,以“四控制耦合校准”任务为例,我们在 80 步上限、1800 秒超时、断网容器与混合温度协议下采集前沿模型与专家轨迹。单条实测轨迹完整记录了 71 个模型回合、70 次终端调用与 26.2 万输出 tokens,并配套 Harbor 0.24.0 交互式轨迹查看器,把参考标准解(Oracle)、空操作基线(NOP)与模型真实提交三条轨迹并排对照,每一步的思考原值、终端标准输出与状态变更全部可逐帧回放。在 Deep SWE 类仓库级代码任务上,内部同口径测试显示,GPT-5.6-sol 在我们构建的数据集上准确率比同类供应商低约 15 个百分点,而智能体推理轨迹平均长出约 20 轮,这多出来的 20 轮排错、回滚与重测构成了模型最稀缺的长程训练信号。
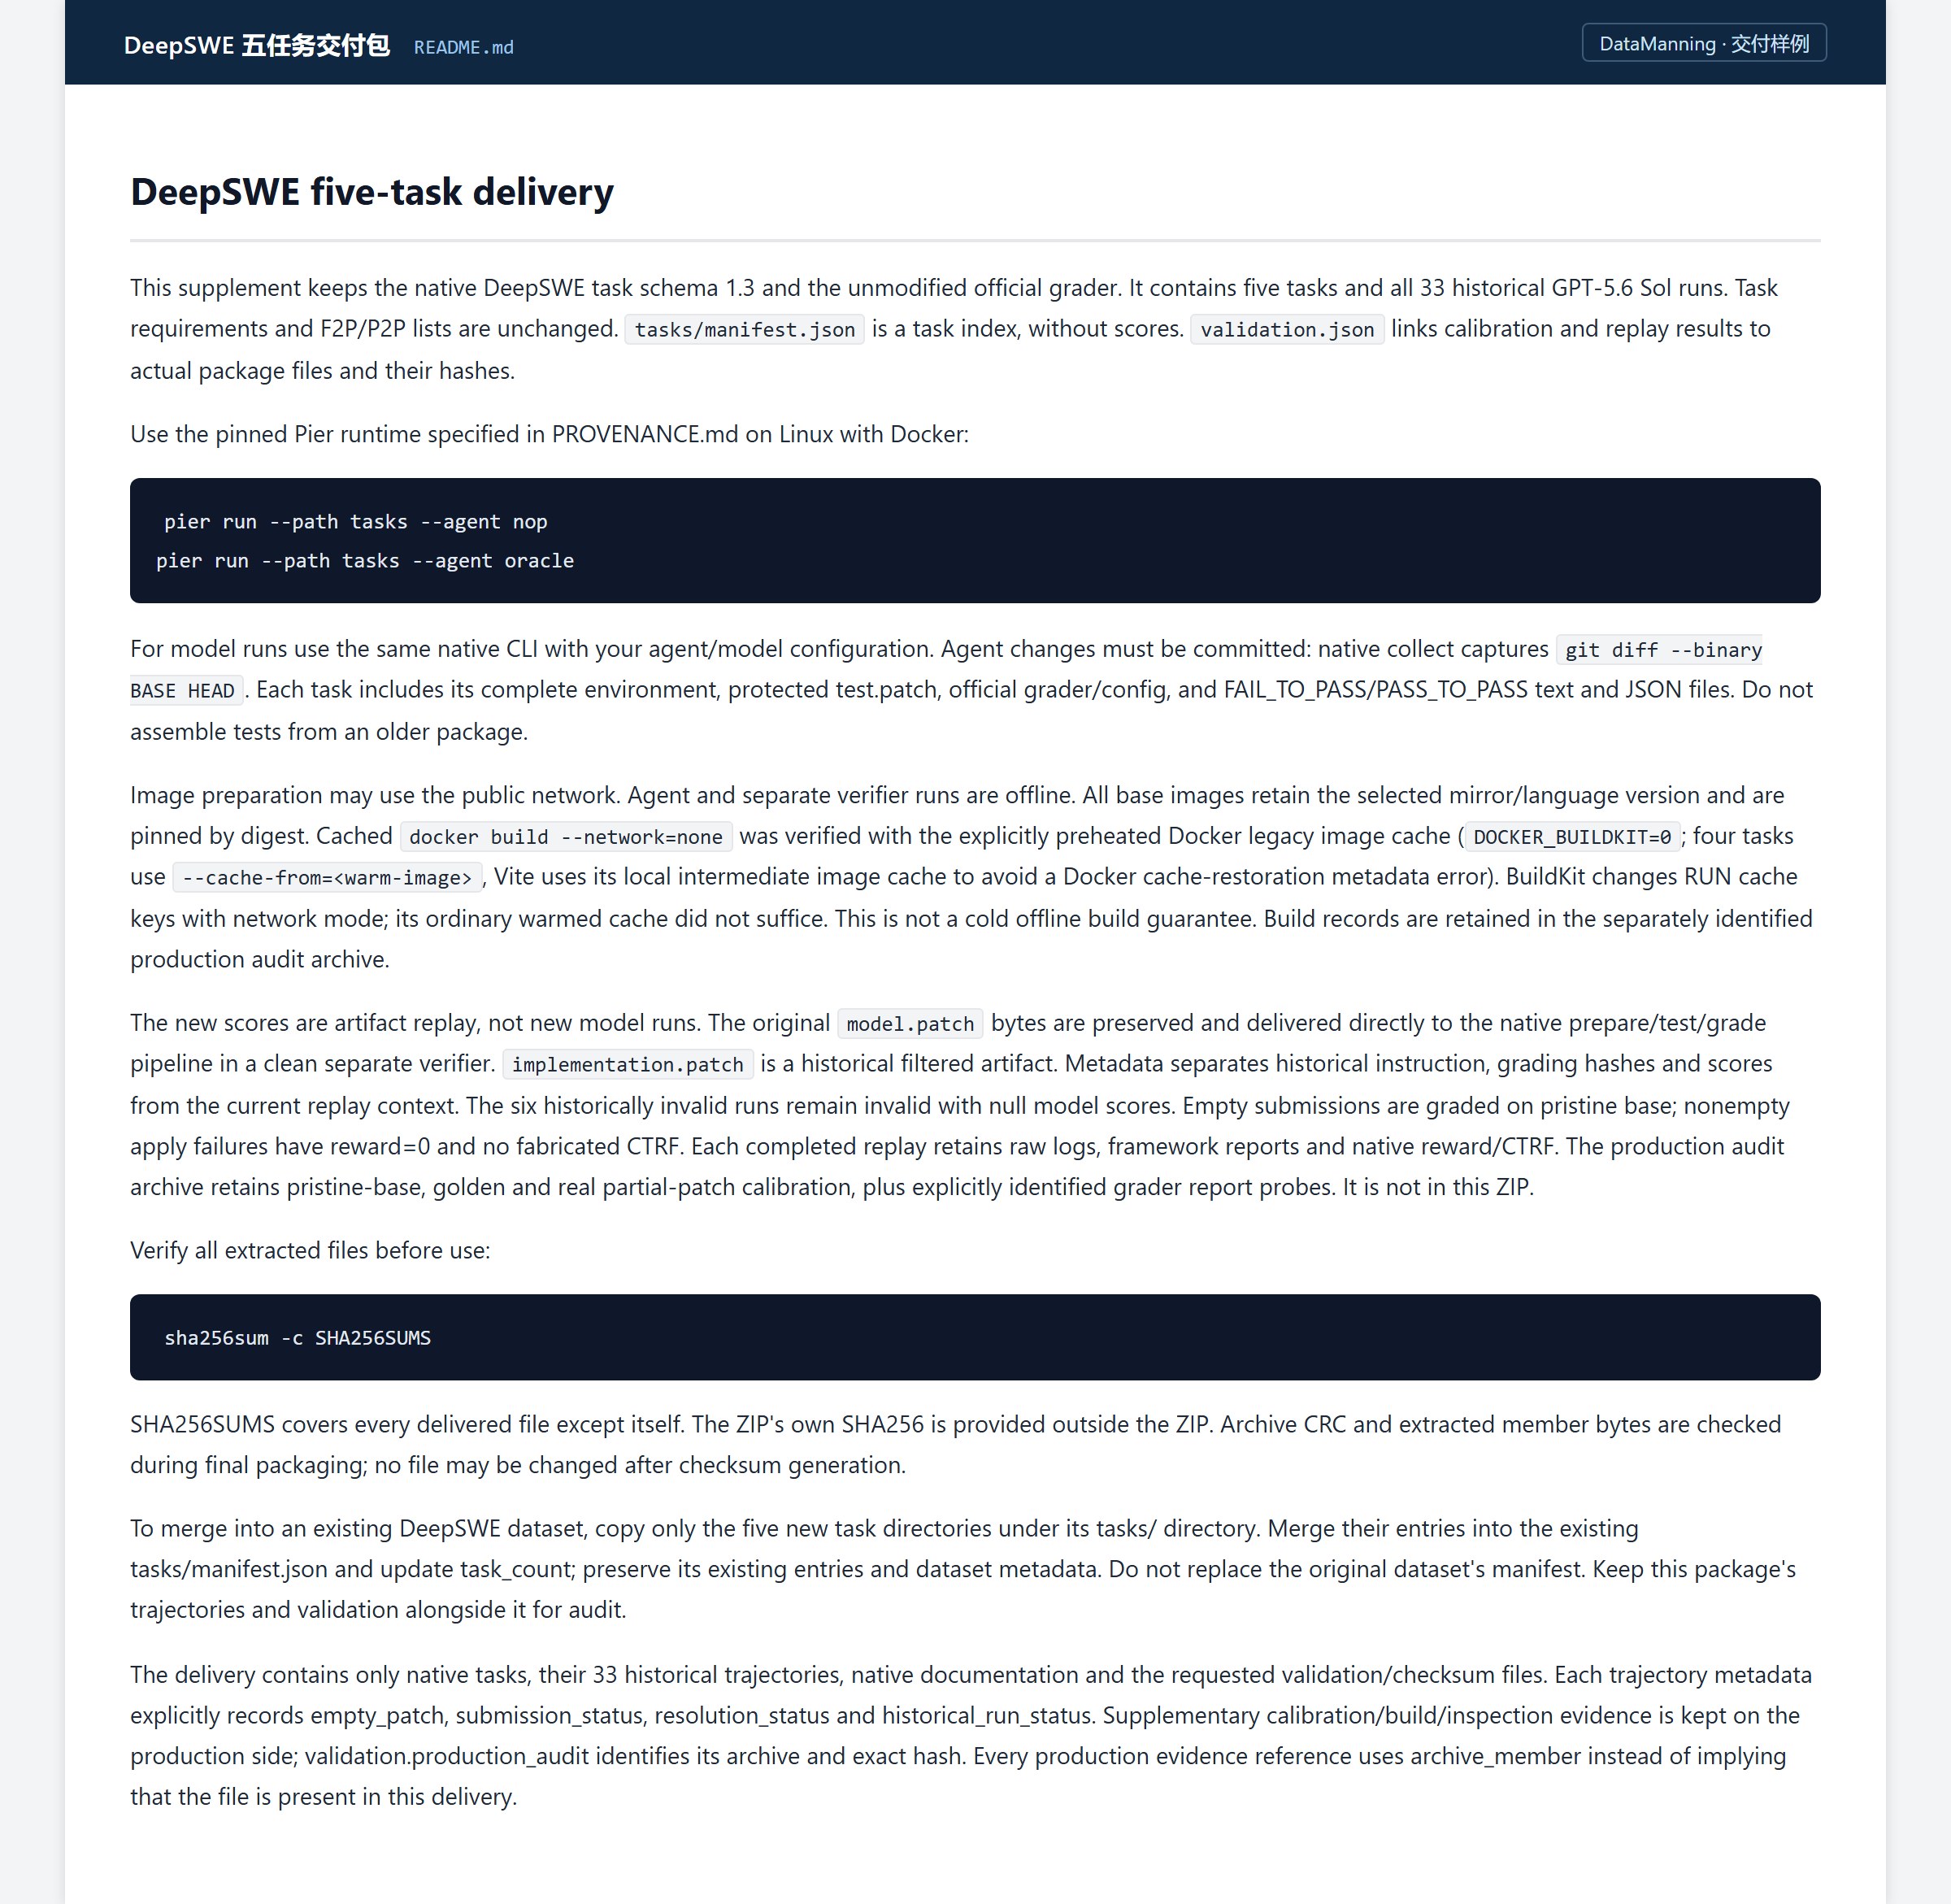
3. 完整保留失败、空补丁与候选淘汰记录。很多数商为了账面好看,只挑成功的轨迹打包,把跑崩的记录全删掉,而我们的交付规范要求全量保留真实运行状态。在 Deep SWE 五任务标准交付包(schema 1.3)中,我们在 validation.json 里如实交付了 33 个轨迹槽位,其中 27 条为有效运行轨迹,6 条历史无效运行保持 null 绝不伪造,3 条空补丁(empty patch)如实标注,apply_failed=0,并通过全量 CRC 与 SHA256SUMS 校验。在 tbs 科学计算包中,我们从 8 道候选题目里严格筛出 3 道入选,被淘汰的 3 道晶格计算候选题目以及 1 道因参考答案漏计而主动撤回的题目,连同全部测试轨迹与失败原因完整保留在 candidates/ 目录中。因为对后训练团队来说,知道模型在哪一步耗尽预算、在哪一类边界条件上交出空补丁,与成功轨迹同样珍贵。
4. 防作弊剥离与五维矛盾性质检。为了杜绝模型靠偷看历史记录或堆砌词句拿高分,我们在环境打包阶段严格执行泄漏面剥离,清理 .git 远端分支、修复 commit 信息与镜像层残留补丁,并加入负控制与空交付基线测试(确保空操作或乱猜得分为 0)。在医疗、法律、金融等复杂行业任务包中,专家命题时必须植入约三分之一的干扰材料(例如在食品安全流调任务里混入不相关的卫生学汇总表,在破产重整任务里同时给出 35.36% 正确清偿率与 41.65%、100% 等四个常见误算口径的错因对照),再经过独立质检团队的“五维矛盾性质检”,逐项核查提示词完整性、文件标识一致性、参考解可推导性、跨文件数据一致性与 Rubric 正负项独立性,发现 P0 级缺陷直接判定“不建议提交,需重大修订”。
5. 面向采购验收的溯源证据。每一份交付包除了题目、环境与轨迹,都强制附带 PROVENANCE.md 与 SHA256SUMS,记录上游基准 commit、评分器哈希、模型档位、采样温度与统计局限声明(例如明确写出“单侧 95% 成功率上界 45.1%,仅在记录在案的模型、工具与预算下失败,不代表普遍无能”)。采购方拿到包的第一分钟,就能用脚本跑通全量哈希核验与参考解重放。
五、给模型研发与数据采购团队的三条务实建议
站在 2026 年底的时间节点看,Trajectory 已经成为智能体迈向工业级可靠的必经之路,它考验的是任务设计、沙箱工程、防作弊验证器与过程溯源的综合内功。
对于正在推进智能体后训练或筹备数据采购的团队,有三条经验值得参考。
1. 先按能力短板定环境与轨迹配比,别盲目按条数囤货。对照 NeurIPS 2026 的三维扩展定律,先把预算投在拓展真实异构环境(World Diversity)与高区分度任务上,再针对模型拿不准的高熵关键步采集带纠错分支的轨迹,避免在同一套简单页面或题库上重复采样上万条同质化日志。
2. 把环境可复现性与防作弊探针写进验收第一关。收到样品包时,先测断网容器能不能一键拉起、参考解(Oracle)能不能满分跑通、空提交(NOP)是不是严格得零分、Git 历史与环境变量有没有泄漏答案线索。验证器本身立不住,上面跑出来的轨迹越长,对模型的误导越深。
3. 选择能交付完整证据与持续迭代能力的技术伙伴。好用的轨迹数据绝非一锤子买卖。随着基座模型每一轮迭代,旧题目会被刷满,旧评分器会被钻空子,需要供应商能跟着模型反馈持续升级任务难度、补充失败恢复分支并演化 Rubric。把数据当成严谨的软件工程来交付,每一分算力与预算才能转化为模型在复杂世界里干活的本事。
关于 DataMining 德塔曼宁 DataMining 德塔曼宁由北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,更交付工业级的 Rubric 与 Harbor Task 验证体系。 ▸ 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE / Terminal-Bench 等,支持 200 题/周、7 个工作日稳定交付。 ▸ 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、Automation Bench、Toolathlon,以及 35+ 原子级 Rubrics 行业工作流包。 ▸ 系统底座与具身真机:Win11 / Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线与 cyber 数据。 本文引用的研究、数据集与基准均为公开第三方成果,我们只对齐其能力要求与难度区间,不复制题目;文中涉及的能力描述为我们的内部同口径结论,不代表第三方官方结论。欢迎搜索关注 DataMining 德塔曼宁 进行样例申请与技术对接。
📚 配图来源与参考资料
本文前 4 张配图取自 arXiv 论文原生 figure,后 2 张为 DataMining 德塔曼宁真实交付包脱敏实拍,未做手绘重绘;图注只描述画面可见内容。
- How Data Scales in Agentic Reinforcement Learning: Laws and Synthesis Strategies,NeurIPS 2026,arXiv:2610.23946,2026-10-08
- Verified Critical Step Optimization for LLM Agents (CSO),arXiv:2602.03412,2026-02
- STRIDE: Strategic Trajectory Reasoning via Discriminative Estimation for Verifiable Reinforcement Learning,arXiv:2606.15866,2026-06
- Eat Your Precision: Mitigating Reward Hacking in Rubric-Based RL (FORK),arXiv:2610.33512,2026-10
- Demystifying evals for AI agents,Anthropic Research,2026-01
- Why we no longer evaluate SWE-bench Verified,OpenAI,2026-02
- We Trained a Model on Office Work. It Also Got Better at Coding,Surge AI,2026