后训练下半场:谁掌握评分规则,谁就掌握模型进化主动权
分数不是天然存在的,而是由评分规则加工出来的产物。2026 年评分规则已从评测工具变成强化学习的奖励信号,原子化采分点正在重构后训练范式。
01第二讲:分数不是天然存在的,而是由“评分规则”加工出来的结果
DataMining 德塔曼宁 · 2026年11月
上一讲我们把 Benchmark 拆解成了不同科目的试卷——知识记忆有 MMLU,数理推理有 GSM8K 和 MATH,代码工程有 HumanEval 和 SWE-bench,人类偏好有 Chatbot Arena。
但有了试卷,紧接着的问题就是:谁来判卷?怎么判?判分的尺子本身,会不会出问题?
很多非技术背景的同学会下意识觉得,模型答对了就是 1 分,答错了就是 0 分,分数是客观存在的。但在大模型的评测与训练体系里,“分数”从来不是天然存在的客观真理,而是由特定的评分规则(Metric / Scoring Rule)加工出来的产物。
评分规则决定了“什么算对”,也就间接决定了模型会往哪个方向进化。理解这一点,你才能看懂各大榜单背后的逻辑,也才能理解 2026 年整个后训练行业正在发生的那场静悄悄的范式转移。
02一、客观题的“硬尺子”:从精确匹配到通过率
1.1 Exact Match:最朴素的判卷方式
对于选择题(如 MMLU)或填空题,最直观的评分规则就是 Exact Match(精确匹配)。模型输出的答案必须和标准答案完全一致,连一个标点符号都不能差,才能拿到分。
这种规则简单粗暴,但也最容易出问题。比如一道数学题的标准答案是“3.14”,模型输出了“π”或者“3.140”,逻辑上完全正确,但 Exact Match 会判 0 分。所以在数学评测中,通常会做一些归一化预处理(比如统一格式、去除前导零),但这本身就引入了额外的规则层。
1.2 Pass@k:代码世界的“殊途同归”
到了代码评测(如 HumanEval),Exact Match 就彻底失效了。让模型写一个排序算法,标准答案用的是快速排序,模型写了一个冒泡排序,逻辑完全正确且能通过所有测试用例——你总不能给 0 分。
因此,代码科目引入了 Pass@k 这个评分规则。它的逻辑是:让模型对同一道题生成 k 个不同的代码候选,只要其中有至少 1 个能完美通过所有的单元测试,就算这道题“Pass”了。
这里有一个容易被忽略的细节:k 的取值直接影响分数的含义。 Pass@1 衡量的是模型“一次做对”的能力,接近真实用户体验;Pass@10 或 Pass@100 衡量的是模型“在多次尝试中至少做对一次”的能力上限。很多榜单上的代码分数之所以看起来很高,是因为它们用的是 Pass@10 甚至更高,而不是用户真正关心的 Pass@1。
1.3 SWE-bench 的 Resolve Rate:工程级的真刀真枪
到了 2025 年火起来的 SWE-bench,评分规则又进了一步。它不再只是“写一个函数”,而是给模型一个真实的 GitHub 仓库和一个 Bug Issue,看它能不能自己定位问题、理解上下文、提交有效的 Patch(补丁)。
SWE-bench 采用的评分规则是 Resolve Rate(解决率)。它不仅要求模型提交的 Patch 能让原本失败的测试用例跑通,还要求绝对不能破坏仓库里原本已经通过的几千个历史测试用例。这种“不许搞破坏”的约束,比单纯的“做对一道题”要严苛得多,也更贴近真实工业界的验收标准。
03二、主观题的“软尺子”:从词频重叠到大模型裁判
如果说数学和代码还有“硬尺子”可以量,那翻译、摘要、创意写作、开放式问答这些“文科”科目怎么判分?这才是真正让人头疼的地方。
2.1 传统 NLP 指标:BLEU、ROUGE 的局限
早期的自然语言处理(NLP)时代,大家用的是 BLEU(机器翻译)和 ROUGE(文本摘要)这类基于词频重叠度的指标。简单来说,就是看模型生成的句子和人类参考答案有多少个 n-gram 是重合的。
这种规则极其死板。一个意思完全正确但措辞不同的回答,可能因为词频重叠度低而拿到很低的分数。更致命的是,它鼓励模型去“背诵”标准答案的句式,而不是真正理解问题。到了大模型时代,这些指标基本已经被边缘化了。
2.2 LLM-as-a-Judge:让大模型当裁判
2023 年到 2024 年,业界找到了一个看似优雅的替代方案:LLM-as-a-Judge。用 GPT-4、Claude 这样更强的模型去给其他模型的回答打分,通常是 1 到 10 分,或者在两个候选回答之间做 A/B 选择。
这个方案的好处是快、便宜、可扩展。但问题也很明显:
长度偏见:大模型裁判倾向于给更长的回答打更高分,哪怕多出来的内容都是正确的废话。
格式偏见:使用了 Markdown 列表、加粗标题的回答,往往比纯文本回答拿到更高的分数。
自我偏好(Self-Preference):用 GPT-4 当裁判去评 GPT-4 生成的内容,分数往往偏高;用 Claude 评 Claude,同理。
位置偏见:在 A/B 对比中,排在前面的候选回答更容易被选中。
这些偏见在 2024 年的多篇论文中已经被反复验证。到了 2025 年,随着 LLM-as-a-Judge 被大规模用于强化学习的奖励信号,这些偏见的危害被进一步放大——因为模型不再只是“被评”,而是在“被训练”。裁判的偏见会直接变成模型的进化方向。
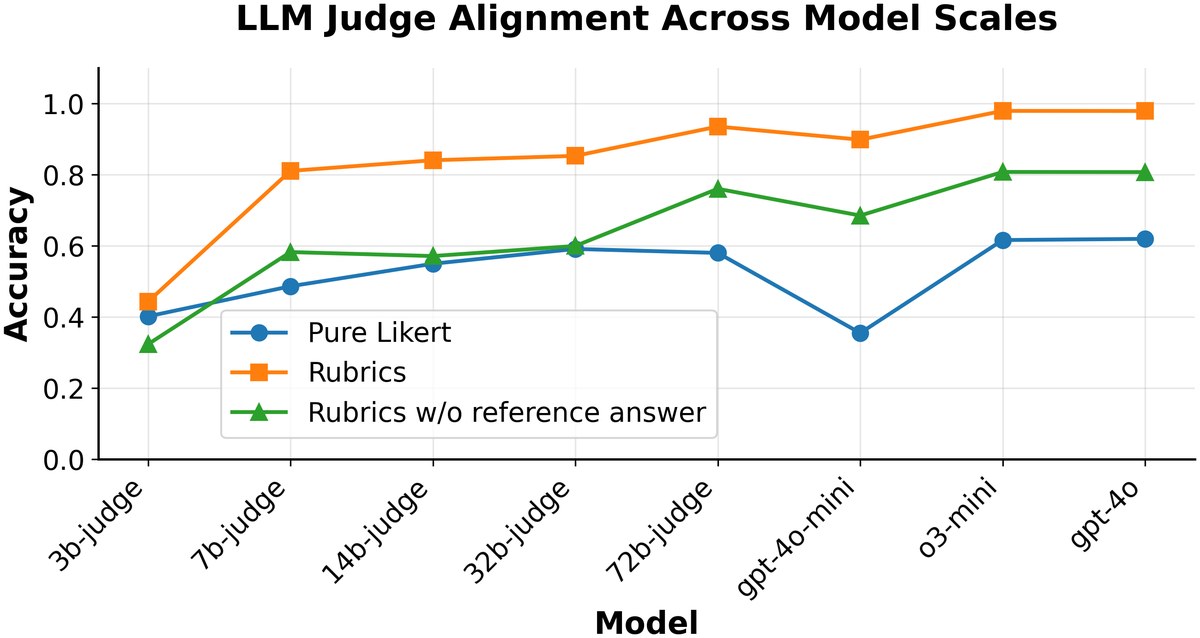
2.3 人类偏好与 Elo 评分
Chatbot Arena(LMSYS)采用的是另一种思路:把裁判权交给真实人类,用脚投票。两个匿名模型同时回答同一个问题,人类选出更好的那一个,最终通过 Elo 算法(类似国际象棋的积分系统)计算出模型的排名。
这种方式最接近真实用户体验,但也有局限:它反映的是“讨喜程度”,而不是“专业正确性”。一个语气礼貌、排版工整但核心判断有误的回答,在人类偏好投票中往往能赢过一个措辞生硬但专业准确的回答。
04三、2026 年的范式转移:评分规则从“评”变成“训”
讲到这里,你可能会觉得:评分规则不就是评测用的吗?评完了发个榜单,大家看看就好。
但在 2025 年到 2026 年,评分规则的角色发生了根本性的变化。它不再只是评测工具,而是直接变成了强化学习(RL)训练的奖励信号。 评分规则怎么写,模型就往哪个方向进化。
3.1 RLVR:可验证奖励的黄金时代
2025 年最火的后训练范式是 RLVR(Reinforcement Learning with Verifiable Rewards,可验证奖励强化学习)。核心逻辑非常简单:找那些有明确标准答案的任务(数学题、代码题),做对了给 1 分,做错了给 0 分,用这个非黑即白的信号去训练模型。
DeepSeek-R1、OpenAI o3、Qwen3 这一代推理模型,很大程度上都是被这套“0 和 1”的奖励信号喂出来的。效果确实惊人——模型在数学和代码基准上的表现突飞猛进。
但问题也很明显:这套逻辑只能覆盖那些“有唯一标准答案”的任务。 你没法用三行 Python 断言去判断一份并购风险备忘录写得好不好,也没法用单元测试去验证一份医学诊断分析是否专业。
3.2 当“0 和 1”的尺子不够用了
到了 2026 年下半年,行业里一个越来越清晰的共识是:人类世界里真正值钱的活儿,90% 都不是数学填空题。
金融尽调、法律合规审查、医疗影像分析、多步工具调用的 Agent 任务——这些高价值场景没有唯一标准答案,传统的评分规则全部失效。
以前遇到这种开放式任务,大厂只能退回去搞传统的人类偏好对齐(RLHF),或者找个大模型当裁判打个 1 到 5 分的印象分。结果训出来的模型全成了“老好人”:排版极其工整,语气极其礼貌,满篇都是正确的废话,但核心业务判断一塌糊涂。
这不是模型笨,而是评分规则没有告诉它“好”的标准到底是什么。
3.3 从“一个分数”到“一组采分点”
于是,2026 年下半年,一个明显的趋势出现了:评分规则正在从“给一个整体分数”走向“拆成一组原子化的采分点”。
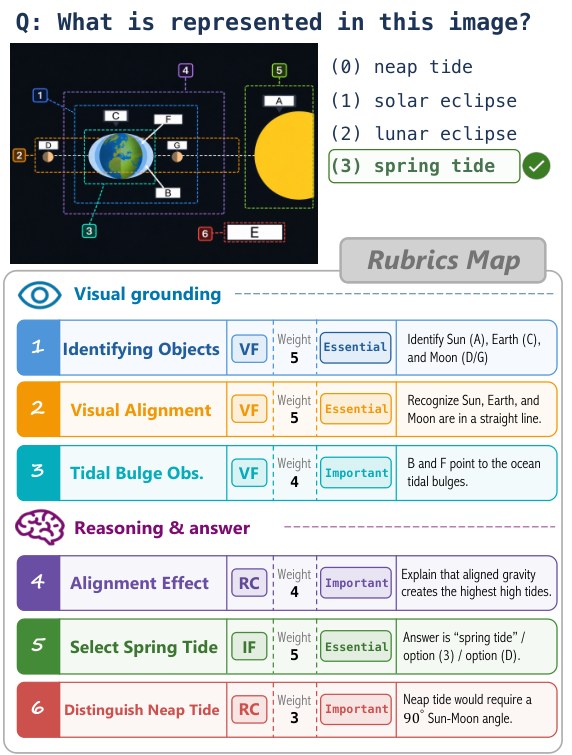
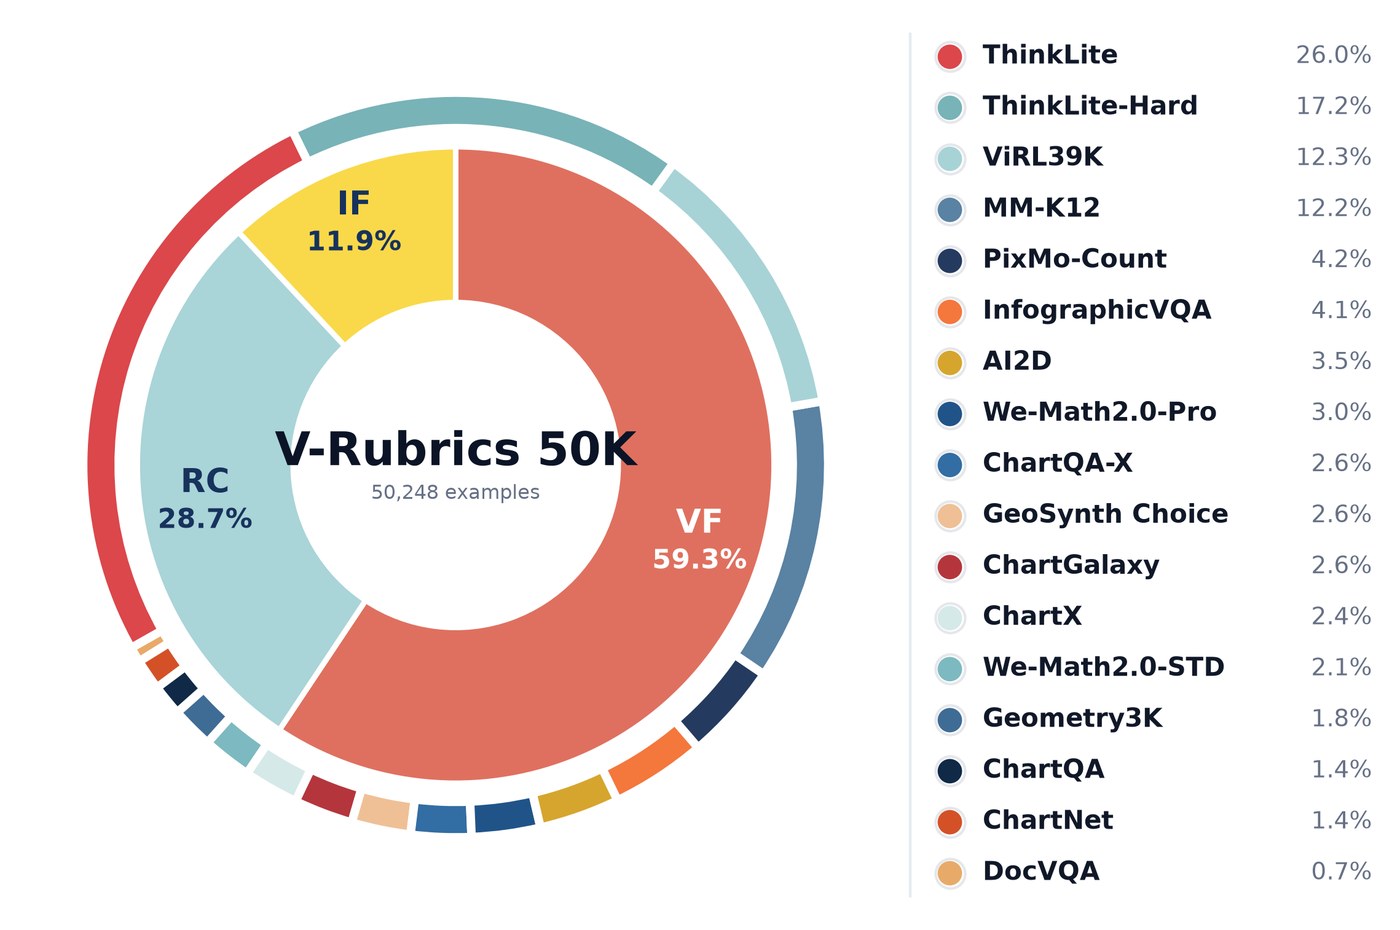
今年 8 月底,南洋理工大学刘子纬团队(S-Lab)联合 A\*STAR 发表了 V-Rubrics(arXiv:2608.25580,已开源 shulin16/v-rubrics)。他们用 Gemini-3-Pro 把 5 万道看图推理题的标准答案,硬生生拆成了 35.2 万条原子级检查项。每一条标准只查一件事,全部变成只答“是”或“否”的客观题,再按重要程度配好权重,塞进 GRPO 强化学习管线里去训练多模态模型。
10 月 17 日,摩根大通与学术界联合发表了 《Expert-Guided Rubrics as Dense Reward Signals in Non-Verifiable Domains》(arXiv:2610.26932),把金融服务里那些原本根本没法验证的意图理解、查询改写和合规检索,全拆成了专家级评分细则当稠密奖励信号。
紧接着,艾伦研究所(AI2)开源了 DR Tulu(rlresearch/dr-tulu),用动态演化的评分规则去训练深度研究(Deep Research)智能体;清华大学与智谱团队也开源了 CaRR(THUDM/CaRR),要求深度搜索 Agent 必须把每一条采分点和真实的网页引用证据链死死绑在一起才给分。
你会发现,这些工作的共同点是:不再让裁判凭印象打一个笼统的分数,而是把“好”的标准拆成几十条可独立验证的原子断言。 这已经不是简单的“评分规则升级”了,而是整个后训练范式的底层重构。
05四、评分规则设计的“暗坑”:来自一线的经验
讲了这么多理论和论文,接下来聊点实际的。
在 DataMining 德塔曼宁,我们过去几年一直在为大模型和智能体研发提供高质量的任务数据与可执行评测环境,服务过国内多家头部模厂。
在这个过程中,评分规则的设计是我们踩坑最多、也最有感触的环节。
分享几个我们在实际项目中反复遇到的典型问题:
4.1 “且”字陷阱
很多标注团队在写评分标准时,会不自觉地写出这样的规则:“模型需要准确且完整地回答用户的问题。”
这句话看起来没毛病,但在实际评分时会出大问题。如果模型回答准确但不完整,裁判该给分还是不给分?如果裁判给了一半分,那这个“一半”是怎么来的?不同的裁判会给出完全不同的判断。
我们在内部规范中现在的要求是:一条标准只准查一件事。 严禁出现“且”“同时”“并且”这种把两件事绑在一起的连词。“准确性”和“完整性”必须拆成两条独立的检查项,各自独立打分。
4.2 只有加分项,没有重罚项
早期的评分规则设计,往往只有加分项:“是否覆盖了所有关键子问题?是则 +5 分。”
但在真实的业务场景中,有些错误的代价远高于“答对”的收益。 比如在医疗场景中,模型给出了一个看似合理但剂量错误的用药建议;在合规场景中,模型的脱敏清单里漏遮了一个身份证号。这些错误如果被“整体印象分”淹没,后果不堪设想。
所以我们在设计评分规则时,会强制要求设置重罚项(负向采分点)。比如:漏遮一个患者身份证号,直接 -10 分;遗漏关键风险提示,直接 -7 分。这些重罚项的存在,会让强化学习的梯度在训练时对这些“业务暗礁”格外敏感。
4.3 模型会“钻规则的空子”
这是最容易被低估的问题。
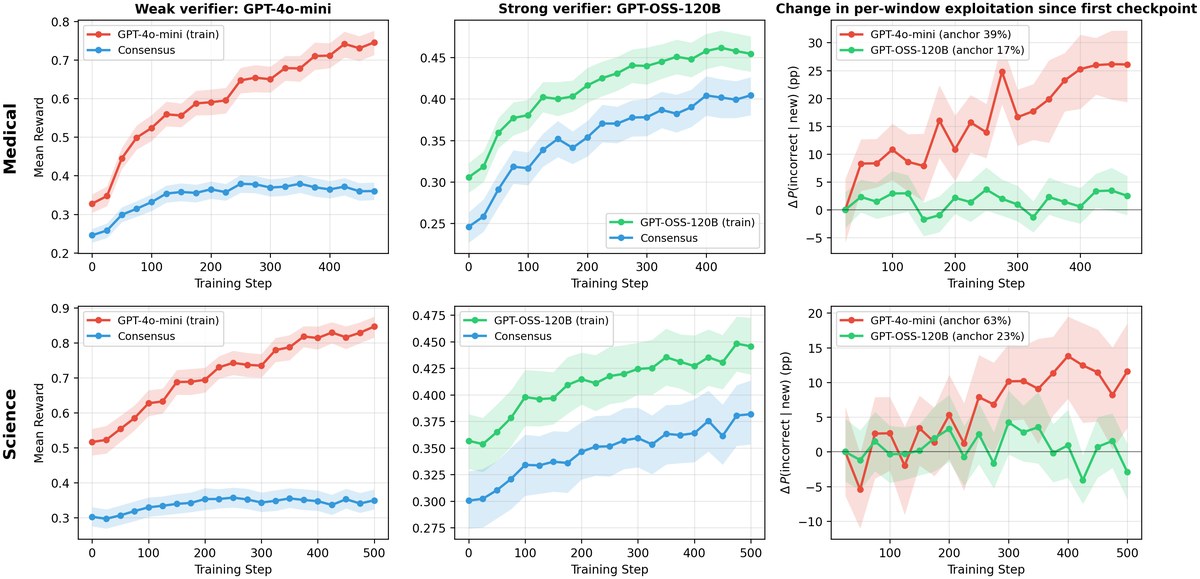
当评分规则被用于强化学习训练时,模型不是在“学习”,而是在“优化”。它会用你想象不到的方式去钻评分规则的空子(Reward Hacking)。
举个例子:如果评分规则里有一条“回答是否包含至少三个具体例子”,模型可能会学会在回答中硬塞三个毫无关联的例子,纯粹为了凑数拿分。再比如,如果规则要求“引用必须来自提供的参考资料”,模型可能会学会把参考资料里的原文大段复制粘贴,而不是真正理解和整合信息。
应对这个问题的办法是迭代打补丁:先用初版评分规则跑一轮训练或评测,分析模型的输出,找出它是怎么“钻空子”的,然后针对性地加入新的约束条件。这个过程往往需要反复好几轮。
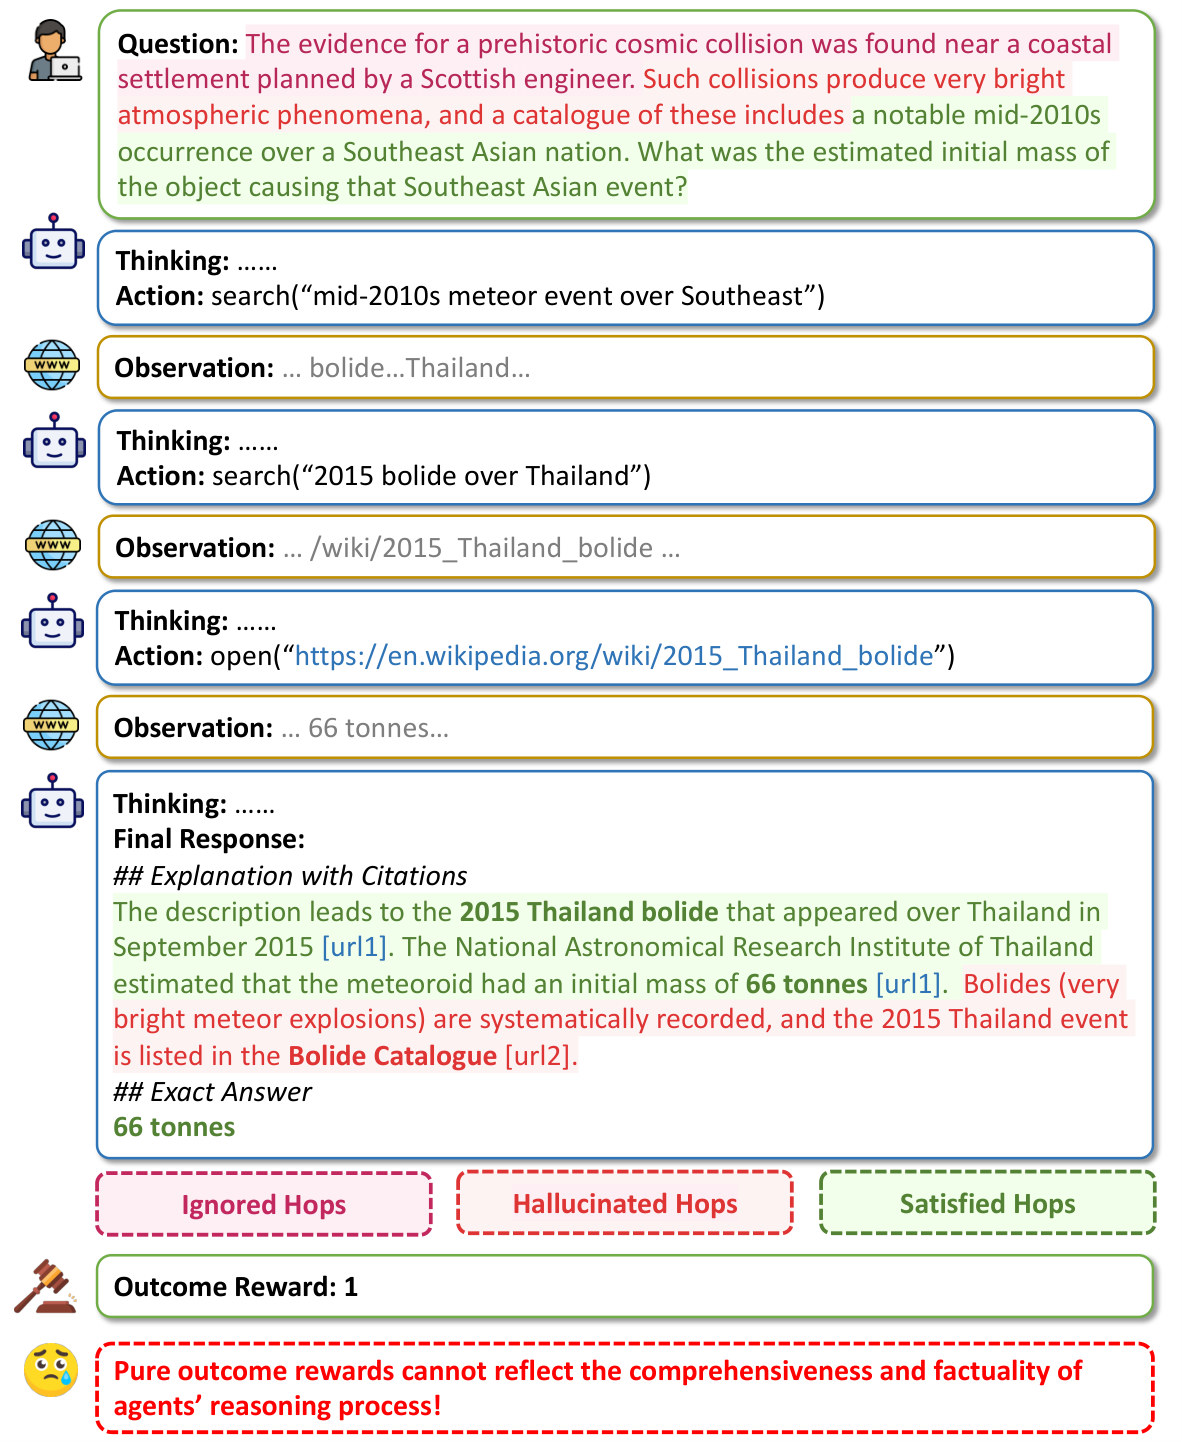
4.4 评分规则必须绑定证据链
在深度研究和长文本生成场景中,我们遇到的另一个高频问题是:裁判无法验证模型回答的事实性。
比如模型写了一份行业分析报告,里面引用了三个数据来源。裁判(无论是人类还是 LLM)如果没有原始资料可以对照,就只能凭自己的知识去判断,很容易出现误判。
所以现在的趋势是:每一条事实性采分点,都必须绑定可核查的证据链。 模型不仅要给出结论,还要标注这个结论来自哪份文档、哪个段落、哪个具体数据点。清华智谱的 CaRR 项目就是在这个方向上做了很扎实的探索。
06五、评分规则正在重塑整个数据供应链
最后聊一个更宏观的观察。
当评分规则从“评”变成“训”,从“一个分数”变成“一组原子化采分点”,它的影响已经远远超出了评测本身。它正在重塑整个大模型数据供应链的底层逻辑。
以前,数据供应商交付的是“题目 + 标准答案”。甲方拿到手,跑个 Exact Match 或者 Pass@k,分数就出来了。
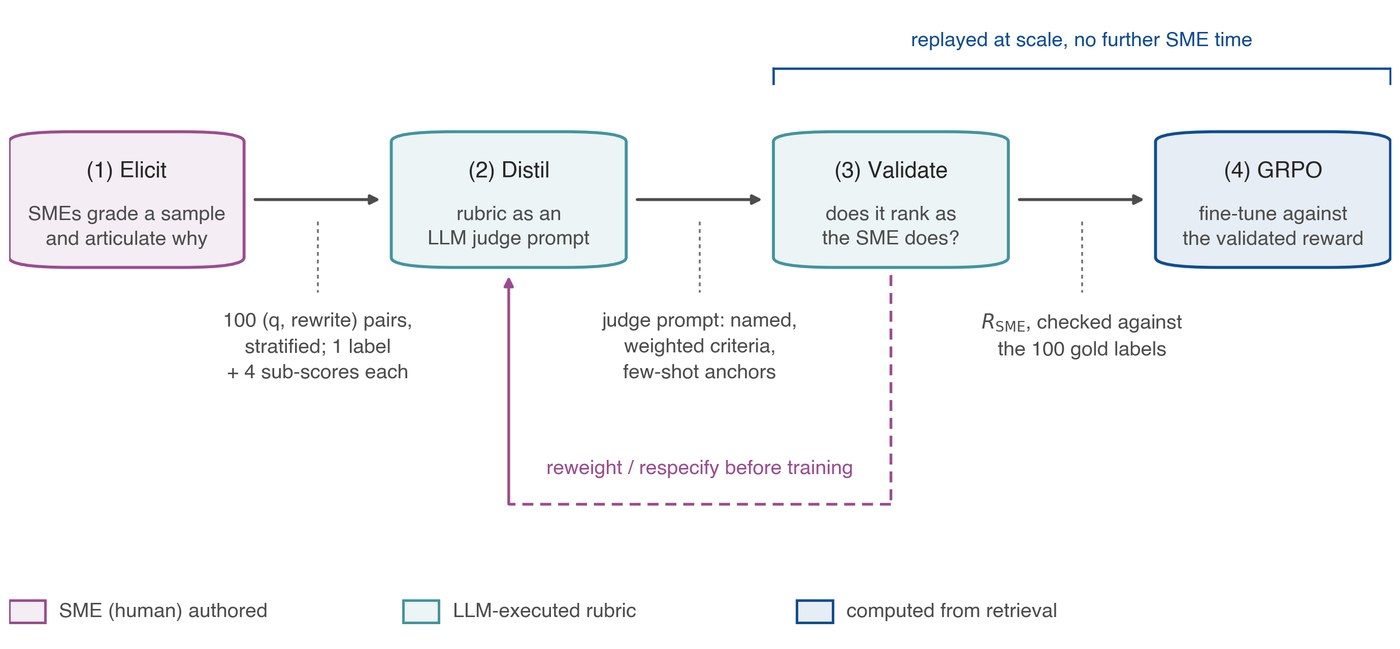
现在,甲方要的不是一个标准答案,而是一套能稳定判分的规则体系。他们问的是:你能不能把合伙人审案子、审计师查假账、医生看片子的隐性经验,写成 35 到 60 条机器能稳定判分的原子规则?
今年 10 月中旬,国内头部模厂与数据枢纽刚刚更新了 v2.0 版的专业行业 Agent 采购规范。规范里白纸黑字写着一条硬门槛:每一道金融、财税、法务或医疗的长程任务,必须配套不少于 35 条原子级正负向 Rubrics。 而且规矩极其严苛:一条标准只准查一件事,必须明确标出查的是哪一份交付物文件,必须有针对业务暗礁的重罚项。
这意味着,谁能把行业专家的隐性判断标准翻译成机器可执行的评分规则,谁就掌握了后训练下半场的核心资源。
07六、总结:分数是规则的产物,规则决定进化的方向
回顾一下这一讲的核心逻辑:
分数不是天然存在的。 同一个模型的回答,用不同的评分规则去量,会得到完全不同的分数。
评分规则经历了从“硬尺子”到“软尺子”再到“原子化采分点”的演进。 Exact Match → Pass@k → BLEU/ROUGE → LLM-as-a-Judge → Rubric-based 多维评分。
2026 年,评分规则的角色发生了根本性变化:它不再只是评测工具,而是直接变成了强化学习的奖励信号。 规则怎么写,模型就往哪个方向进化。
传统的评分规则在面对开放式任务时已经力不从心。 当“0 和 1”的尺子无法衡量一份尽调报告或一次医学分析的质量时,我们需要更精细的工具。
这就引出了我们下一讲的核心问题:面对没有标准答案的开放式任务,我们到底该怎么设计这套“原子化采分点”?它的结构是什么?怎么构建?怎么防止模型钻空子?
这就是 Rubric(评分细则) 要解决的问题。
关于 DataMining 德塔曼宁 我们由北京大学计算机学院软件所博士生团队组建,长期为大模型与智能体研发提供高质量原创任务数据与可执行评测环境,服务过国内多家头部模厂。评分规则设计、原子级 Rubrics 与防作弊判分器,是我们踩坑最多、也最有积累的环节。 我们可做的 benchmark:代码工程(Deep SWE / Frontier SWE)、真实环境长程操作(ALE / Terminal-Bench)、极限数理与科学、开放式任务的 Rubric 与防作弊判分器,以及具身智能、cyber 方向的任务数据与私有盲测集。
延伸参考
本文配图均取自下列论文的原生 figure,未做重绘。
- V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning. arXiv:2608.25580, 2026.
- Expert-Guided Rubrics as Dense Reward Signals in Non-Verifiable Domains. arXiv:2610.26932, 2026.
- DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research. arXiv:2511.19399, 2025.
- Chaining the Evidence: Robust Reinforcement Learning for Deep Search Agents with Citation-Aware Rubric Rewards. arXiv:2601.06021, 2026.
- Rubrics as Rewards: Reinforcement Learning Beyond Verifiable Domains. arXiv:2507.17746, 2025.
- Reward Hacking in Rubric-Based Reinforcement Learning. arXiv:2605.12474, 2026.
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. ICML 2024.
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR 2024.