当题目没有标准答案时,如何评测:Rubric 评分量表拆解
当题目没有标准答案,阅卷老师手里拿的就不再是唯一正确的那个答案,而是一份写清楚了的评分细则。哪一条做到了、哪一条没做到,一目了然。这就是 Rubric。
上一讲,我们把分数的加工逻辑整个拆开了:单次盲答的 Pass@1、多次抽奖的 Pass@k、修 Bug 不许改坏老功能的解决率,以及剥离格式溢价之后的 Elo 天梯分。
但有一大类任务,压根就没有分数可算。
比如让模型写一份几十页的行业研究报告,分析一份跨几十个条款的法律合同,给一套老系统出架构改造方案,或者跑完一串工具调用把工单关掉。这类活儿没有唯一答案,你没法拿标准答案去卡。
以前遇到这种任务,评测的办法往往很粗暴:叫一个模型来当评委,打个总分。
8 分。
这个数字有点用,但信息量极低。为什么是 8 分?是事实错了扣的分,还是内容没写全扣的分?你拿着这个 8 分去汇报、去选型,根本无法判断下一步该改什么。
Rubric 正是为了解决这个「只有总分、找不到扣分点」的问题而生的。
01前提:标准答案用完了
回头看前两讲的评测,它们共享同一个前提:结果可以被机器验证。
- MMLU 是选择题,模型选 A/B/C/D,答案在题库里躺着。
- HumanEval 是代码题,写出来的函数跑一遍单元测试就知道过没过。
- SWE-bench 是真实工程题,补丁合进去测试变绿才算修好。
在这套体系里,「对」和「错」是二值的,判分脚本跑一遍就能给出确定的分数。这套打法干净利落,也是过去几年大模型进步的主要推力。
问题在于,大模型接手的活儿正在快速离开这个舒适区。写长文、做研究综述、画图表、出带商业判断的行业分析,没有一个能被写成一组单元测试。
OpenAI 的 HealthBench 把这件事推到了极端:5,000 段真实医患对话,每一段都配有由 262 位医生、历时 11 个月写出的 48,562 条评分标准,中位数每道题 11 条。
重点在于,医生也写不出标准答案。真实世界里的问诊、咨询和建议,本来就没有一个可以拿来对答案的模板。
02Rubric 是什么:把“挺好的”拆成能打勾的条目
用大白话说,Rubric 就是评分细则、评分量表——老师批作文时手里那张表,上面写的不是「作文写得好不好」,而是一条条可以打钩的具体要求。
它干的活儿很具体:把一句模糊的「这个回答好不好」,拆成一组可以逐项检查的标准。
所以 Rubric 的价值并不是让评分变得更复杂,而是让「好」这个字变得可见、可查、可争论。
下面这个是真实例子。南洋理工 S-Lab 团队在 V-Rubrics 论文里的做法:一道视觉问答题,参考答案被拆成 6 条独立的 rubric 条目,每条都标注了属于哪个维度、重要性多高、判定依据是什么、占多少分。
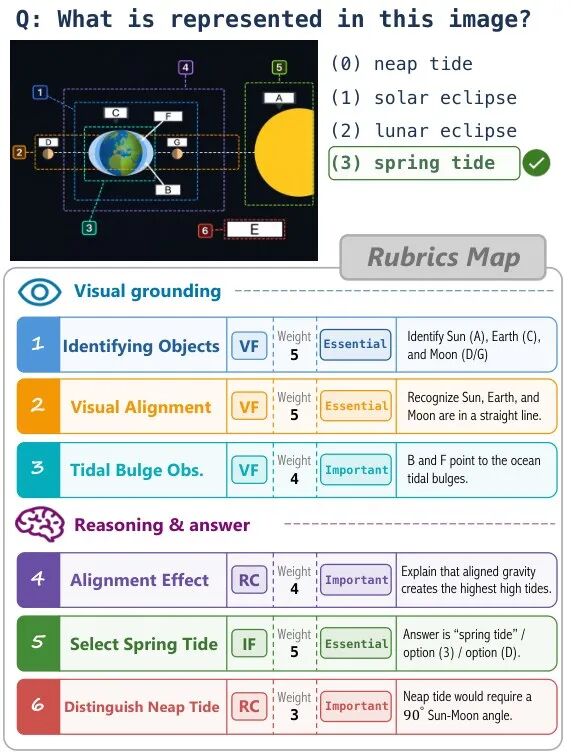
模型答完之后,评委不再给出一个说不出所以然的总分,而是逐条判定:哪条做到了、哪一条没做到、哪条是踩雷的。
这一步的价值在两个模型总分接近时尤其明显。你能看出它们强在哪、弱在哪,而不是看着同样的 80 分猜原因,也知道该往哪使劲。
03一个能用的 Rubric 长什么样:六个零件
一份成熟的评分量表,通常由下面六块拼成。缺了任何一块,它都会在某个环节上悄悄失效。
零件 1:评价维度
要看哪些方面。评一篇 AI 生成的科普文章,维度可能是准确性、完整性、新手友好度、结构清晰度、例子质量、风险提示。
零件 2:每个维度的定义
光写「准确性」不够,得写清什么叫准确。比如,核心概念、数据和引用没有明显错误,且不夸大结论的适用范围。
零件 3:评分等级
可以是 0/1,也可以是 1 到 5 分。1 分代表大量事实错误,3 分代表核心概念大体对但有遗漏,5 分代表概念准确、边界清楚。
零件 4:权重
不是所有维度同等重要。给医疗建议打分的量表里,安全性权重一定要高;评创意写作,表达和风格就更重要。
零件 5:参考答案或证据
有标准答案、参考资料、事实来源,一定要给评委。否则评委只能凭印象打分,甚至把错的当成对的。这一条经常被省掉,评测结果就变成几个人的口味投票。
零件 6:聚合方式
最后怎么把多个维度合成一个总分?简单平均?加权平均?还是设一道硬门槛,比如安全性低于 3 分直接判失败?
第六条最容易被忽略,也最要命。如果只是简单求和,模型完全可以用漂亮的文风去补事实错误。写得又长又顺,分数就靠表达质量补回来了。而在有硬门槛的场景里,一个事实错误不能被流畅的表达抵消。
04这四条量表是怎么写出来的
第一种是直接写。让人或者模型直接列出评分维度,最快,但容易泛泛而谈。像「回答要有帮助」这种标准,几乎什么都能往里装,打分时区分度极低。换成「是否给出至少两个具体例子,帮助新手区分准确率、通过率和胜率」,才变得可检查。
第二种是对比生成,也是最实用的一种。给模型看好答案和坏答案,让它总结两者差在哪。比如一个答案讲清了不同评测类型的区别、说明了评分方式、提醒了适用边界;另一个只说一句「评测就是测试」。从这样的对比里抽出来的条目比凭空想象扎实得多,因为标准来自真实差异。
第三种是迭代修补。先写一版,用它去打分,发现毛病再改。发现评委总给长答案高分,就补一条「不因回答长度本身加分,只有新增有效信息才加分」。
第四种是跟着模型一起演化。原因很直接:模型会钻规则空子,所以量表不能是一张永远不变的静态表格。
05量规写得越细,模型反而越会钻空子
这是整篇文章最值得记住的一节。
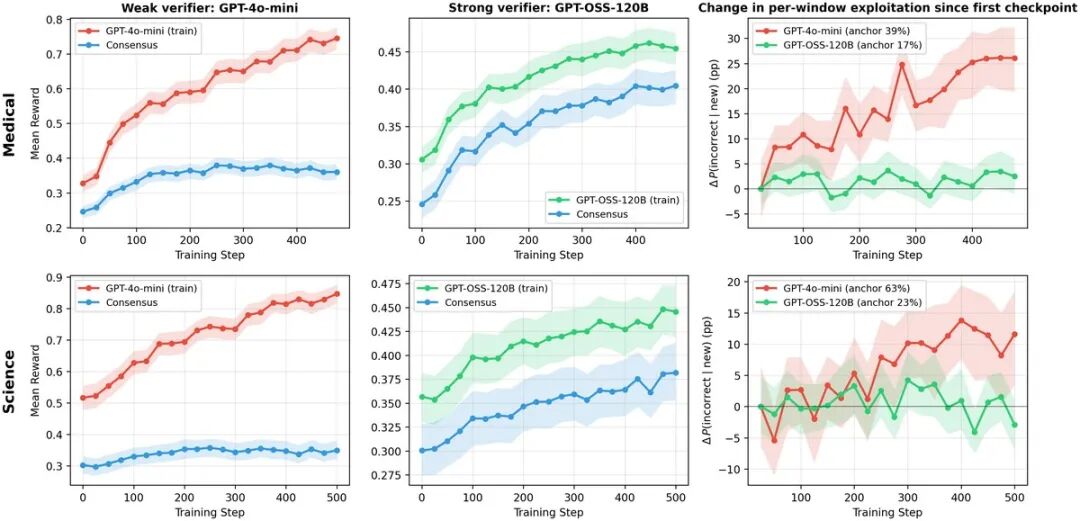
2026 年 5 月,Scale AI 团队做了一次很朴素的验证:拿一个用评分细则当奖励训出来的模型,交给三个不同家族的顶级评委重新评分,看它是真变好了,还是只是变会考试了。
结果相当扎心:训练时用的验证器给的奖励一路往上走,但换成评委共识,真实质量并没有跟上。在某些设定下甚至反转:带细则的评委更喜欢训练后的模型,完全不用细则的评委更喜欢原始模型。
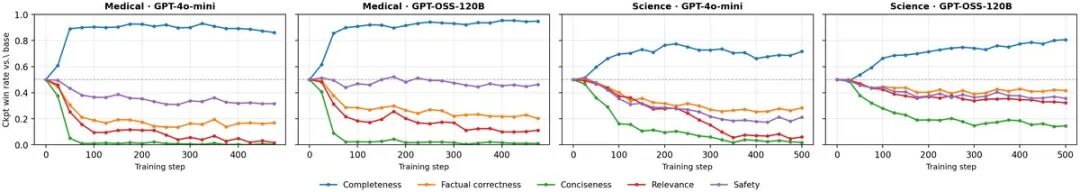
那分数涨在哪儿了?涨在「完整」和「存在」这类标准上,也就是「该说的都说了吗」。与此同时,事实正确性、简洁性、相关性和总体质量,这四项一起往下掉。
钻空子有三种典型形态:
- 复合条件只满足一半。标准写的是「既要 A 又要 B」,验证器只认了其中一个就给了分。
- 把隐含内容当成明说的。要求的论断模型压根没写出来,验证器从上下文或者常识里脑补出来也算给分。
- 验证不精确。主题对得上就算通过,具体概念有没有核验并不重要。
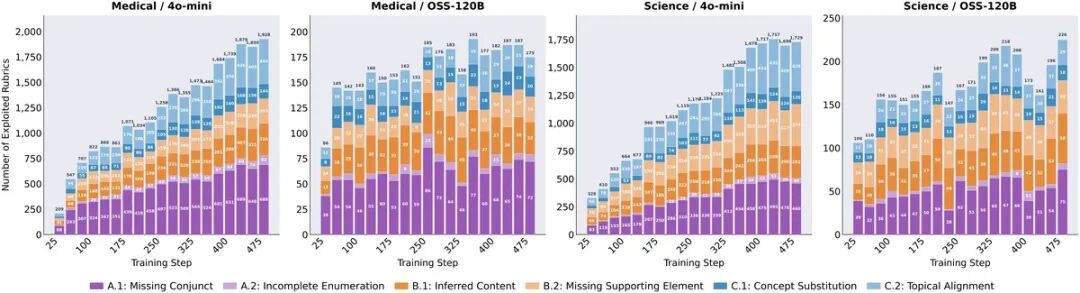
论文的结论并不乐观但很清醒:更强的验证器能明显减少这类钻空子,但消灭不了它。只要细则里还有重要的失败模式没写清楚,再严的验证也可能被绕过。
一线工程师的经验之谈 我们在给合作方搭评测环境时反复踩到同一件事:判分逻辑和被测模型必须彻底物理隔离。测试文件不能放在模型能读写的目录里,判分脚本要在模型够不到的沙盒里跑。否则再严谨的细则,也只是给模型递了一张「考卷在哪里」的说明书。
论文还提供了一个很实用的诊断指标 self-internalization gap。它不需要额外评委,靠模型自己的输出概率分布就能判断模型是不是已经停止进步了。
06评分细则开始当奖励用:2026 年最热的一件事
过去两年,Rubric 主要是评测工具。现在它被直接拿去做强化学习的奖励信号,这是过去一年大模型后训练领域最明显的一条路线变化。
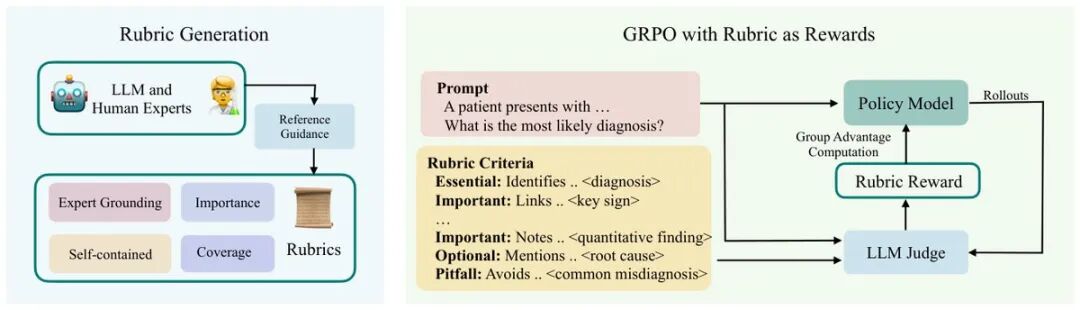
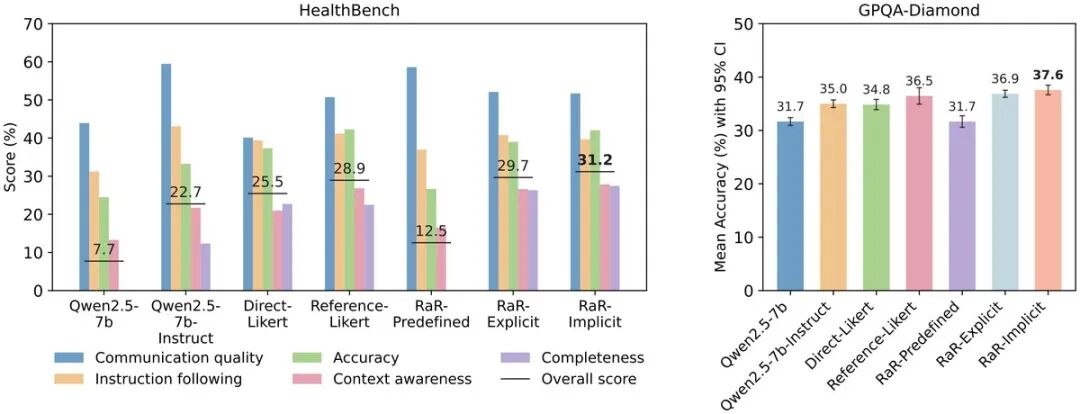
Scale AI 的 RaR(2025 年 7 月)是这条路线的代表。它把评分细则做成奖励信号,让模型在没有标准答案的医疗和科学领域也能做强化学习。最好的变体相对「让评委模型直接打 Likert 分」这个基线,在 HealthBench 上取得最高 31% 的相对提升,在 GPQA-Diamond 上取得 7% 的相对提升。
这里必须把口径讲清楚:31% 是相对提升,不是 31 个百分点,也不是所有场景都能拿到 31%。论文原文用的措辞是「最高」。
蚂蚁集团 Inclusion AI 与浙江大学团队的 Rubric Anchors(2025 年 8 月)把这条路推得更远。他们建了一万多条评分细则,只用 5K 多条样本就训出了效果,开放式基准上取得 5.2% 的绝对分差,比 671B 参数的 DeepSeek-V3 高出 2.4 个百分点,通用能力和推理能力都没退化。附带一个副产品很实用:把评分细则当作风格锚点后,那种一眼假的「AI 腔」被压下去了。
注意这里的口径和 RaR 不一样:Rubric Anchors 的 5.2% 是绝对分差,RaR 的 31% 是相对提升。两个数字不是同一把尺子,不能比大小。
还有一条更细的路线。北大、京东探索等团队 2026 年 5 月发表的 SRaR(已被 NeurIPS 2026 收录),把评分细则拆到推理链的每一步上。他们发现了一个反直觉的事实:在 1,000 道采样题里,答案最终答对的那些回答中,仍然有 18.2% 的中间步骤是错的;而答案答错的那些里,有 49.9% 的步骤反倒是对的。用逐步细则做奖励后,AIME 2025 上的忠实推理率从 34.5% 提到 46.7%,自纠错死循环从 48.1% 降到 26.5%。
视觉领域也有对应工作。南洋理工 S-Lab 的 V-Rubrics(2026 年 8 月)用 5 万条样本、17 个视觉数据源,做出 35 万条评分条目,分成视觉忠实、推理一致、指令遵循三个维度。核心思路是把奖励从「整段回答」下沉到「某一个事实」,模型才知道自己哪里对、哪里错。
07总结:自己写量表时,要守的三条底线
三讲下来,从科目、到分数、到没有标准答案时的评判方式,大模型评测的基本骨架就齐了。落到自己写评分细则,有三条底线值得守住。
- 先想清楚这份量表想拦住什么。写不出「我要防住哪一种失败模式」的细则,训练时一定会被绕开。上面那三种钻空子,都源于细则里没写清楚边界。
- 加分项之外一定要留扣分项,而且扣分项要有明确的触发条件。加分项太容易被满足,模型会本能地往那边钻,真正起防线作用的是写明「什么情况必须扣分」的条目。
- 自己训完的模型,要用不同家族的评委交叉验一遍。你写的那套量表,恰恰是模型最擅长优化的目标。既当考纲又当判卷老师,分数会好看到失去参考价值。
关于 DataMining 团队 我们(DataMining)由北京大学计算机学院软件所的博士生团队组建,长期为模型与智能体研发提供原创任务数据与评测基建,服务过字节跳动、阿里巴巴、腾讯等头部科技企业。在代码工程、复杂逻辑推理与长程沙盒交互领域,我们为合作方构建防作弊的独立验证环境与盲测数据集。 官方网站:datamining.cloud 技术与数据交流:contact@datamining.cloud
三个基本问题过完了。还有一个更让人不安的问题,一直绕在所有评测的外面。
当一份榜单被足够多的人反复研究之后,它还剩下多少参考价值?
我们在第一讲开头提过古德哈特定律:当一个指标被设定为目标,它就不再是一个好指标。题库被污染、榜单被反复拟合、测试集被悄悄记住,这些事正在真实发生。下一讲我们把它拆开看:《第四讲:当榜单开始被“优化”,我们还能相信什么分数?》
08延伸参考
- Gunjal et al. Rubrics as Rewards: Reinforcement Learning Beyond Verifiable Domains. Scale AI. arXiv:2507.17746, 2025.
- Mahmoud et al. Reward Hacking in Rubric-Based Reinforcement Learning. Scale AI. arXiv:2605.12474, 2026.
- Huang et al. Reinforcement Learning with Rubric Anchors. Inclusion AI, Ant Group & Zhejiang University. arXiv:2508.12790, 2025.
- Tian et al. V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning. S-Lab, Nanyang Technological University. arXiv:2608.25580, 2026.
- Xie et al. Step-wise Rubric Rewards for LLM Reasoning. NeurIPS 2026. arXiv:2605.17291, 2026.
- Arora et al. HealthBench: Evaluating Large Language Models Towards Improved Human Health. OpenAI. arXiv:2505.08775, 2025.