分数不是天然存在的,而是由评分规则加工出来的
大模型的分从来不是天然存在的,而是由一套评分规则加工出来的。看懂一张榜单,第一步不是看模型考了多少分,而是看阅卷人用的是精确匹配、抽样并集,还是大模型裁判。
上一讲我们把 Benchmark 拆解成了不同科目的试卷——知识记忆有 MMLU,数理推理有 GSM8K 和 MATH,代码工程有 HumanEval 和 SWE-bench,人类偏好有 Chatbot Arena。
但有了试卷,紧接着的问题就来了:谁来判卷?怎么判?判分的尺子本身,会不会出问题?
很多同学会下意识觉得,模型答对 1 分、答错 0 分,分数客观存在。但在大模型的评测与训练体系里,分数从来不是客观真理,而是评分规则加工的产物。
评分规则决定什么算对,也就决定了模型往哪个方向进化。看懂这一点,你才看得懂各大榜单背后的逻辑,也才看得懂 2026 年后训练行业正在发生的那场范式转移。
01客观题的硬尺子:从精确匹配到通过率
Exact Match:最朴素的判卷方式
对于选择题或填空题,最直观的规则就是 Exact Match(精确匹配)。模型输出必须和标准答案完全一致,连标点都不能差,才能拿到分。
这种规则简单粗暴,也最容易出问题。一道数学题标准答案是 3.14,模型输出 π 或 3.140,逻辑正确却判 0 分。数学评测通常要做归一化预处理,比如统一格式、去前导零,本身又多一层规则。
Pass@k:代码世界的殊途同归
到了代码评测,Exact Match 就彻底失效了。让模型写排序算法,标准答案用快速排序,模型写冒泡排序,逻辑正确也能通过所有测试用例,你总不能给 0 分。
因此代码科目引入了 Pass@k。让模型对同一道题生成 k 个代码候选,只要其中至少 1 个通过全部单元测试,就算这道题 Pass 了。
这里有个容易被忽略的细节:k 的取值直接决定分数的含义。Pass@1 衡量一次做对,接近真实体验;Pass@10 或 Pass@100 衡量多次尝试中至少对一次的上限。很多榜单代码分数很高,是因为用了 Pass@10 甚至更高,而非用户关心的 Pass@1。
SWE-bench 的 Resolve Rate:工程级的真刀真枪
到了 2025 年火起来的 SWE-bench,规则又进了一步。模型不再只是写一个函数,而是拿到一个真实的 GitHub 仓库和一个 Bug Issue,看它能否定位问题、提交有效补丁。
它的规则是 Resolve Rate(解决率)。补丁不仅要让原本失败的测试跑通,还要求绝对不能破坏仓库里原本已通过的历史测试。这种不许搞破坏的约束,比做对一道题严苛得多,更贴近工程验收。
02主观题的软尺子:从词频重叠到大模型裁判
如果说数学和代码还有硬尺子可量,那翻译、摘要、创意写作、开放式问答这些文科科目怎么判分?这才真正让人头疼。
传统 NLP 指标:BLEU、ROUGE 的局限
早期自然语言处理时代用的是 BLEU(机器翻译)和 ROUGE(文本摘要)这类词频重叠度指标,本质是数模型输出和参考答案重合了多少个 n-gram。
这种规则极其死板。意思正确但措辞不同的回答,可能因重叠度低而拿到很低分。更致命的是,它鼓励模型背诵标准答案的句式,而非真正理解问题。大模型时代已基本边缘化。
LLM-as-a-Judge:让大模型当裁判
2023 到 2024 年,业界找到了一个看似优雅的替代方案。用 GPT-4、Claude 这类更强的模型给其他模型的回答打分,通常是 1 到 10 分,或在两个候选间做 A/B 选择。
好处是快、便宜、可扩展。但问题也很明显:
- 长度偏见:大模型裁判倾向于给更长的回答打更高分,哪怕多出来的都是正确的废话。
- 格式偏见:用了 Markdown 列表、加粗标题的回答,往往比纯文本拿到更高分。
- 自我偏好:用 GPT-4 当裁判评 GPT-4 生成的内容,分数往往偏高;Claude 评 Claude 同理。
- 位置偏见:在 A/B 对比中,排在前面的候选更容易被选中。
这些偏见在 2024 年的多篇论文中已被反复验证。到了 2025 年,随着 LLM-as-a-Judge 被用作强化学习的奖励信号,危害被放大,因为模型不再只是被评,而是被训练。裁判的偏见会直接变成模型的进化方向。
人类偏好与 Elo 评分
Chatbot Arena(LMSYS)换了个思路,把裁判权交给真实人类。两个匿名模型同时回答同一问题,人类选出更好的那个,最终通过 Elo 算法算出排名。
这种方式最接近真实体验,但也有局限。它反映的是讨喜程度,不是专业正确性。一个语气礼貌、排版工整但判断有误的回答,在人类投票中常赢过措辞生硬但专业准确的回答。
032026 年的范式转移:评分规则从“评”变成“训”
讲到这里你可能会觉得,评分规则不就是评测用的吗?
但在 2025 到 2026 年,评分规则的角色发生了根本性变化。它不再只是评测工具,而是直接变成了强化学习的奖励信号。规则怎么写,模型就往哪个方向进化。
RLVR:可验证奖励的黄金时代
2025 年最火的后训练范式是 RLVR(Reinforcement Learning with Verifiable Rewards,可验证奖励强化学习)。核心逻辑很简单:找有标准答案的任务,做对给 1 分,做错给 0 分,用这个非黑即白的信号训模型。
DeepSeek-R1、OpenAI o3、Qwen3 这一代推理模型,很大程度上都是被这套 0 和 1 的奖励喂出来的。效果确实惊人,数学和代码基准上突飞猛进。
但问题也很明显,它只能覆盖有唯一标准答案的任务。你没法用三行 Python 断言判断一份并购风险备忘录写得好不好,也没法用单元测试验证一份医学诊断分析专不专业。
当“0 和 1”的尺子不够用了
到了 2026 年,行业里一个越来越清晰的共识是:人类世界里真正值钱的活儿,90% 都不是数学填空题。
金融尽调、法律合规审查、医疗影像分析、多步工具调用的 Agent 任务,这些高价值场景没有唯一标准答案,传统评分规则全部失效。
以前遇到这种任务,大厂只能退回人类偏好对齐,或找个大模型当裁判打印象分。结果训出来的模型全成了老好人:排版工整,语气礼貌,满篇正确的废话,业务判断一塌糊涂。
这不是模型笨,而是评分规则没有告诉它,好的标准到底是什么。
从“一个分数”到“一组采分点”
于是,2026 年下半年一个明显的趋势出现了:评分规则正在从给整体分数,走向拆成一组原子化采分点。
今年 8 月底,南洋理工大学 S-Lab 团队联合 A*STAR 发表了 V-Rubrics(arXiv:2608.25580,已开源 shulin16/v-rubrics)。他们用 Gemini-3-Pro 把 5 万道看图推理题的标准答案,拆成 35.2 万条原子级检查项。每条只查一件事,全部变成只答是或否的客观题,再配好权重塞进 GRPO 管线训练多模态模型。
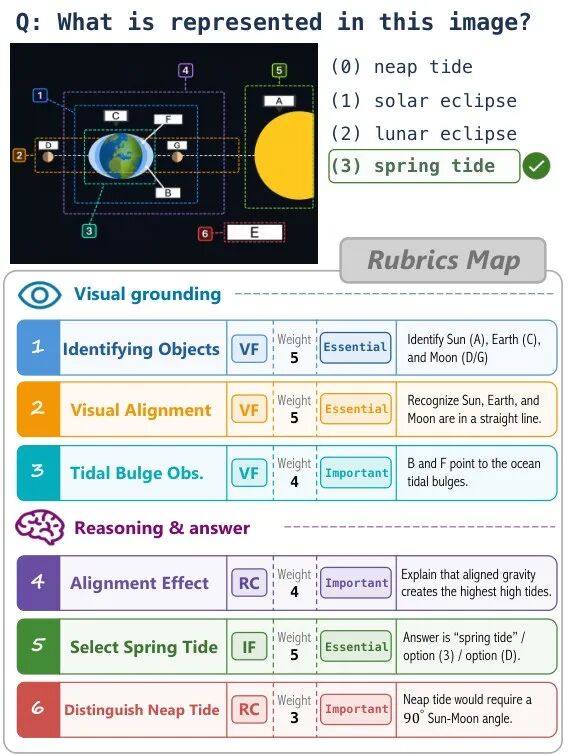
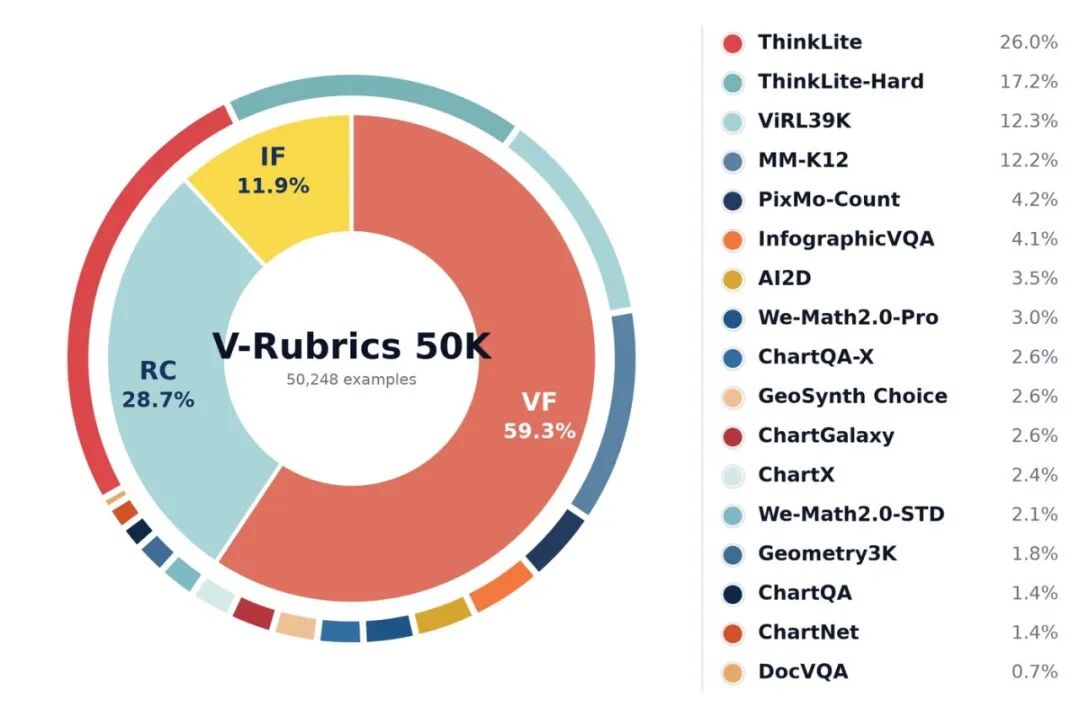
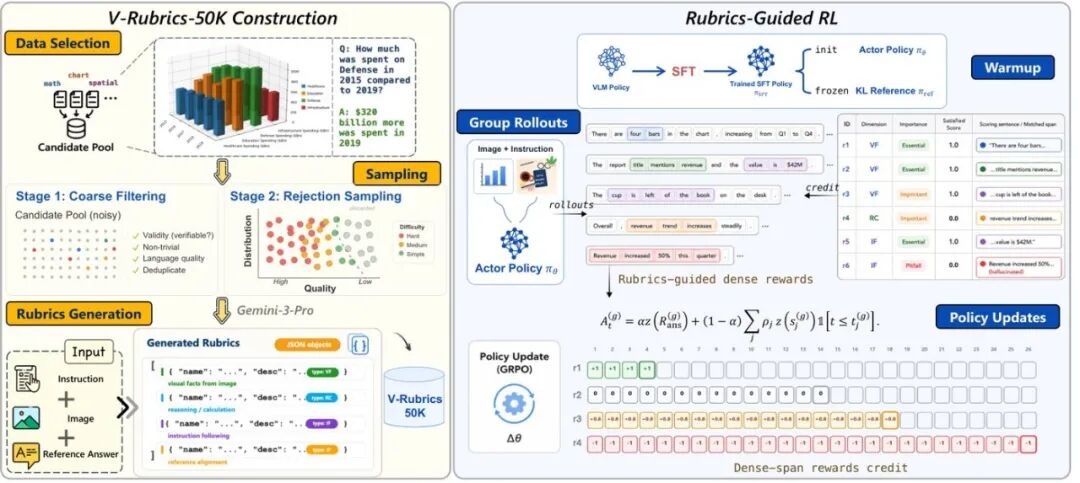
10 月 17 日,美国资管机构 The Vanguard Group 联合学术界发表了《Expert-Guided Rubrics as Dense Reward Signals for Reinforcement Learning in Non-Verifiable Domains》(arXiv:2610.26932),把金融服务里那些原本没法验证的意图理解、查询改写和合规检索,全拆成专家级评分细则当稠密奖励信号。
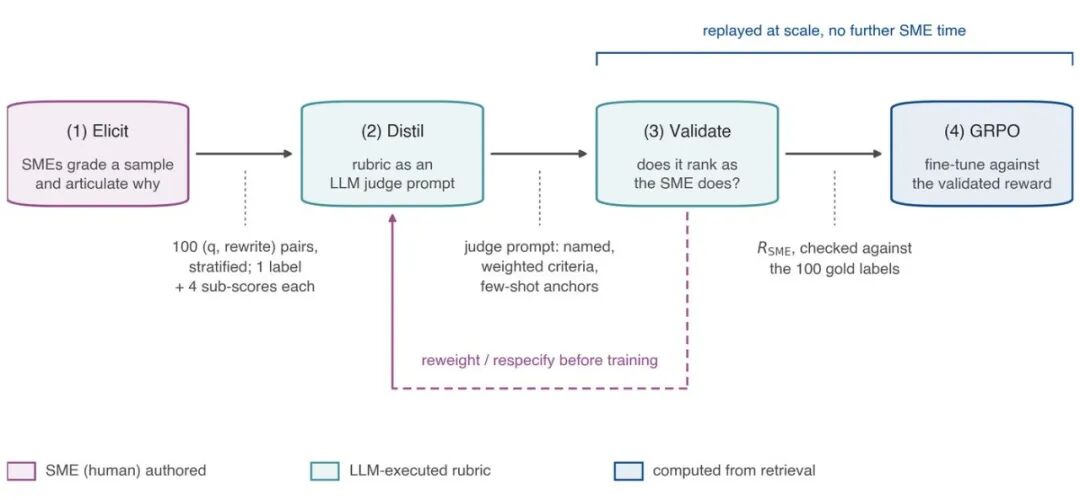
紧接着,艾伦研究所(AI2)开源了 DR Tulu(rlresearch/dr-tulu),用动态演化的评分规则训练深度研究智能体;清华大学与智谱团队开源了 CaRR(THUDM/CaRR),要求深度搜索 Agent 把每条采分点和网页引用证据链绑在一起才给分。
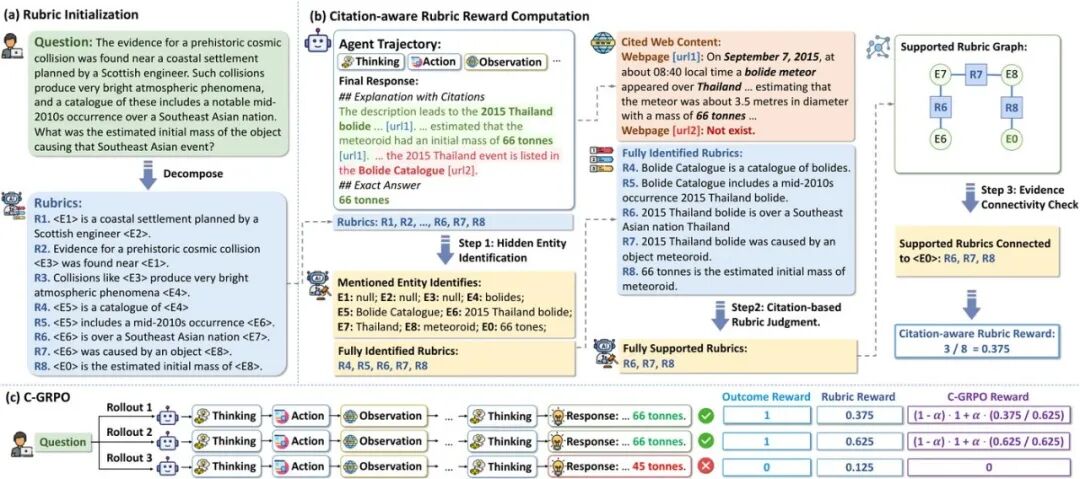
你会发现共同点是:不再让裁判凭印象打一个笼统分数,而是把好的标准拆成几十条可独立验证的原子断言。这已经不是规则升级,而是后训练范式的底层重构。
04评分规则设计的暗坑:来自一线的经验
在 datamining.cloud,我们过去几年一直在为大模型和智能体研发提供高质量任务数据与可执行评测环境。其中评分规则的设计是我们踩坑最多、也最有感触的环节。
“且”字陷阱
很多标注团队写评分标准时,会不自觉地写出这样的规则:模型需要准确且完整地回答问题。
这句话看起来没毛病,实际评分时会出大问题。如果模型回答准确但不完整,裁判该给分还是不给分?如果给了一半分,这一半是怎么来的?不同裁判判断完全不同。
我们现在的要求是一条标准只准查一件事,严禁出现“且”“同时”“并且”这种连词。准确性和完整性必须拆成两条独立检查项,各自打分。
只有加分项,没有重罚项
早期评分规则往往只有加分项,比如是否覆盖了所有关键子问题,是则 +5 分。
但真实业务里,有些错误的代价远高于答对的收益。比如医疗场景给出看似合理但剂量错误的用药建议;合规场景漏遮一个身份证号。这类错误被印象分淹没,后果不堪设想。
所以我们设计评分规则时强制要求设置重罚项。比如漏遮一个患者身份证号直接 -10 分,遗漏关键风险提示直接 -7 分。重罚项会让强化学习的梯度对这些业务暗礁格外敏感。
模型会钻规则的空子
这是最容易被低估的问题。评分规则被用于强化学习训练时,模型不是在学习,而是在优化。它会用你想象不到的方式钻规则的空子。
举个例子,规则要求回答包含至少三个具体例子,模型可能学会硬塞三个无关例子纯为凑数。规则要求引用必须来自提供的资料,模型可能学会大段复制原文,而不是真正理解。
应对办法是迭代打补丁。先用初版规则跑一轮训练或评测,分析输出,找出它怎么钻空子,然后针对性加入新约束。这个过程往往要反复好几轮。
评分规则必须绑定证据链
在深度研究和长文本生成场景中,另一个高频问题是裁判无法验证模型回答的事实性。
比如模型写了份行业分析报告,引用了三个数据来源。裁判如果没原始资料可对照,只能凭自己的知识判断,很容易误判。
所以现在的趋势是每条事实性采分点都必须绑定可核查的证据链。模型不仅要给出结论,还要标注它来自哪份文档、哪段、哪个数据点。清华智谱的 CaRR 项目就在这个方向做了扎实探索。
05评分规则正在重塑整个数据供应链
最后聊一个更宏观的观察。当评分规则从评变成训,从一个分数变成一组原子化采分点,影响已远远超出评测本身,正在重塑整个大模型数据供应链的底层逻辑。
以前,数据供应商交付的是题目加标准答案。甲方拿到手,跑个 Exact Match 或者 Pass@k,分数就出来了。
现在甲方要的不是标准答案,而是一套能稳定判分的规则体系。他们问的是:能不能把合伙人审案子、审计师查假账、医生看片子的隐性经验,写成几十条机器能判分的原子规则?
今年 10 月中旬,国内头部模厂与数据枢纽更新了 v2.0 版专业行业 Agent 采购规范。其中一条硬门槛是:每一道金融、财税、法务或医疗的长程任务,必须配套不少于 35 条原子级正负向 Rubrics。规矩极其严苛:一条标准只准查一件事,必须标出查的是哪份交付物文件,也必须有针对业务暗礁的重罚项。
谁能先把行业专家的隐性判断标准翻译成机器可执行的评分规则,谁就掌握了后训练下半场的核心资源。
06总结:分数是规则的产物,规则决定进化的方向
第一,分数不是天然存在的。同一个模型的回答,用不同评分规则去量,会得到完全不同的分数。
第二,评分规则经历了从硬尺子到软尺子再到原子化采分点的演进。从 Exact Match 到 Pass@k,到 BLEU 和 ROUGE,到 LLM-as-a-Judge,再到 Rubric 多维评分。
第三,2026 年评分规则的角色发生了根本性变化:它不再只是评测工具,而是直接变成了强化学习的奖励信号。
第四,传统评分规则面对开放式任务时已力不从心。当 0 和 1 的尺子无法衡量一份尽调报告或一次医学分析时,我们需要更精细的工具。
这就引出下一讲:面对没有标准答案的开放式任务,这套原子化采分点该怎么设计?
但现实中大量重要任务没有现成标准答案:让模型写一份几十页的行业报告、审一份复杂的合规合同,都无从打分。下一讲拆的就是这件事:第三讲:当题目没有标准答案时,如何评测。
关于 datamining.cloud 我们(DataMining)由北京大学计算机学院软件所的博士生团队组建,长期专注为大模型与智能体研发提供高质量原创任务数据与评测环境,曾服务字节跳动、阿里巴巴、腾讯等头部科技企业。 在代码工程、复杂逻辑推理与长程沙盒交互领域,持续为合作方构建防作弊的独立验证环境、真实业务测试探针与盲测数据集,杜绝虚高采样造成的选型误判。 官方网站:datamining.cloud 技术与数据交流:contact@datamining.cloud
07延伸参考
- Tian et al. V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning. arXiv:2608.25580, 2026.
- Bansal et al. Expert-Guided Rubrics as Dense Reward Signals for Reinforcement Learning in Non-Verifiable Domains. arXiv:2610.26932, 2026.
- Zhang et al. Chaining the Evidence: Robust Reinforcement Learning for Deep Search Agents with Citation-Aware Rubric Rewards. ACL 2026.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. ICML 2024.