大模型评测 Rubric 设计指南:评分标准为什么会把模型训成老油条
把「好」这个字拆成几十条可以逐条核对的断言,模型才知道该练什么。标准越含糊,模型越会学会用排版、语气和字数去迎合评分。奖励什么,模型就练成什么样可核对的原子断言。
如果你最近在做 LLM-as-a-Judge(大模型裁判),或者用 Rubric 给强化学习当奖励信号,你大概率遇到过这种「灵异事件」。
评测侧,模型在评测集上拿了 90 分,人类专家一看输出直摇头,满篇正确的废话,核心业务逻辑全错。
训练侧,你把专家写的评分表喂进 RL 管线当奖励,训出来的模型学会了投机取巧。排版极其工整,语气极其礼貌,字数凑得很长,一进真实业务环境就现原形。
问题出在哪。出在你的 Rubric 上。
在 2026 年的大模型后训练与评测体系里,Rubric 早就不是传统教育界那种打分表。它是 LLM Judge 的判案依据,更是强化学习管线的梯度来源。
结合 2026 年公开的几项代表性工作(圣母大学与 Uniphore 的 AutoRubric[3]、南洋理工 S-Lab 的 V-Rubrics[4]、清华与智谱的 CaRR[5]),以及我们在 datamining.cloud 一线交付评测环境的经验,这篇文章讲透一件事,如何设计一套既能挡住模型作弊,又能给出稠密训练信号的工业级 Rubric。
无论你是刚入门的评测工程师,还是正在死磕 RL 奖励函数的算法负责人,这篇都会让你有不一样的收获。
01入门认知,Rubric 不是 Prompt,是一份判定契约
很多初学者写 Rubric,本质上是在写 Prompt。
「请评估这篇并购风险备忘录是否准确、完整、流畅,并给出 1-5 分。」
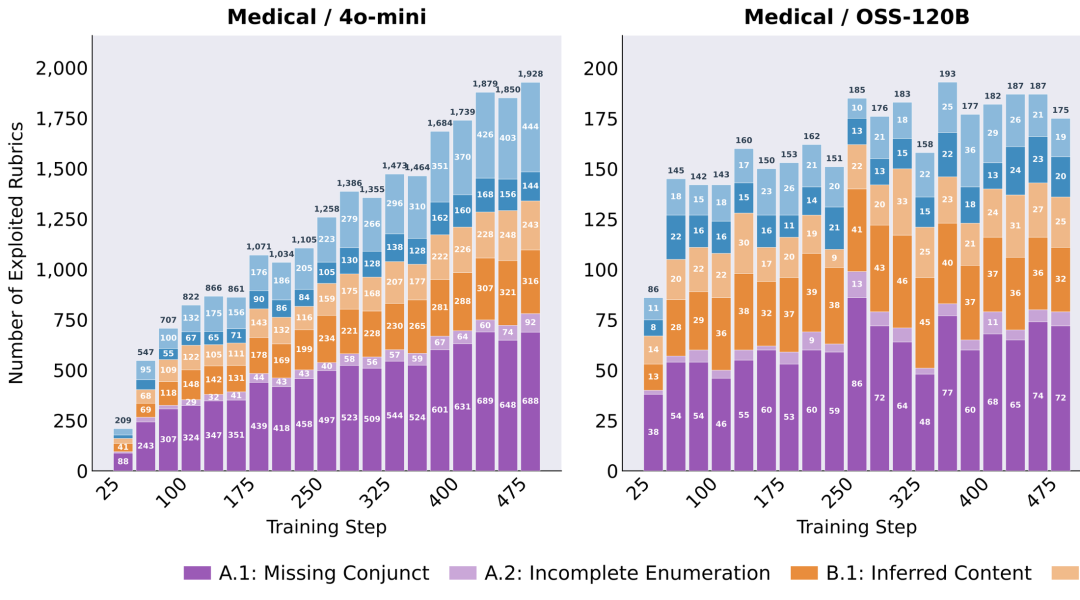
这在文献里通常叫 holistic(整体式)评分[1]。它的致命缺陷是标准模糊。标准一旦模糊,裁判就只能依赖自己的先验。倾向于给长答案打高分,倾向于给结构清晰、语气客气的输出打高分。Scale AI 那篇专门研究评分标准被钻空子的论文给了这条的直接证据,训练过程中响应长度持续上涨,而长度与「存在性 / 完整性」类条款的满足率强相关[6]。
工业界真正在用的,是 analytic(分析式)评分[1]。把「好」这个抽象概念拆解成几十条可观察、可证伪的原子断言。
这里要补一句容易被忽略的事实,拆得越细并不总是更好。CMU 与 Google Research 做过一组受控实证,发现分析式评分并不稳定优于整体式评分,标准复杂度升高加上保守的聚合方式,反而会拉低人类与自动评分者的一致性[2]。清华团队的系统综述也指出,在要求高完整性的任务上,配了详细标准的整体式评判反而优于原子式评判[1]。
所以正确的说法不是「越拆越科学」。拆分的收益取决于任务类型和聚合方式,评测侧要单独做一致性测量,不能靠直觉决定拆不拆。
「拆分的收益不来自「更细」,来自「更可核对」。判分依据必须能指回原始材料的一个具体位置,否则拆得再细也只是把印象分切碎。」
一个能用的 Rubric 至少要有三样东西。
- 维度(Dimension),你要查什么,比如财务数据一致性。
- 锚点(Anchors),什么叫好,什么叫坏,边界必须明确。
- 证据源(Evidence Source),裁判去哪里核对事实。
差的 Rubric 长得像 Prompt。
「检查备忘录中的财务数据是否准确。」
好的 Rubric 长得像原子断言。
「检查备忘录第 2.1 节中提及的『2025 年 Q3 净利润』,是否与 input_files/财报_2025Q3.pdf 第 14 页的 Non-GAAP Net Income 数值一致(允许四舍五入误差在 0.1% 以内)。」
前者让裁判凭印象打分,后者让裁判做核对。把主观评价降维成可核对的动作,裁判之间的方差才能压下去。
02业内避坑,量规设计的四个高频缺陷
在我们对外部众包量规的抽样复核中(抽样方式:从已交付批次中随机抽取被判废的量规),有四类缺陷反复出现,占了被打回量规的大头。它们不是新手手误,而是量规这门手艺里最容易踩空的地方。
缺陷一:「且」字陷阱,一条标准查了两件事
标注员喜欢写「检查模型是否准确且完整地回答了用户问题」。
如果模型回答准确但不完整,裁判该判通过还是不通过。裁判会卡在逻辑死锁里,最后随机吐一个分数,奖励信号里全是噪声。
解法很朴素,一条标准只准查一件事。严禁出现「且」「同时」「并且」这种连词,必须拆成「核心概念准确性」和「关键子问题覆盖率」两条独立标准。
缺陷二:没有一票否决项,惩罚项轻得没有存在感
量规里全是 +3、+5 的加分项,没有惩罚项。模型很快学会用华丽排版掩盖事实错误,字数够多、态度够好就能拿基础分。
惩罚项不能只是名义上的负分。腾讯混元、清华与北大在 RLMR 那篇论文里给出了具体做法。先让违规样本的奖励变成 rᵢ 减 δ,再推导出惩罚下界必须满足 δ ≥ (n·r_max^vio + n·γ − Σrᵢ) / (n − k),其中 r_max^vio 是组内所有违规样本中最高的原始奖励。只有把 δ 设在这个界之上,才能保证全部违规样本在 GRPO 标准化之后拿到负 advantage,被梯度系统性抑制[11]。
换成大白话,惩罚项的量级必须由组内最高违规奖励反推出来,而不是拍脑袋填一个 -5。
缺陷三:证据链悬空,裁判只能靠记忆判事实
让裁判评估「模型引用的法律条文是否正确」,却不给裁判法律数据库。裁判只能靠预训练记忆去判,如果裁判本身存在幻觉,就会把模型的幻觉判成正确,形成幻觉奖励。
清华与智谱的 CaRR 把这件事写进了机制设计里。一条轨迹只有同时做到显式点出隐藏实体、给出的引用被网页原文支撑、且已满足的标准串成通向最终答案的完整证据链,才算满足该条标准[5]。南洋理工的 V-Rubrics 则把参考回答拆成 352,938 条原子标准,分布在视觉忠实度、推理一致性、指令遵循三个维度上,每条都要回指原图或原题的具体位置[4]。
落到写法上,每一条事实性采分点,都必须绑定真实的引用证据源。例如「判断结论是否成立,必须且仅能依据 context/案卷A.pdf 第 3-5 页的证词,模型引入了外部未提供的信息则判不通过」。
缺陷四:正负号语义反转,工程编译时全盘颠倒
人类专家设计量规表格时,习惯写一个维度叫「未编造事实」,权重填 -10,意思是如果编造了就扣 10 分。
如果工程脚本直接照抄这张表生成代码,裁判判「未编造 = True (1)」时乘上 -10,模型反而被扣了 10 分;模型真的编造了事实(判定为 0)时,反而一分不扣。
解法是从「专家可读的量规」到「RL 可执行的奖励函数」之间,加一道严格的工程编译与符号对齐层。所有条件统一转成「触发即得分」或「触发即熔断」,不保留负号语义。
03高阶心法,让 Rubric 变成稠密奖励信号
如果只把 Rubric 当评测工具,你只用了它一小部分价值。2026 年 Rubric 最大的威力在于,它正在成为非可验证领域最主流的稠密奖励信号。
数学和代码有单元测试可以给 0/1 奖励。但在金融尽调、法律审查、多步 Agent 工作流里,没有单元测试。Scale AI 的 RaR 把实例特定量规直接作为 on-policy RL 的奖励信号,把可验证奖励的边界往外推了一大步,最好的变体相对基于直接 Likert 打分的裁判基线,在 HealthBench 上取得最高 31% 的相对提升,在 GPQA-Diamond 上取得 7% 的相对提升[7]。
蚂蚁集团与浙江大学随后给出了两套可复现的公开方案。Rubicon(Rubric Anchors)构建了超过 10,000 条人工量规的奖励库,只用 5K 余条训练样本在 Qwen3-30B-A3B 上完成两阶段 RL,得到的 Rubicon-preview 在人文学科导向的开放式基准上取得 5.2 个百分点的绝对提升,比 671B 的 DeepSeek-V3 高 2.4 个百分点[8]。CoCA 则指出标准 rubric-based RL 有两处浪费。条款级反馈被压成标量奖励,token 优势被均一分配,结构化的量规监督等于没用上。CoCA 把问题改写成条款感知的信用分配,用「加入该条款条件后 next-token 分布的 JSD 偏移」作为相关性线索,把信用细化分配到 token 上,在七个医学与科学基准上平均 64.5%,相对作为标准基线的 RaR(60.3%)提升 4.2 个百分点[9]。
另一条路线来自产业侧。The Vanguard Group 的论文把一次性、有限的主题专家判断转化为稠密奖励,用专家校验过的量规分数与检索指标混成 GRPO 兼容的混合奖励,论文以金融服务这类不可验证领域为动机,实际实验在 Natural Questions 开放域检索的查询改写上进行,Recall@3 从稀疏奖励基线的 67.96 提升到 74.00[10]。
组内排序:区分「糙过」和「精过」
RL 训练里,一道难题模型采样 16 次,其中 4 次都通过了底线标准,这 4 条轨迹都给 +1.0 奖励,行不行。
不行。这样做会丢掉组内的区分度,进而带来策略坍缩。锐化税(Sharpening Tax)这个概念描述的正是后训练相对基座模型损失测试时可扩展性的现象,Meta Superintelligence Labs 与威斯康星大学麦迪逊分校、NYU、斯坦福大学合作,在 14 对 base/post-trained 模型、3 个 agentic 基准共 42 个 case 上验证了它的普遍存在[12]。
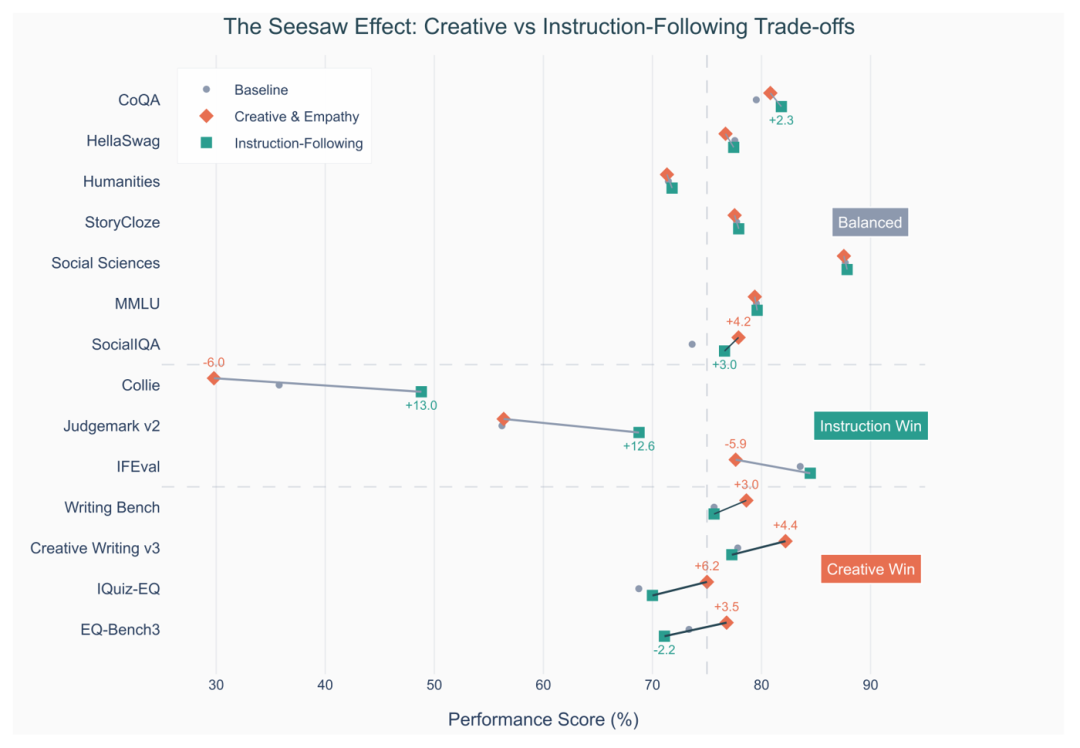
高阶做法是在通过底线标准的组内挂第二层排序量规,比如「代码改动面是否最小」「推理步骤是否冗余」,把正向优势从撞大运糙过的轨迹,挪给干净通过的轨迹。
对抗演进:用 Hacker-Fixer 循环修补量规
模型是非常聪明的奖励黑客。如果你的量规规定「必须包含 3 个风险提示」,模型可能就在文末用白底白字写三遍风险提示来骗分。
对应的机制叫 hacker-fixer 循环,在《Hardening Agent Benchmarks with Adversarial Hacker-Fixer Loops》里被明确命名并形式化。黑客模型试图不解题就骗过验证器,修复模型打补丁堵住已发现的漏洞,解题模型确认打补丁之后合法解仍能被接受,每次打补丁都会改变验证器奖励的行为,从而暴露下一个漏洞。在 KernelBench 上,这个循环把针对已公开漏洞的攻击成功率从 62% 压到 0[13]。
如果你要防的是量规层面的钻空子,最近似的工作是 RubricArmor 的 attack-repair 迭代循环[14]。
04实战手册,一套工业级量规模板
下面是我们在 datamining.cloud 交付「跨期错账核对与合规审计 Agent」这类任务时使用的一套标准量规结构。交付包按开源框架 Harbor(github.com/harbor-framework/harbor,Terminal-Bench 官方 harness)定义的 Harbor Task 规范封装,每个任务目录含 instruction.md、task.toml、environment/、solution/ 与 tests/,可独立拉起容器并产出 verifier reward。Harbor Task 是第三方框架的通用格式,我们按其原生规范交付,不做私有改造。
量规本身按下面的结构落在一个独立的 rubric 文件里(示例结构,实际项目会按客户数据字段调整)。
task_id: "fin-audit-cross-period-001"

# 聚合逻辑:底线门控 + 加权求和
aggregation_logic: "baseline_gate_and_weighted_sum"

# 1. 底线门控项(Hard-stop,一票否决)
hard_stops:
  - id: "HS-01"
    dimension: "数据隐私合规"
    criterion: "最终输出的审计报告中,所有涉及自然人的身份证号/银行卡号是否都做了 '*' 脱敏?"
    evidence_anchor: "input_files/raw_ledger.csv 的 user_id 列"
    penalty: -100

  - id: "HS-02"
    dimension: "事实性幻觉"
    criterion: "报告中提及的所有异常流水金额,是否都能在 raw_ledger.csv 中找到精确对应的 transaction_id?严禁捏造流水。"
    evidence_anchor: "input_files/raw_ledger.csv"
    penalty: -100

# 2. 正向采分项(单一动作 + 证据绑定)
positive_rubrics:
  - id: "P-01"
    dimension: "跨期逻辑识别"
    criterion: "是否准确识别出 2025-12-31 23:50 至 2026-01-01 00:10 期间的重复扣款异常模式?"
    weight: +15
    evidence_anchor: "raw_ledger.csv 的时间戳与 transaction_type 列"

  - id: "P-02"
    dimension: "根因定位"
    criterion: "是否将异常根因归结为网关超时重试未做幂等校验,而非用户恶意刷单?"
    weight: +10
    evidence_anchor: "input_files/system_architecture.md 第 4.2 节"

# 3. 负向重罚项
negative_rubrics:
  - id: "N-01"
    dimension: "格式冗余"
    criterion: "报告开头是否使用了超过 200 字的「作为 AI 助手,我需要提醒您……」之类套话?"
    weight: -5
    evidence_anchor: "output/report.md 前 3 行"
这套结构能打,原因是三件事。
- 聚合逻辑清晰。先查底线门控。只要漏遮一个身份证号,后面的逻辑分析写得再漂亮,奖励也是 0。模型没有机会用才华掩盖不该犯的错。
- 证据锚点强制绑定。裁判打分时,系统会把 evidence_anchor 对应的文件片段高亮喂给裁判,印象分没有生存空间。
- 区分糙过与精过。像 N-01 这种负向项,能把「找出了 Bug 但满篇废话」的轨迹在 RL 组内排序里降级。
还要补一条工程纪律。这张表是给人看的,喂进 RL 管线的那份必须经过符号对齐层重新生成,不要直接拿表格里的负数去乘布尔值。
05结语,谁定义了好,谁就掌握了后训练的主动权
回到开头的问题,为什么你的模型像个老油条。
因为你交给模型一个模糊的「好」的定义,模型自然会用它最擅长的伪装来迎合你。
在 2026 年的大模型下半场,数学题和代码库的可验证奖励已经被刷穿。真正的深水区在金融、法律、医疗、多步 Agent 这些没有标准答案的开放域。
在这些领域,Rubric 就是唯一的法律。
「谁先把阅卷室建好,谁就能在真实商业世界里,训出真正能干活的 Agent。」
别再让大模型当和事佬了。去写你的判定契约,去建你的标准化阅卷室。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,专注为大模型与智能体研发提供高质量原创任务数据与可执行评测环境。我们不仅交付数据,也交付可复现的 Rubric 评分准则,以及按开源框架 Harbor(harbor-framework/harbor)的 Harbor Task 规范封装的独立可启动容器环境与验证器。 长程代码与工程仿真:Deep SWE、Frontier SWE、Frontier-Eng、ALE(Harbor Task 独立 Docker 封装)等,支持 200 题/周、7 个工作日稳定交付。 极限数理与专业 Agent:HLE 严格多模态产线(现货 5000+ 题);Harvey LAB、AutomationBench、Toolathlon,以及 35 至 60 条正负对冲的原子级 Rubrics 行业工作流包。 系统底座与具身真机:Win11/Ubuntu 标准化桌面 Agent 虚拟机镜像,以及百万级具身智能 Grounding / SFT / DAgger 真机定制产线。 本文提到的基准均为公开第三方基准,我们只对齐其能力要求与难度区间,不复制题目。文中难度对齐与交付能力为我们的内部同口径对比结论,不代表第三方基准方的官方结论。 官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud
06参考资料
[1] Autorubric: A Unifying Framework for Rubric-Based LLM Evaluation on Non-Verifiable Tasks,Delip Rao、Chris Callison-Burch,University of Pennsylvania,COLM 2026,arXiv:2603.00077。
[2] Quantifying the Statistical Effect of Rubric Modifications on Human-Autorater Agreement,Carnegie Mellon University 与 Google Research,arXiv:2605.06283。
[3] AutoRubric: Rubric-Based Generative Rewards for Faithful Multimodal Reasoning,Mengzhao Jia 等,University of Notre Dame 与 Uniphore,Findings of ACL 2026,arXiv:2510.14738。
[4] V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning,Shulin Tian 等,Nanyang Technological University S-Lab、A*STAR 与 UIUC,EMNLP 2026 主会,arXiv:2608.25580。
[5] Chaining the Evidence: Robust Reinforcement Learning for Deep Search Agents with Citation-Aware Rubric Rewards(CaRR),清华大学与智谱 AI,ACL 2026,arXiv:2601.06021。
[6] Reward Hacking in Rubric-Based Reinforcement Learning,Anas Mahmoud 等,Scale AI,arXiv:2605.12474。
[7] Rubrics as Rewards: Reinforcement Learning Beyond Verifiable Domains(RaR),Anisha Gunjal 等,Scale AI,arXiv:2507.17746。
[8] Reinforcement Learning with Rubric Anchors(Rubicon),Zenan Huang 等,Inclusion AI、蚂蚁集团与浙江大学,arXiv:2508.12790。
[9] CoCA: Criterion-Aware Credit Assignment for Rubric-Based Reinforcement Learning,Guangcheng Zhu 等,浙江大学与蚂蚁集团,arXiv:2610.17733。
[10] Expert-Guided Rubrics as Dense Reward Signals for Reinforcement Learning in Non-Verifiable Domains,Ashish Bansal 等,The Vanguard Group,ICAIF ACM RL4LLM-Agents workshop,arXiv:2610.26932。
[11] RLMR: Reinforcement Learning with Mixed Rewards for Creative Writing,Jianxing Liao 等,腾讯混元、清华大学与北京大学,arXiv:2508.18642。
[12] Sharpening Tax in Post-Training,Changdae Oh 等,Meta Superintelligence Labs、威斯康星大学麦迪逊分校、纽约大学与斯坦福大学,arXiv:2610.01509。
[13] Hardening Agent Benchmarks with Adversarial Hacker-Fixer Loops,Ziqian Zhong 等,Carnegie Mellon University 与 Fewshot,arXiv:2606.08960。
[14] RubricArmor: Adversarial Evolution Improves LLM-Based Rubric Generation,新加坡国立大学等,arXiv:2610.05308。
[15] Introducing Harvey's Legal Agent Benchmark(LAB),Harvey 官方博客,harvey.ai,2026 年。