一条长程任务轨迹跑崩了,删掉还是留下来
快照回滚能把 50 原语、8 应用档的采集成功率从 0.0% 拉到 18.7%,代价是把死掉的分支一起丢掉。只交分子不交分母,任何任务看上去都是高通过率。
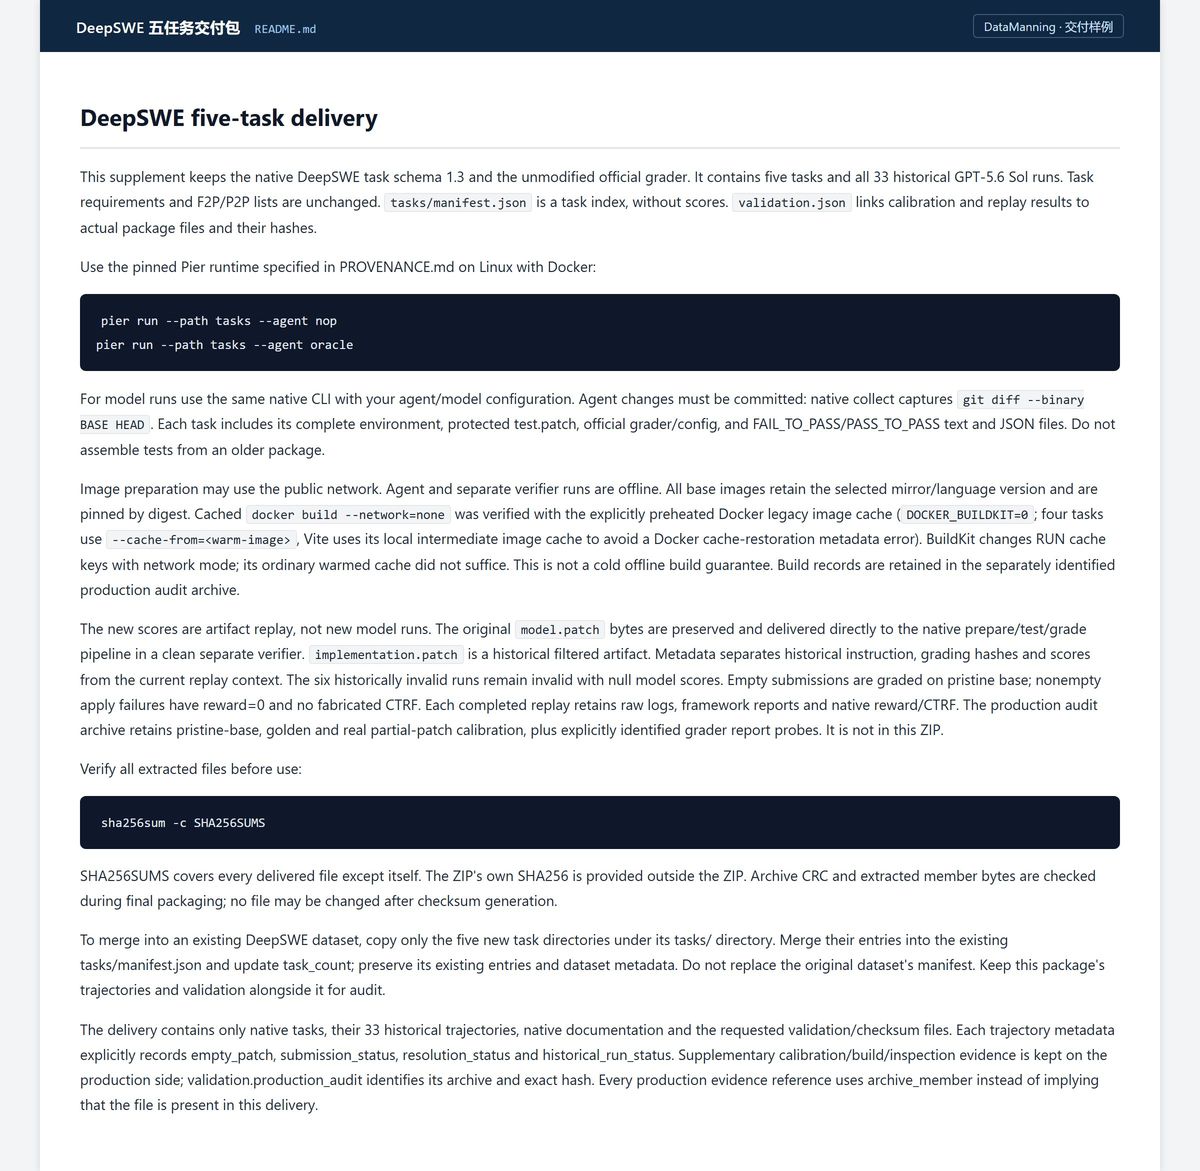
我们的 Deep SWE 同类交付包里,外层有一个 validation.json。这包数据 5 个仓库级任务,一共 33 条历史运行,27 条有效。6 条是历史无效运行,模型得分保持 null,不删。剩下 27 条里有 3 条跑完但补丁是空的,按 0 分在干净基线上评分,元数据单独标出来。
按行业里最省事的做法,打包前跑一行过滤脚本,把 6 条无效记录删掉,总数改成 27,交付包看上去干干净净,100% 有效。我们的规矩是反的:6 条保持 null,3 条空补丁如实标注,外层配齐 SHA256SUMS 和 PROVENANCE.md,打包时做包级 CRC 与字节校验。
manifest.json 里的审计状态写的是 PASS_WITH_LIMITATIONS,不是 PASS。同一份文件里还有一条 native_environment_verified: false,说明我们没在原生 Linux 内核加载和操作系统级隔离上做过认证。交付包 README 也写明了:这是一份难度筛选过的小样本开发集,不构成官方基准优越性证明。
11 月 2 日,arXiv 上挂了一篇 CUA-Master(2611.03126),提出一套 CUA 的递归改进框架,产出 127K 训练数据,训出 27B 模型。里面有个机制和我们正好相反。
为了解决跨应用长程任务成功率低的问题,他们做了快照回滚:验证失败或检测到低效时,检测器同时看验证器残差、已采轨迹和可执行环境,估算出「最早偏离步」,给一段不暴露特权动作解的反馈,把环境退回到该步之前最近的合法快照,保留稳定前缀、丢掉错误后缀,带着反馈重试。这轮分支搜索结束后,只保留成功且最高效的那一条。
在训练侧这个取舍合理。论文给的理由是:失败通常来自局部误操作,前面大半段轨迹仍然有效,整段重跑浪费算力;成功轨迹里也有冗余动作和多余观察。丢掉低效后缀,还能避免把状态不一致的片段当成监督信号。
但站在采集侧和验收侧,看法不一样。为了救活一条能进训练集的正例,你把同一次搜索里死掉的分支一起丢了。
01回滚救活的是轨迹,丢掉的是分母
这套机制效果很猛。同一个重试预算下,「从零重来」和「快照回滚加反馈」的采集成功率差得很远:
- (5,1):74.0% → 95.4%
- (20,1):31.5% → 83.7%
- (20,3):19.3% → 56.9%
- (20,5):1.9% → 32.8%
- (50,8):0.0% → 18.7%
论文 Table 3 一共九档,这里挑五档。K 是能力原语数,N 是涉及的应用数。在 50 个原语、8 个应用这档,从零重来是 0.0%,回滚能到 18.7%。也就是说每拿到 1 条成功轨迹,平均要跑五次出头,剩下全是废弃分支。
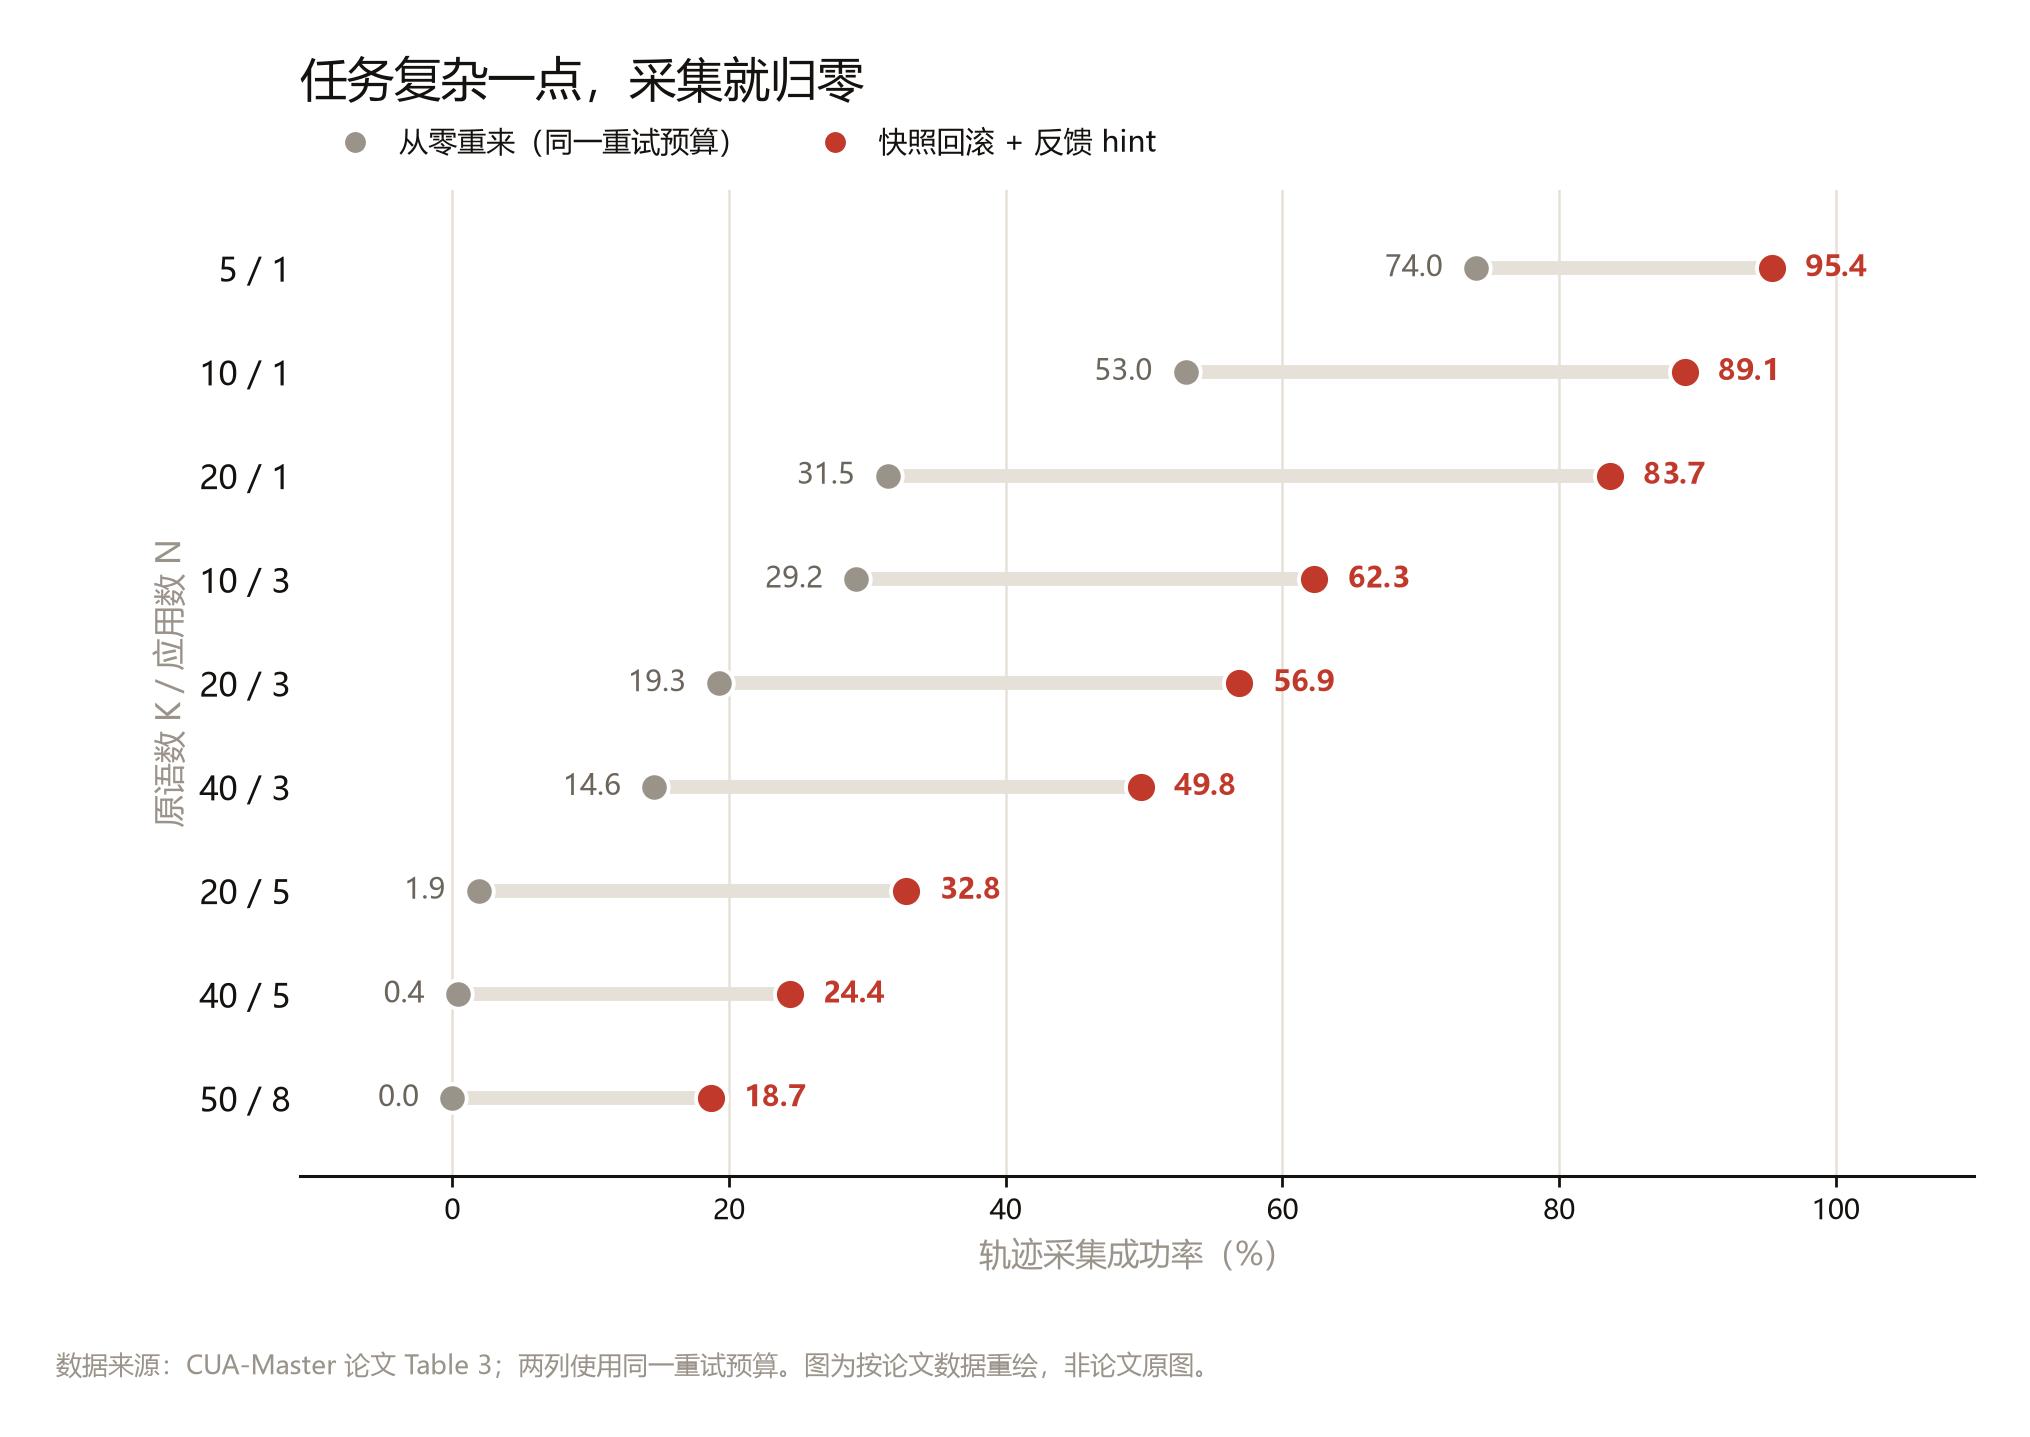
站在算法团队的角度,这没问题:SFT 要的就是干净正例。但如果你是掏钱买数据的人,供应商拿这套机制交货,你拿到的那条成功轨迹就失去了它在真实分布里的位置。你看到分子成了 1 条,看不到分母:在哪个步骤回滚了多少次、死掉多少条分支才凑出这 1 条。只交分子,任何任务看上去都是高通过率。
02死掉的现场,是标定难度的原料
为什么我们在交付规范里死磕失败不删?因为跑崩的容器、耗尽的预算、被撤回的废题,是标定难度的原料。这不是一句好听的话,是三件具体的事。
第一件,标定这道题到底多难。
tbs 这个科学计算题包,我们做了 8 道候选,最后只交 3 道。淘汰的 5 道里,4 道是被 DeepSeek-V4-Flash-Vision-Exp 直接解出来了,说明太简单;1 道是复核时发现参考答案漏计了一个极小区域,358 个正面积单元对 357 个,漏掉的那块面积约 6.16e-13,主动撤回。这 5 道全部留在包里:candidates/ 下 3 道,supplement/candidates/ 和 posterior/candidates/ 各 1 道。
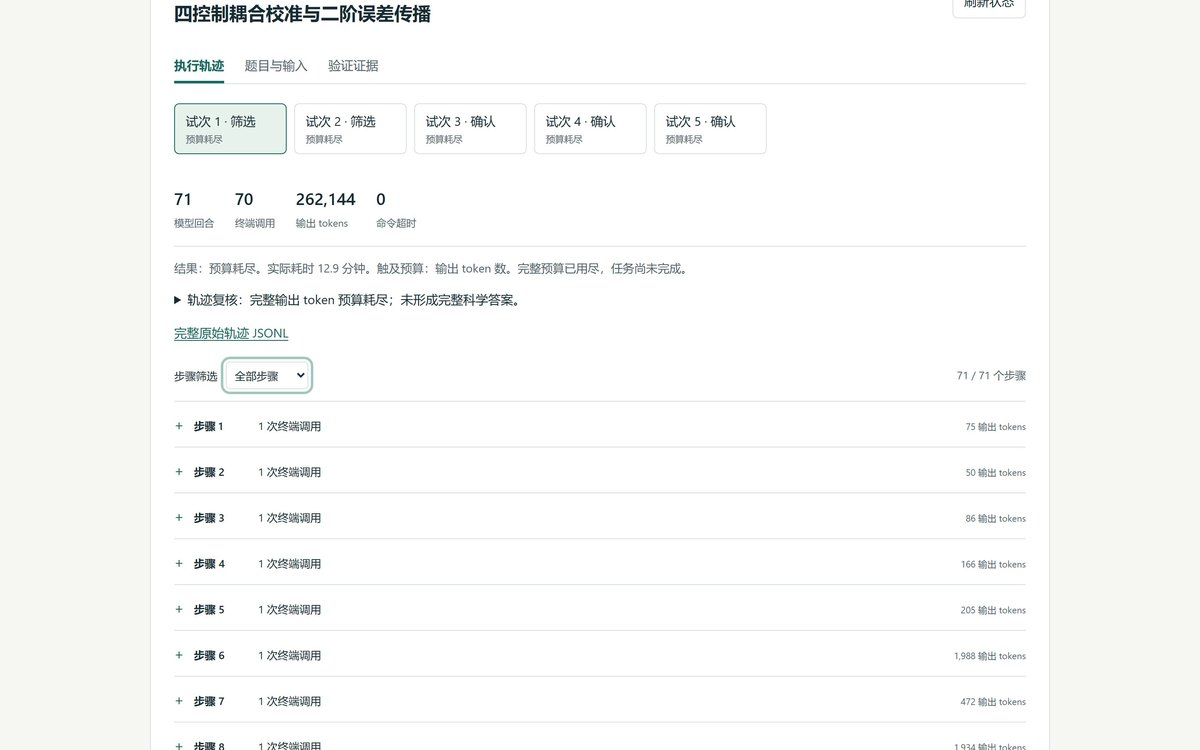
留下的题有多难,得靠失败记录作证。入选的「四控制耦合校准」题,我们跑了 5 个试次,2 次筛选加 3 次确认。预算上限是 80 轮、1800 秒、262,144 输出 token,断网 docker。5 次全部耗尽。轨迹查看器里单题实录:71 个模型回合、70 次终端调用、26.2 万输出 token,跑到 12.9 分钟时输出 token 先用完了。
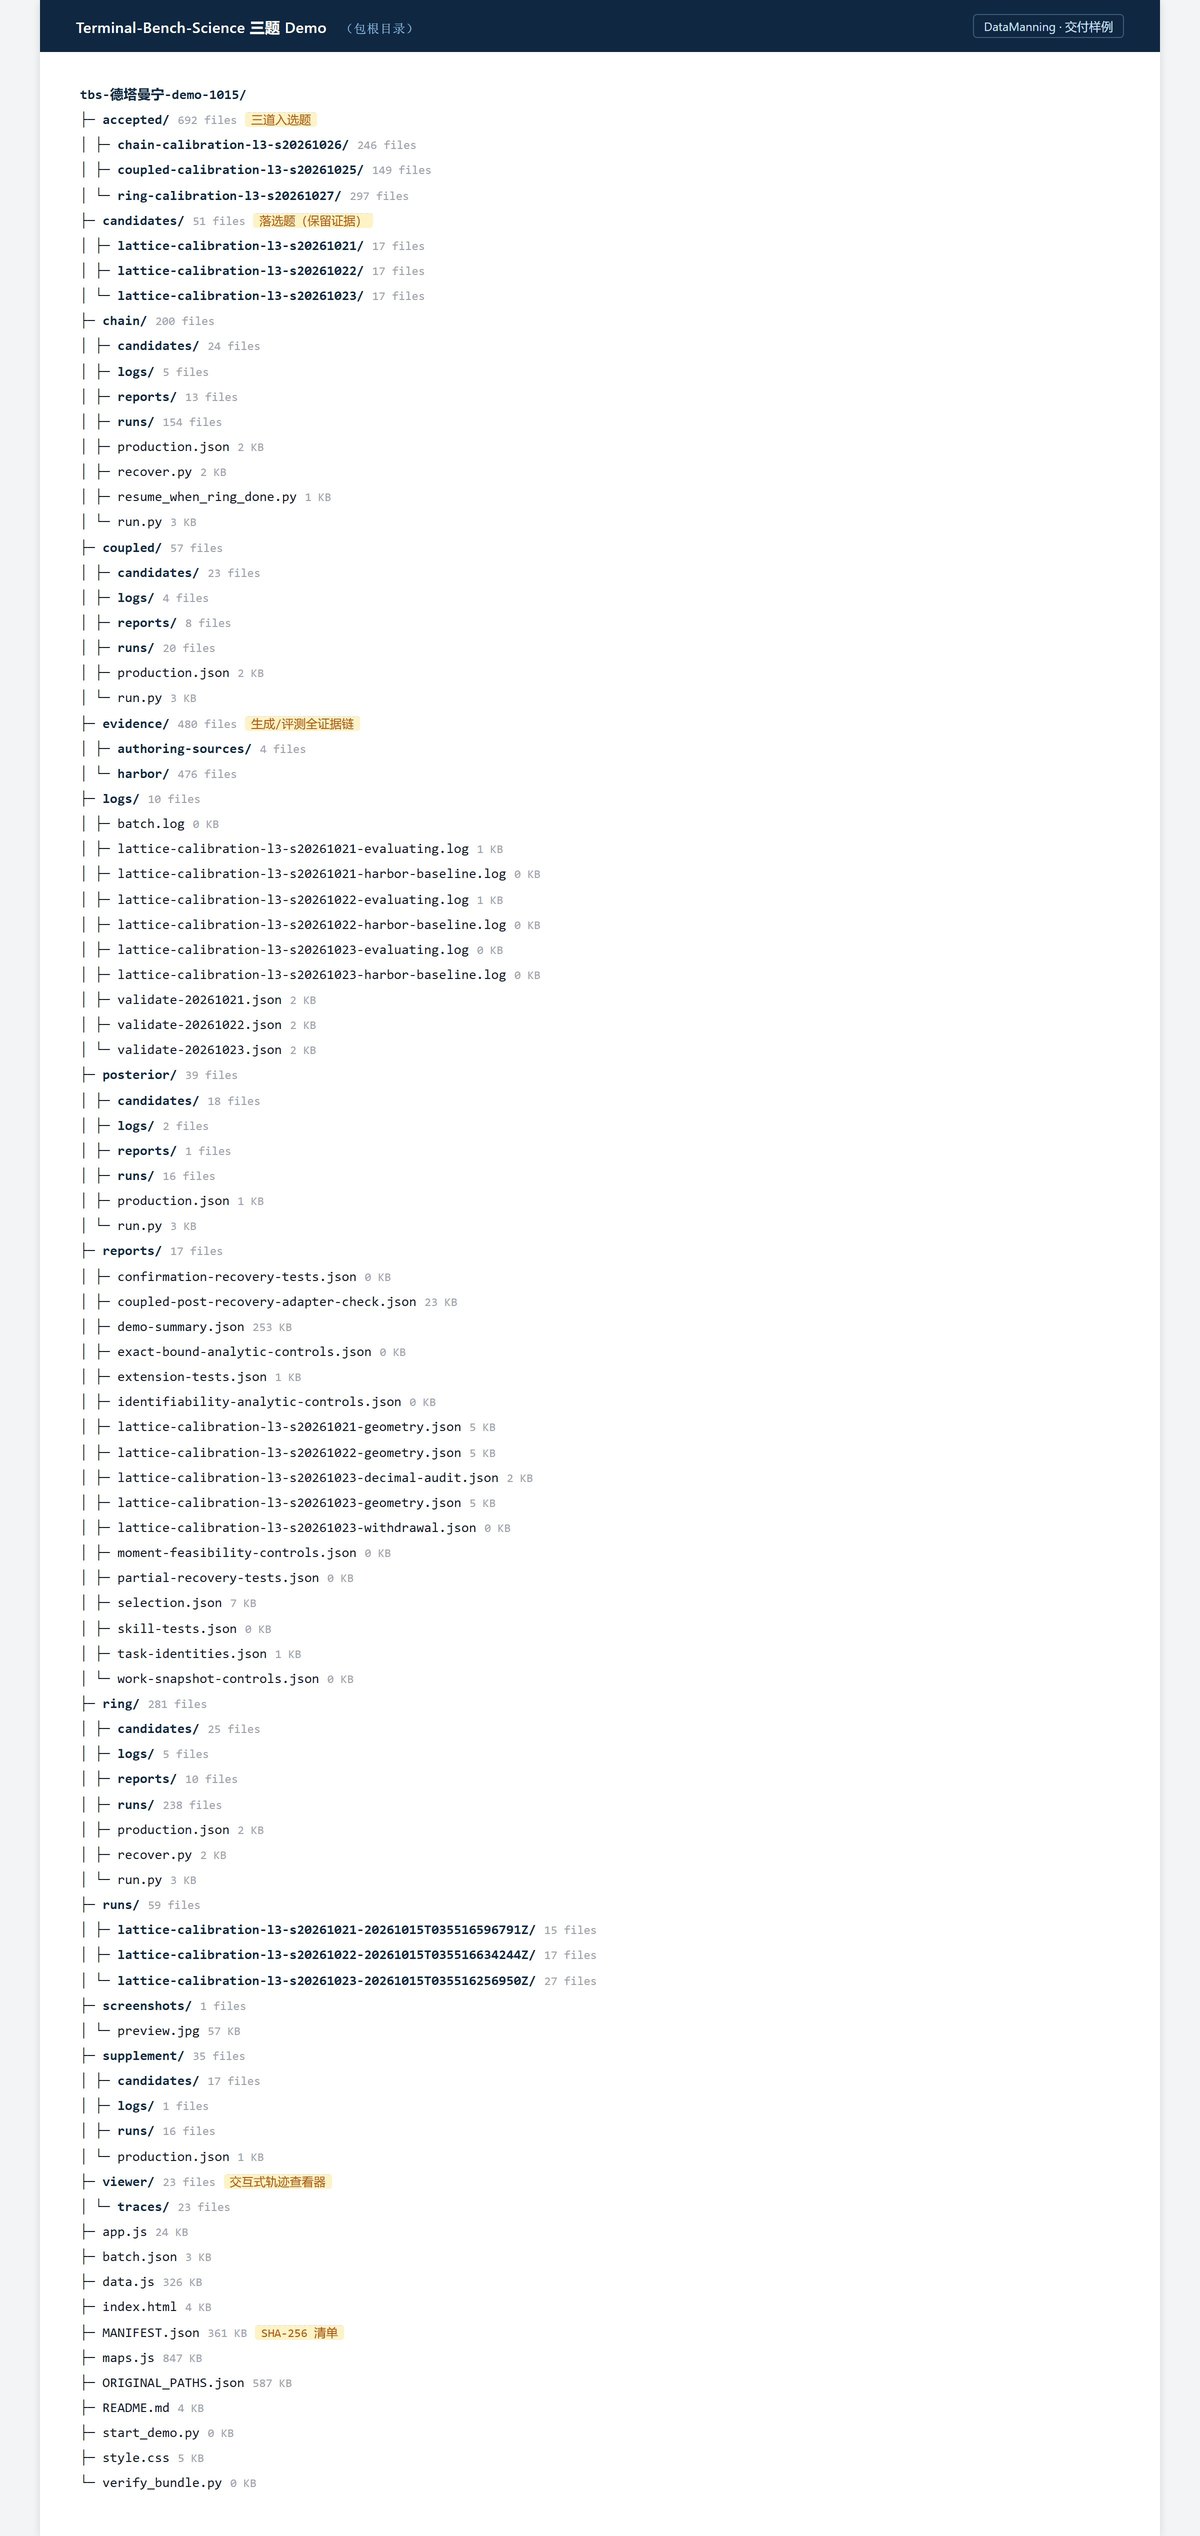
candidates/ 里保留的落选题,以及外层的 SHA-256 清单与 evidence 证据目录;落选题连同试跑证据一起交付,不是删掉了再口头说一句「淘汰了 5 道」)有了这 5 次记录,这道题的难度才立得住。交付报告里写判定结论时,必须带一句:仅在记录在案的模型、工具与预算下失败,不代表普遍无能。如果像回滚机制那样把这些耗尽记录清掉,只留一句 Pass@5=0,买方没法判断是题目本身无解,还是模型刚好卡在 token 预算上。
第二件,写断言的时候看清模型怎么走偏。
检测器能算出「最早偏离步」,前提是它手里有残差和跑偏的轨迹。出题人写验证脚本最怕闭门造车。模型在 70 次终端调用里到底哪一步配错了环境变量、哪一步读错了文件格式,全写在死掉的后缀里。采集工具要是在运行期自动把后缀抹掉、退回快照重跑,交到研发手里就是一条一步没走错的完美轨迹。盲区被掩盖了,后面想加固验证器、设计防作弊断言,连靶子都找不到。
第三件,采购方验收时复算。
数据采购最怕报喜不报忧。供应商说这批任务跑过高强度测试,交上来只有几百条成功轨迹。到底是真只跑了几百次,还是跑了几万次挑出这几百条?
所以 Deep SWE 包里必须有 validation.json。5 个任务、33 条历史运行一条不落:哪 27 条有效、哪 6 条保持 null、哪 3 条是空补丁,都对得上。采购方拿到包不用听我们讲故事,跑一遍校验脚本,核对 SHA256SUMS 里的文件哈希,再查 PROVENANCE.md 里的上游 base commit 和官方 grader 哈希。分母多少、分子多少,自己算。
03桌面环境里,初始现场怎么定
说到这儿有人会问:你们自己也交付桌面环境,CUA-Master 在虚拟机里打快照回滚,你们怎么处理?
我们交付过 Windows 与 Ubuntu 两条标准化镜像。规格是写死的:Windows 优先 11 企业版、其次 10 企业版,Ubuntu 优先 24.04、其次 22.04;单镜像 60G,留至少 20G 可用空间;不分片 VMDK,BIOS 启动;文件名按 preview-{system-version}-{app_name_version}-{purpose}-{date} 打包;7 个工作日交付。
这些参数指向同一件事:同规格的镜像要能被复现、被核对。不分片是为了整盘拷贝不出错,固定命名是为了让「这批轨迹跑在哪个环境上」对得上号。镜像里的操作轨迹由真人完成任务产生,记录任务指令、界面状态和操作轨迹。
我们能承诺的就是这些规格和这些记录。中途回滚不在里面。
道理不复杂。买方拿镜像和轨迹回去做离线分析,如果我们在采集时中途回滚、只交最后拼出来的成功分支,那些改了系统缓存和临时文件的失败动作在轨迹里消失了,环境状态对不上。所以我们的交付物里,一个试次就是一次完整的记录。
04留证据要花钱,只留能归因的那部分
把失败现场留下来听着硬核,但作为常年蹲在一线交货的团队,得说句实话:留证据很贵。
CUA-Master 在 (50,8) 这档的成功率是 18.7%。每拿到 1 条成功轨迹,背后要跑五次出头。如果把几十万条废弃分支的完整磁盘快照、高清录屏全存下来打包,存储、传输、脱敏工时和采购方的审计工时,会把项目预算撑爆。所以训练团队在造大规模 SFT 语料时,通常会丢掉错误后缀,这个选择本身没错。
工业交付里的「留」,只留可归因、可复算的那部分。我们卡三条边界。
第一,只留构建配方和初始基线,不存失败后的死镜像。Deep SWE 包里,我们不保存每次运行结束的容器镜像,而是用 PROVENANCE.md 锁死上游 base commit 和官方 grader 哈希,再配外层的 SHA256SUMS。初始镜像是锁死的、补丁和日志是完整的,同一初始仓库、同一 grader 下就能重跑复核。
第二,无效运行留槽位和状态,不删记录。validation.json 里那 6 条 null 和 3 条空补丁标注,占的是元数据级别的开销,但保住了 33 条运行的采样分母,也让剩下 27 条的有效性说得清。
第三,高价值难题只存文本交互、工具调用和计量。tbs 那道题 5 次耗尽,我们留下的是 71 个回合的完整思维链、70 次终端调用的输入输出文本,以及 26.2 万输出 token 的计量。这些是纯文本和结构化 JSON,量不大,但足够让买方的工程师把模型死在哪一步扒清楚。
05买长程数据时,怎么验供应商的失败记录
不管是买 CUA 这类跨应用桌面轨迹,还是买代码、科学计算的长程任务,采购方卡死下面三条,就能把「只交分子不交分母」的水分挤掉。
第一,看交付配置里有没有采样分母。如果 validation.json 或统计表里有效率永远是整齐的 100%,没有一个 null 槽位,没有超时或空补丁标注,那这批数据大概率做过事后清洗。清洗本身不可怕,可怕的是清洗记录不随包交付。签技术协议时直接要求保留所有运行的原始状态,像我们那样,33 条里哪 6 条是 null、哪 3 条是空补丁,必须写进清单。
第二,看候选淘汰池交不交。做高难度评测集或 RL 环境,不可能每道题生下来就卡在模型能力边界上。tbs 8 道候选筛 3 道,4 道被模型解掉,1 道因参考答案漏计撤回,五道全留在包里。如果供应商说题目难度极高,却拿不出任何落选题和试跑记录,这个「高难度」大概率是挑题或者改题面凑出来的。
第三,看失败结论带不带环境与预算边界。脱离预算说「模型做不出来」的报告没有意义。验收时重点查失败试次的日志:有没有写清 80 轮、1800 秒、262,144 输出 token、断网 docker 这些硬参数,有没有统计 71 个回合、70 次终端调用、26.2 万输出 token 的实际消耗,末尾有没有写「仅在记录在案的模型、工具与预算下失败,不代表普遍无能」。
在训练自己的模型时,像 CUA-Master 那样用回滚把 (50,8) 从 0.0% 救到 18.7%,是很漂亮的工程。但在采购和验收外部数据时,请要求供应商把切掉的分支、跑崩的槽位和耗尽的预算留在交付物里。
需要看我们那份带 6 条 null 的 Deep SWE 样例包、带 candidates/ 淘汰池的 tbs 包,或者按 preview-{system-version}-{app_name_version}-{purpose}-{date} 打包的 60G 镜像,联系 contact@datamining.cloud。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据与可执行评测环境,交付可复现的 Rubric 评分准则、独立可启动的 Harbor Task 容器环境与验证器。文中基准均为公开第三方基准,我们只对齐能力要求与难度区间,不复制题目。官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud