没有标准答案,怎么给模型打分?Rubric 从评分细则到稠密奖励
当任务根本没有唯一解,评分细则就不只是阅卷工具。它正在成为后训练里最稀缺的稠密奖励信号——谁先把领域里的隐性专家经验翻译成原子化采分点,谁就能训出真正能干活的 Agent。
前两讲我们分别探讨了 benchmark 的本质(一组不同科目的试卷),以及 分数的来源(由评分规则加工的结果)。
顺着这个逻辑,今天我们往下挖一层,讨论一个在当前大模型后训练(Post-training)和评测中越来越核心,但也更具挑战性的问题:
如果任务根本没有标准答案,我们该如何评分,又该如何训练模型?
当你让模型去写一篇行业研究报告、做一份复杂的医学诊断分析、或者执行一个多步工具调用的 Agent 任务时,这些开放式任务既不是 MMLU 的选择题,也不是 HumanEval 里能通过单元测试的代码。它们没有唯一解,很难用简单的「对」或「错」来衡量。
过去,面对这类任务,业界通常依赖人类偏好对齐(RLHF),或者使用 LLM-as-a-Judge 让大模型裁判打个 1 到 5 分的「整体印象分」。但这带来了一个明显的副作用:模型很容易变成「老好人」,排版工整、语气礼貌、满篇正确的废话,但在核心业务的深度判断上却经不起推敲。
为了打破这个瓶颈,学术界和工业界不约而同地将目光投向了一个概念:Rubric(评分细则/评分量表)。
01什么是 Rubric?为什么现在如此重要?
简单来说,Rubric 就是把一句模糊的「这个回答好不好」,拆解成一组可以逐项检查、相互独立的明确标准。
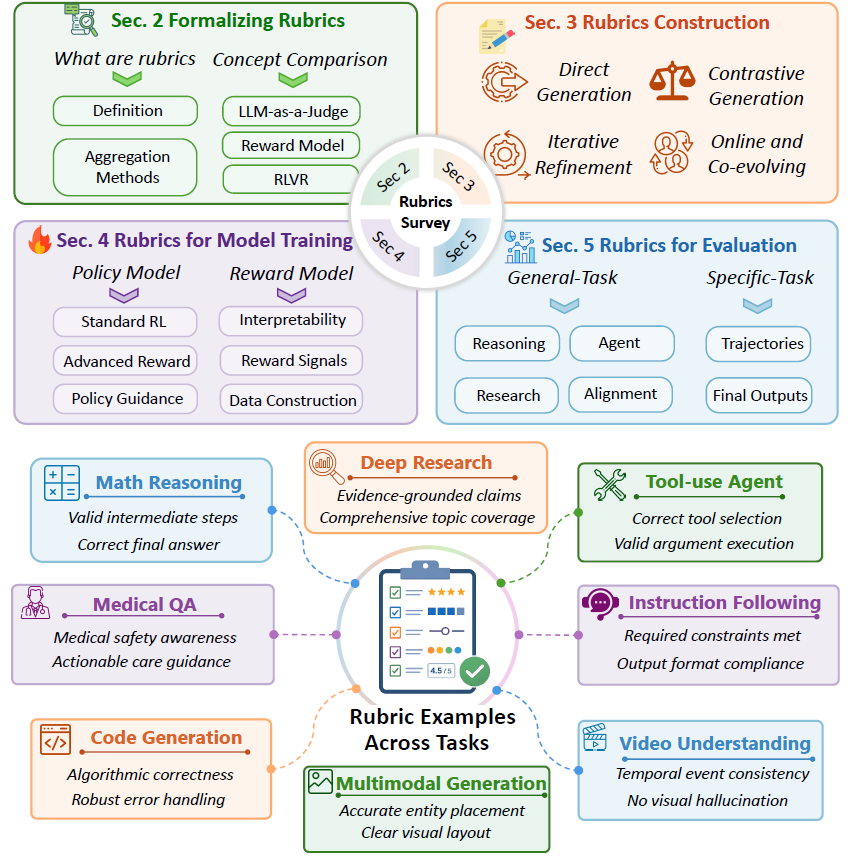
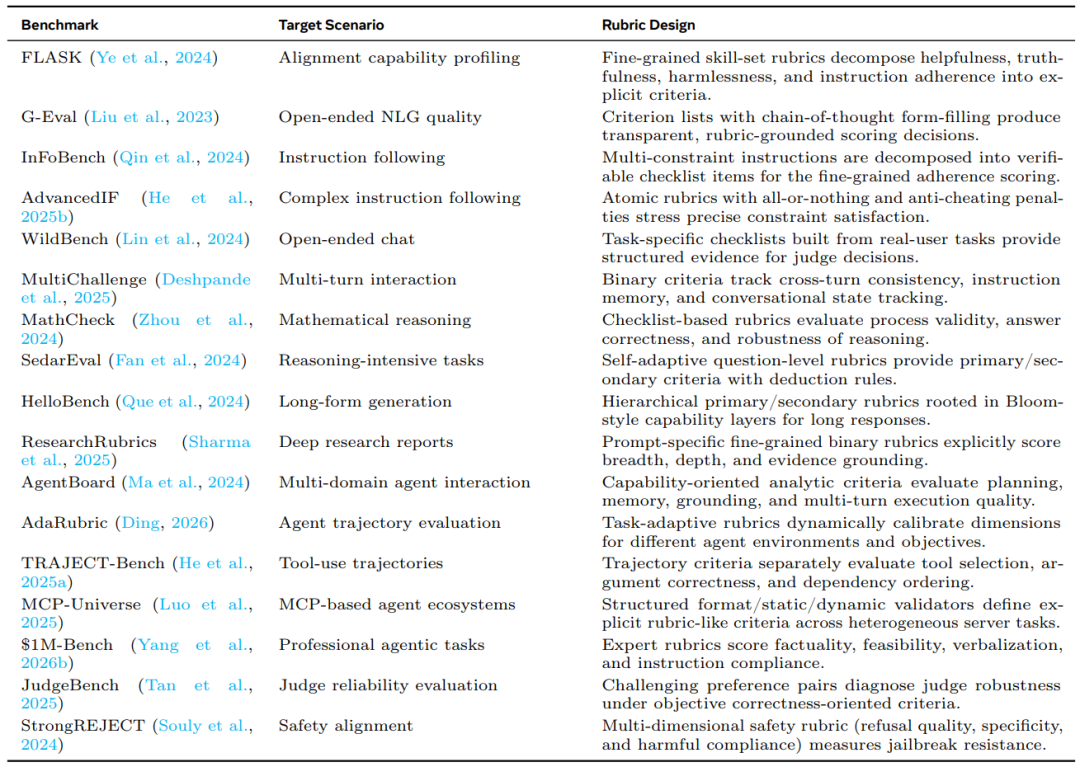
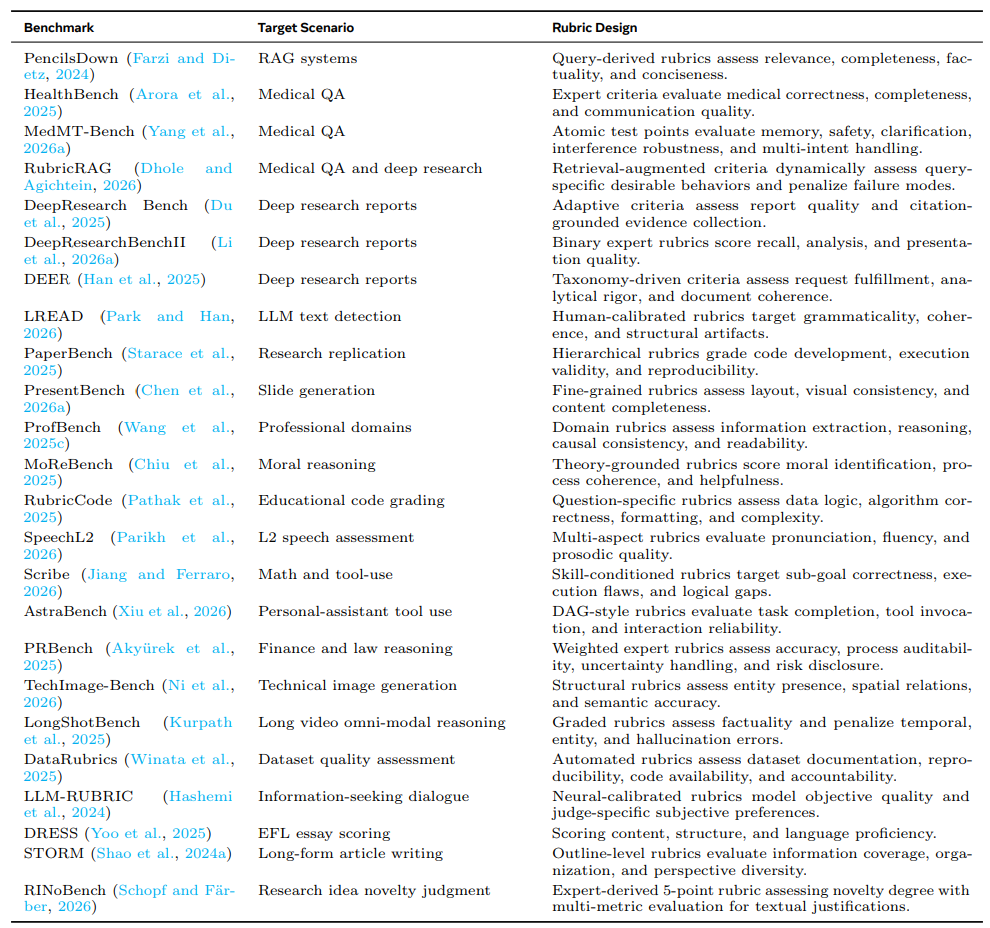
人大团队在近期发布的综述《The Rules of the Game: A Survey of Rubrics for Large Language Models》中指出,随着 LLM 深入推理、决策、工具使用等高风险和长程场景,简单的正确性信号和不受约束的整体偏好分数已经不够用了。Rubric 的价值在于,它能把事实性、完整性、安全性、推理可靠性等隐性的质量标准,显式地表达出来。
「如果说 benchmark 是试卷,metric 是最终的总分,那么 Rubric 就是阅卷老师手里的『评分细则』。它不仅决定了怎么算分,更定义了什么样的回答才算好。」
02产业界的新共识:把 Rubric 作为强化学习的「稠密奖励」
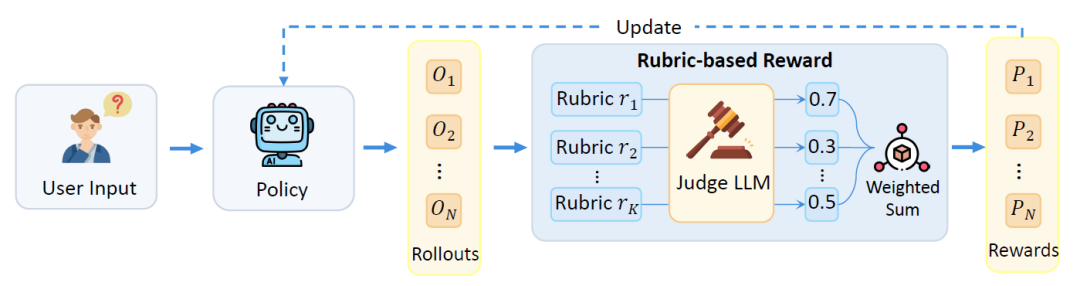
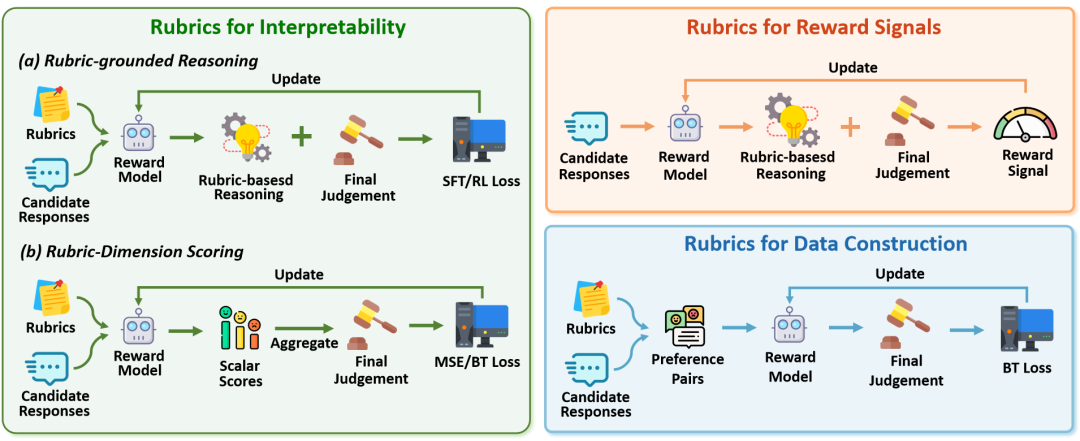
如果你关注近期大模型后训练(尤其是强化学习 RL)的进展,你会发现 Rubric 正在发挥远超「评测工具」的作用——它正在成为非验证领域(Non-Verifiable Domains)中最优质的奖励信号(Reward Signal)。
过去半年,基于可验证奖励(RLVR)的强化学习在数学和代码领域取得了巨大成功,因为做对给 1 分、做错给 0 分的非黑即白信号非常清晰。但现实世界中 90% 的高价值任务(如金融尽调、法律合规、医疗分析)是无法用几行代码断言对错的。
为了让强化学习在这些开放领域也能「刀刀见血」地提升模型能力,大厂和顶尖研究机构开始把人类专家的审稿脑回路,拆解成几十条原子级的 Rubric 检查项:
- 视觉与多步推理:南洋理工大学 S-Lab 团队提出的 V-Rubrics,将复杂的看图推理题拆解为「视觉忠实度(是否准确读取图表数据)」「推理一致性(推导逻辑是否正确)」等原子检查项,作为 GRPO 强化学习管线的奖励信号,显著提升了多模态模型的推理能力。
- 金融与深度搜索:摩根大通联合学术界发表了关于 Expert-Guided Rubrics 的研究,将金融合规检索等意图理解任务拆分为专家级的稠密奖励信号;AI2 开源的 DR Tulu 和清华智谱团队开源的 CaRR,则要求深度研究 Agent 必须将每一条 Rubric 采分点与真实的网页引用证据链死死绑定,以此抑制幻觉。
- 垂直行业落地:以法律 AI 领域的 Harvey LAB 为例,其基准测试背后配套了数万条手写的专业 Rubric,平均每审一份法律文书,后台就有几十把标尺在逐一衡量。
「把人类专家的审稿脑回路,拆成几十条原子级的 Rubric 检查项。」
03一个工业级的 Rubric 是如何设计的?
在日常科普中,我们常说 Rubric 包含评价维度、定义、等级、权重等。但在真实的工业级后训练和严苛的评测基准中,一套能落地的 Rubric 规范要严苛得多。
目前国内头部模厂与数据枢纽在制定专业 Agent 采购规范时,对 Rubric 的设计有着极高的要求:
- 原子化与单一性:一条标准只准查一件事。严禁出现「且」「同时」这种把两个条件绑在一起的连词。比如,不能写「是否准确且完整地回答了问题」,必须拆分为「核心概念是否准确」和「是否覆盖了所有关键子问题」两条独立的检查项。
- 明确的交付物锚点:必须明确标出查的是哪一份交付物文件或哪一个推理步骤,让 Judge 有据可查。
- 正负对冲的奖惩机制:不仅有 +10、+5 的加分项,还必须针对业务「暗礁」设计重罚项。例如在医疗或合规场景中,如果对外脱敏清单里漏遮了一个患者身份证号,或者遗漏了关键的风险提示,直接触发 -10 分甚至一票否决。
- 强制证据链:对于事实性维度,要求模型必须提供可核查的引用来源。无法确认来源的推断,即使逻辑自洽也不能给满分。
这种设计的核心目的,是把模糊的「人类经验」砸碎成颗粒度极细的「原子断言」。只有这样,大模型裁判(LLM Judge)在打分时才不会左右摇摆,强化学习的梯度才能精准地引导模型改进。
「把模糊的人类经验,砸碎成颗粒度极细的原子断言。」
04如何构建高质量的 Rubric?
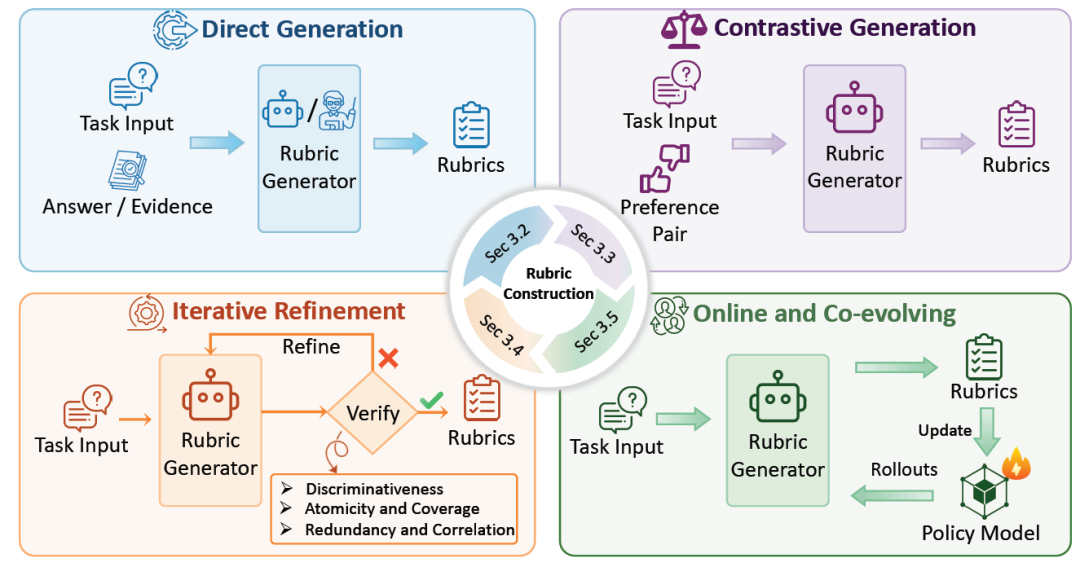
构建一套高区分度的 Rubric 并不容易,直接让大模型「生成一套评分标准」往往会得到一堆泛泛而谈的废话。目前业界主流且有效的构建路线主要有以下几种:
- 对比生成(Contrastive Generation):给模型提供同一问题的「优秀回答」和「劣质回答」,让其总结两者的核心差异。从真实的差异中提取的标准,往往比凭空生成的更具实操性。
- 迭代打补丁(Iterative Refinement):先用初版 Rubric 进行小批量试标,分析 Judge 的打分分布和错误案例。如果发现模型靠堆砌字数拿高分,就加入「不因长度加分,只查新增有效信息」的规则;如果发现模型编造引用,就加入「引用必须可核查」的硬性约束。
- 动态演化(Dynamic Co-evolution):模型在训练过程中是会「钻规则空子」的(Reward Hacking)。当模型学会了表面满足 Rubric 却没有真正提高质量时,Rubric 也需要像 AI2 的 DR Tulu 那样,随着模型能力的暴露而动态更新,持续堵住漏洞。
05总结:从「找题」到「定标准」的范式转移
大模型越深入真实的业务场景,我们越能体会到:真实世界里的「好」,从来不是单一维度的。一个回答可以事实正确但不完整,可以表达流畅但证据薄弱,可以结论有用但风险提示不足。
Rubric 的意义,就是把这些复杂的差异显式地写出来。它让我们从一句模糊的「这个模型回答挺好」,走向更可讨论、可追溯的「它事实性好,结构清楚,但证据支撑不足,安全边界没讲够」。
后训练与评测的下半场,竞争的核心正在发生转移:过去大家比拼的是谁能搜刮到更多带有标准答案的数学和代码题;而现在,谁能率先把自己业务领域的「隐性专家经验」,翻译成机器和强化学习听得懂的「原子化采分点」,谁就能在真实商业世界里训出真正能干活的 Agent。
这不仅是评测方法的升级,更是整个行业走向标准化、精细化的一次必经之路。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据与可执行评测环境。我们交付的不只是数据,也包括可复现的 Rubric 评分准则,以及按 Harbor Task 规范封装的独立可启动容器环境与验证器;行业工作流包通常带 35 至 60 条正负对冲的原子级 Rubrics。文中提到的基准均为公开第三方基准,我们只对齐其能力要求与难度区间,不复制题目。官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud
06参考资料
[1] Wenhan Liu, Jiajie Jin, Zhaoheng Huang, Tongyu Wen, Guanting Dong, Ziliang Zhao, Yutao Zhu, Zhicheng Dou, Ji-Rong Wen(中国人民大学高瓴人工智能学院),The Rules of the Game: A Survey of Rubrics for Large Language Models,2026,OpenReview:FnSimngGYk。
[2] Shulin Tian 等(南洋理工大学 S-Lab、A*STAR、UIUC),V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning,EMNLP 2026,arXiv:2608.25580。
[3] Ashish Bansal 等(J.P. Morgan),Expert-Guided Rubrics as Dense Reward Signals for Reinforcement Learning in Non-Verifiable Domains,RL4LLM-Agents @ ICAIF 2026,arXiv:2610.26932。
[4] Ai2,DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research,arXiv:2511.19399。
[5] Jiajie Zhang 等(清华大学 THUDM、智谱 AI),Chaining the Evidence: Robust Reinforcement Learning for Deep Search Agents with Citation-Aware Rubric Rewards(CaRR),arXiv:2601.06021。
[6] Harvey,Introducing Harvey's Legal Agent Benchmark (LAB),2026(1,250 个任务、24 个业务领域、超过 75,000 条专家手写的 Rubric 标准)。