讲透 Benchmark,警惕「刷榜陷阱」:为什么大模型没有通用智商表
在讨论大模型时,很多人习惯把各大机构的榜单当成「智商排行榜」。但大模型从来不存在一张能测出「绝对智商」的试卷。它不是全能学霸,而是一个由不同科目试卷拼出来的极度偏科生。
谁排在第一,谁就是全网最聪明的大脑;谁掉出了前三,谁好像就成了「人工智障」。
但如果你跟真正做模型后训练、做评测和做业务落地的工程师聊一聊,就会发现一个很普遍的常识误区:大模型评测,从来就不存在一张能测出「绝对综合智商」的万能试卷。
这一讲先不堆公式,用大白话把 Benchmark 是什么、它由哪些科目组成、为什么必须提防「刷榜陷阱」讲清楚。
01为什么大模型没有「通用智商表」
人类社会有智商测试,试图用一个单一数值概括一个人的综合认知水平。但哪怕在人类身上,这种测试也常被质疑无法涵盖情商、创造力和动手能力。
把这套逻辑套到大模型身上,偏差更大。
大模型本质上是基于海量语料训练出来的接话机器和概率预测器。它的能力不像人类小孩那样全面、均匀地成长,而是充满强烈的模块化和不可预测的偏科:
- 它可以通读几千篇专业法学和医学论文,对专业词汇倒背如流;但转头让它算一个简单的三位数减法,或者数一句话里到底有几个字母 r,它可能一本正经地胡说八道。
- 它能写出极其漂亮的 Python 爬虫和异步并发脚本,但如果给它一张稍微复杂点的业务柱状图,它可能连横纵坐标轴的数字都读反。
这就带来一个严重的问题:如果把历史常识、数学题、代码编写和日常闲聊的分数硬算一个平均数,得出「综合 85 分」,这个分数对采购和落地没有参考意义。
一个在文学写作上得 95 分、在代码执行上得 40 分的模型,平均分看起来有近 70 分,但如果你把它招进团队写业务代码,它第二天就会让系统崩溃。
所以业界早就放弃了「一张试卷定终身」的幻想,而是像高考一样,把大模型的评测拆成一组不同科目的独立专业试卷。
02大模型的「高考科目」有哪些
如果要给大模型安排一场全面体检,目前主流的 Benchmark 基本可以划分为四个核心科目。
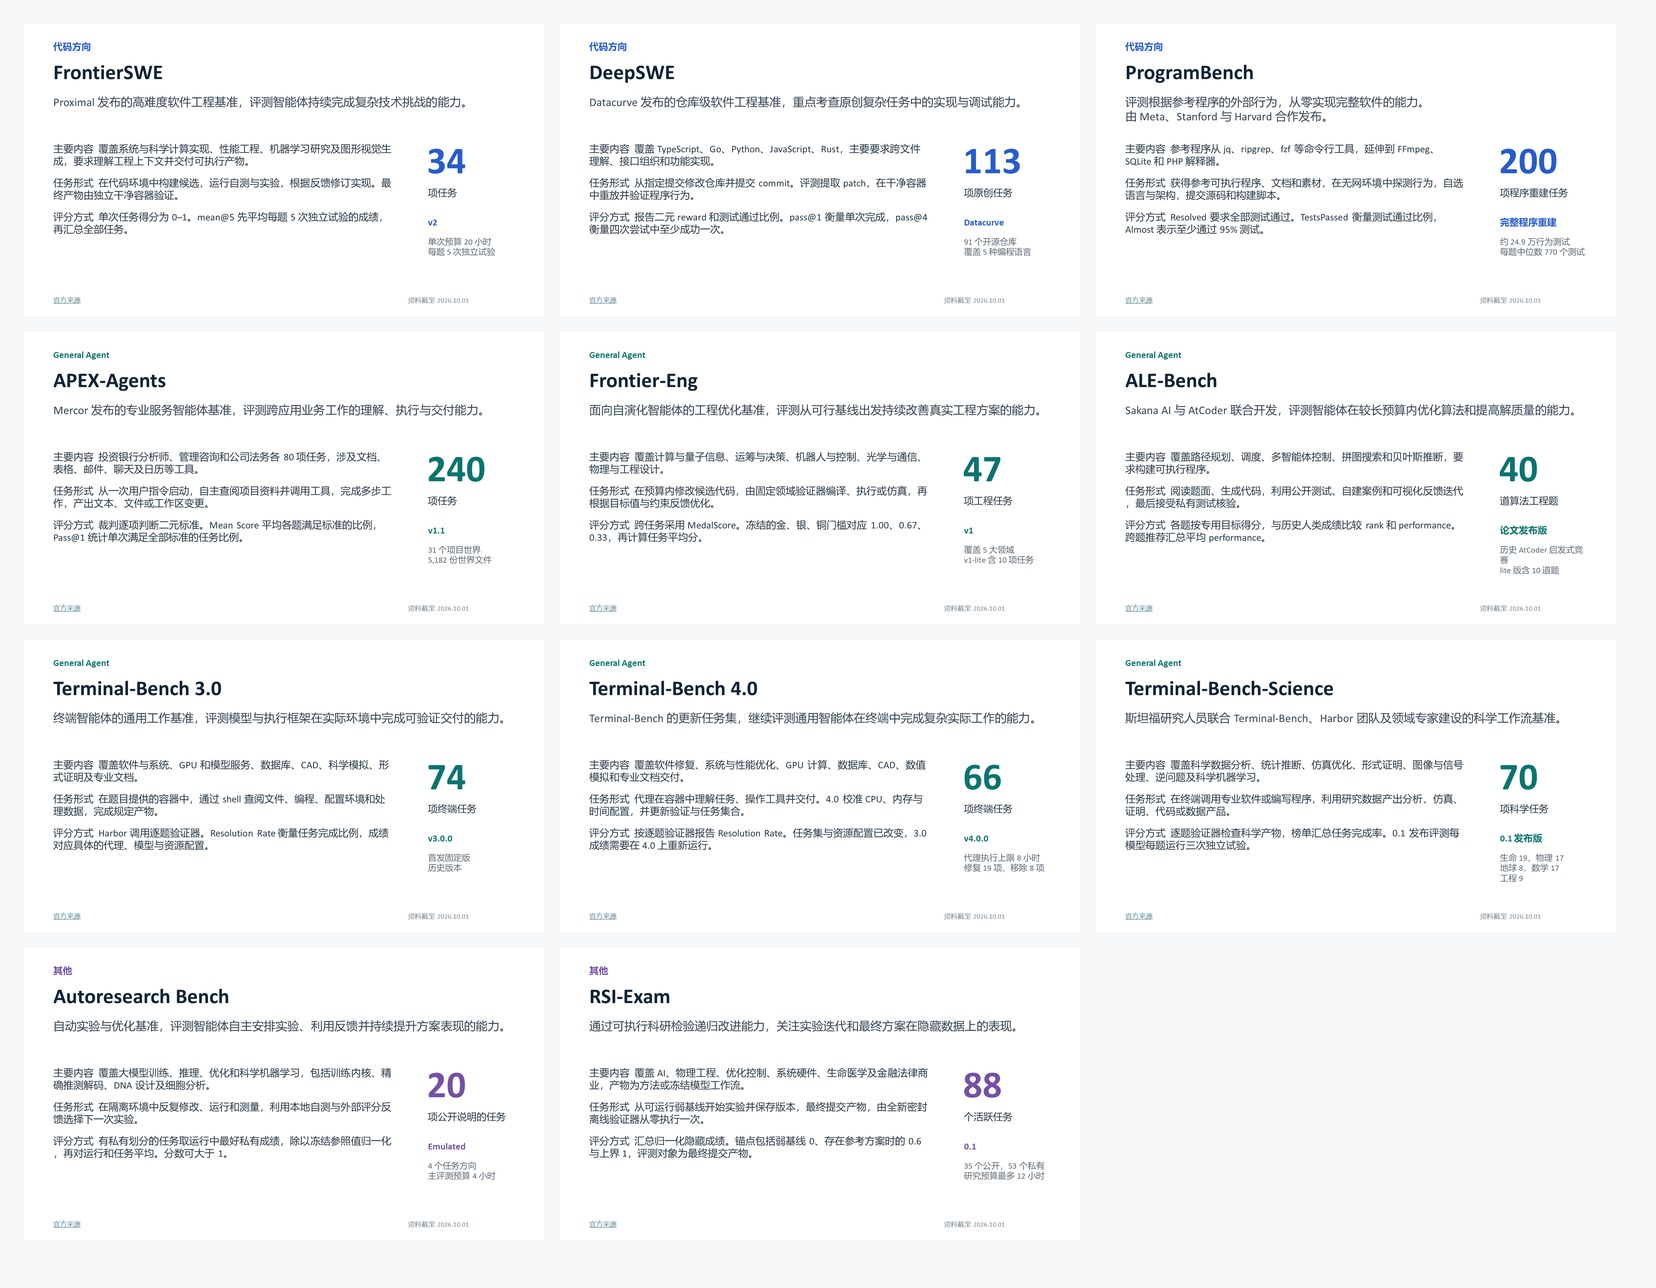
常识与知识记忆:从 MMLU 到 HLE
这相当于大模型的百科知识选择题。
过去几年最出名的是 MMLU(大规模多任务语言理解)。它包含初高中历史、大学化学、专业临床医学、法学等 57 个学科的四选一单选题,主要测模型在预训练时看过了多少书、记住了多少人类常识。
但选择题有个大漏洞:四选一哪怕完全瞎猜,期望得分也有 25 分。而且这套题在网公开源很多年,题目早就被爬进了各种模型的训练集。很多模型在 MMLU 上都能考 85 分甚至 90 分以上,已经快考满分。
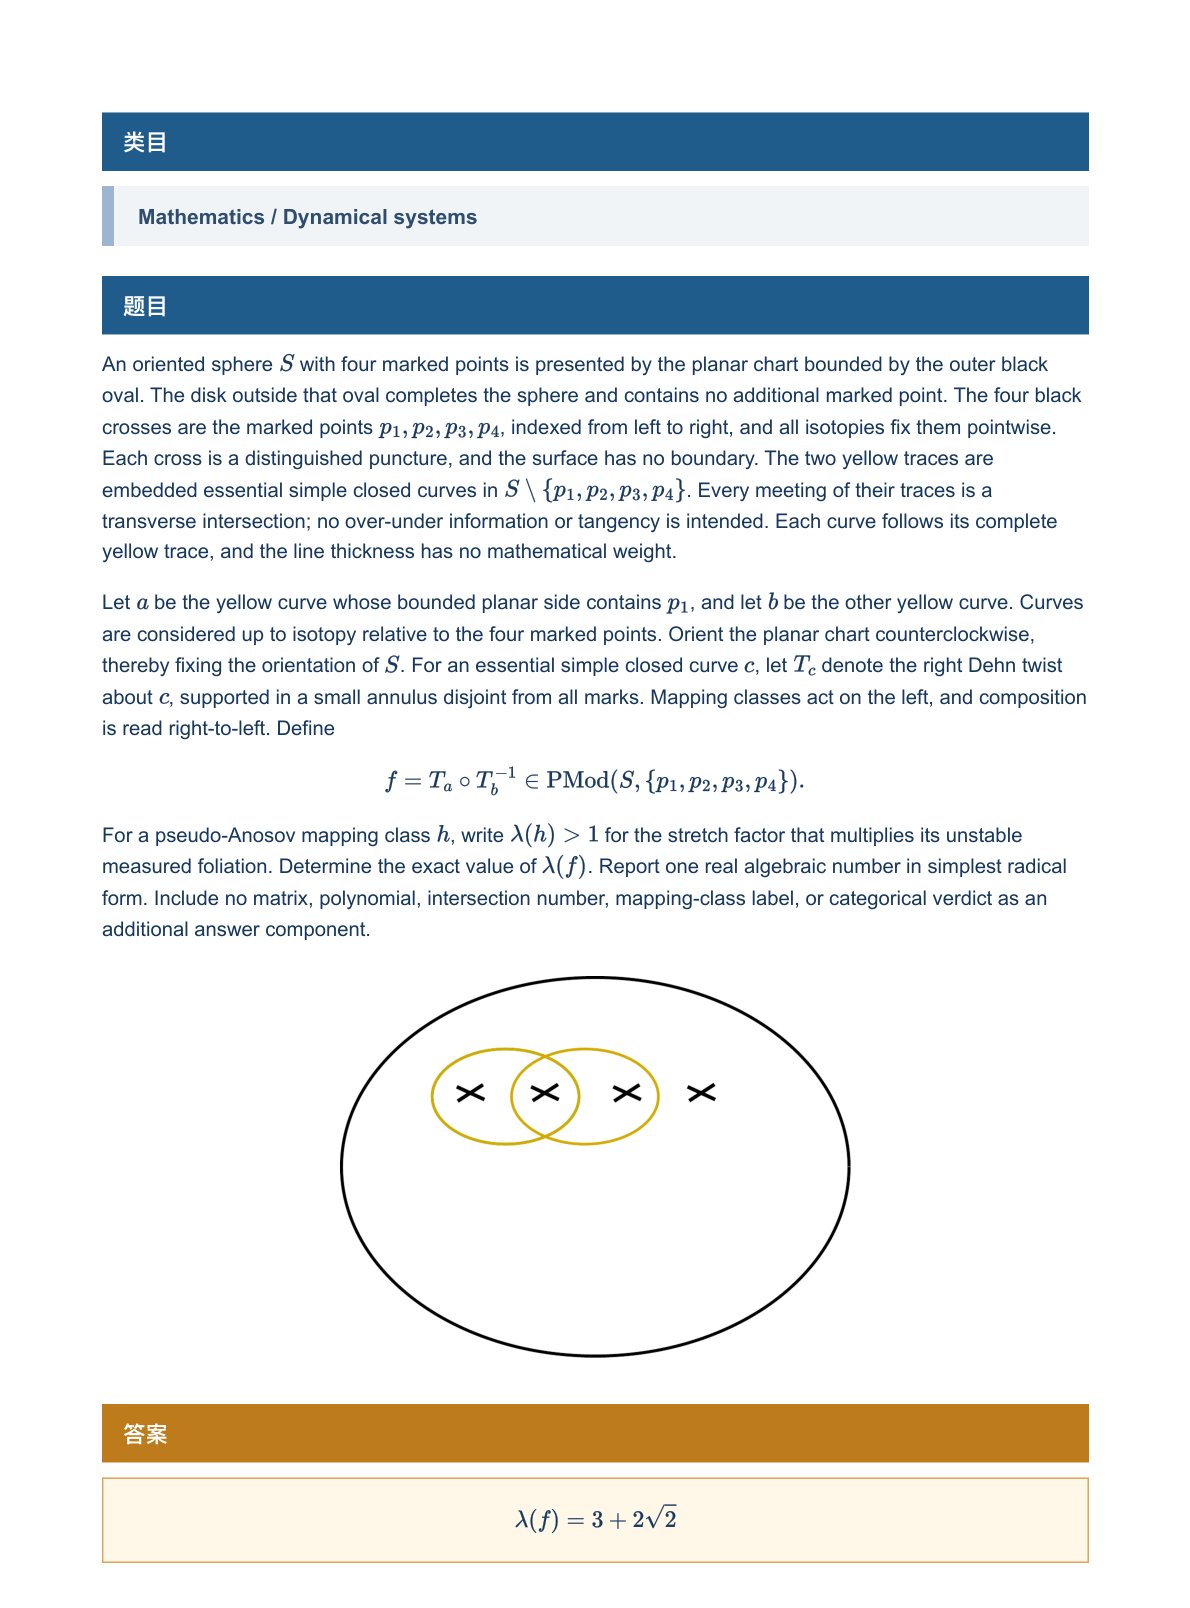
所以后来有了升级版 MMLU-Pro(选项增加到 10 个,猜对概率降到 10%,并加入需要多步推理的题目);现在前沿更关注 Humanity's Last Exam(HLE),这是全球学者出的专业级多模态难题,必须看懂复杂的相图和化学反应机理图才能作答,目前主流大模型在这张试卷上的得分普遍只有 10%~20%。
逻辑与数理推理:从小学应用题到形式化推导
这是检验大模型是否具备慢思考逻辑链条的关键考场。
早期代表是 GSM8K(小学多步算术应用题),用来测模型能不能写出类似「小明买了 3 个苹果、小红吃了 1 个」的完整步骤;进阶版是 MATH 数据集,里面是高中数学竞赛难度的高等代数、微积分和几何题。
在具备长思维链推理能力的模型普及后,GSM8K 几乎被刷到 98% 以上的满分线。现在行业开始用奥数级的 AIME 试题,并且判卷时不再只听模型用自然语言自圆其说,而是用计算机运行的符号系统或代码求解器严格校验推理过程,防止模型推理全胡扯、碰巧蒙对末尾数字。
代码与工程实践:从写函数到进真实仓库修 Bug
以前测代码,最常用的是 HumanEval:给模型一句注释,让它补全一个十几行的独立 Python 函数。但这种题离真实开发太远,现实中哪有脱离项目工程、不带任何依赖环境的独立函数。
所以现代的金标准变成了 SWE-bench 系列。它直接从真实开源项目里抓出真实的 Issue,把整个代码仓库扔给模型,要求模型自己跨文件搜索代码、定位 Bug、改写代码并提交补丁。
系统会跑两组单元测试:原本就通过的测试不能被改坏(Pass-to-Pass),原来失败的 Bug 测试必须修好(Fail-to-Pass)。这样测出来的才是真本事。
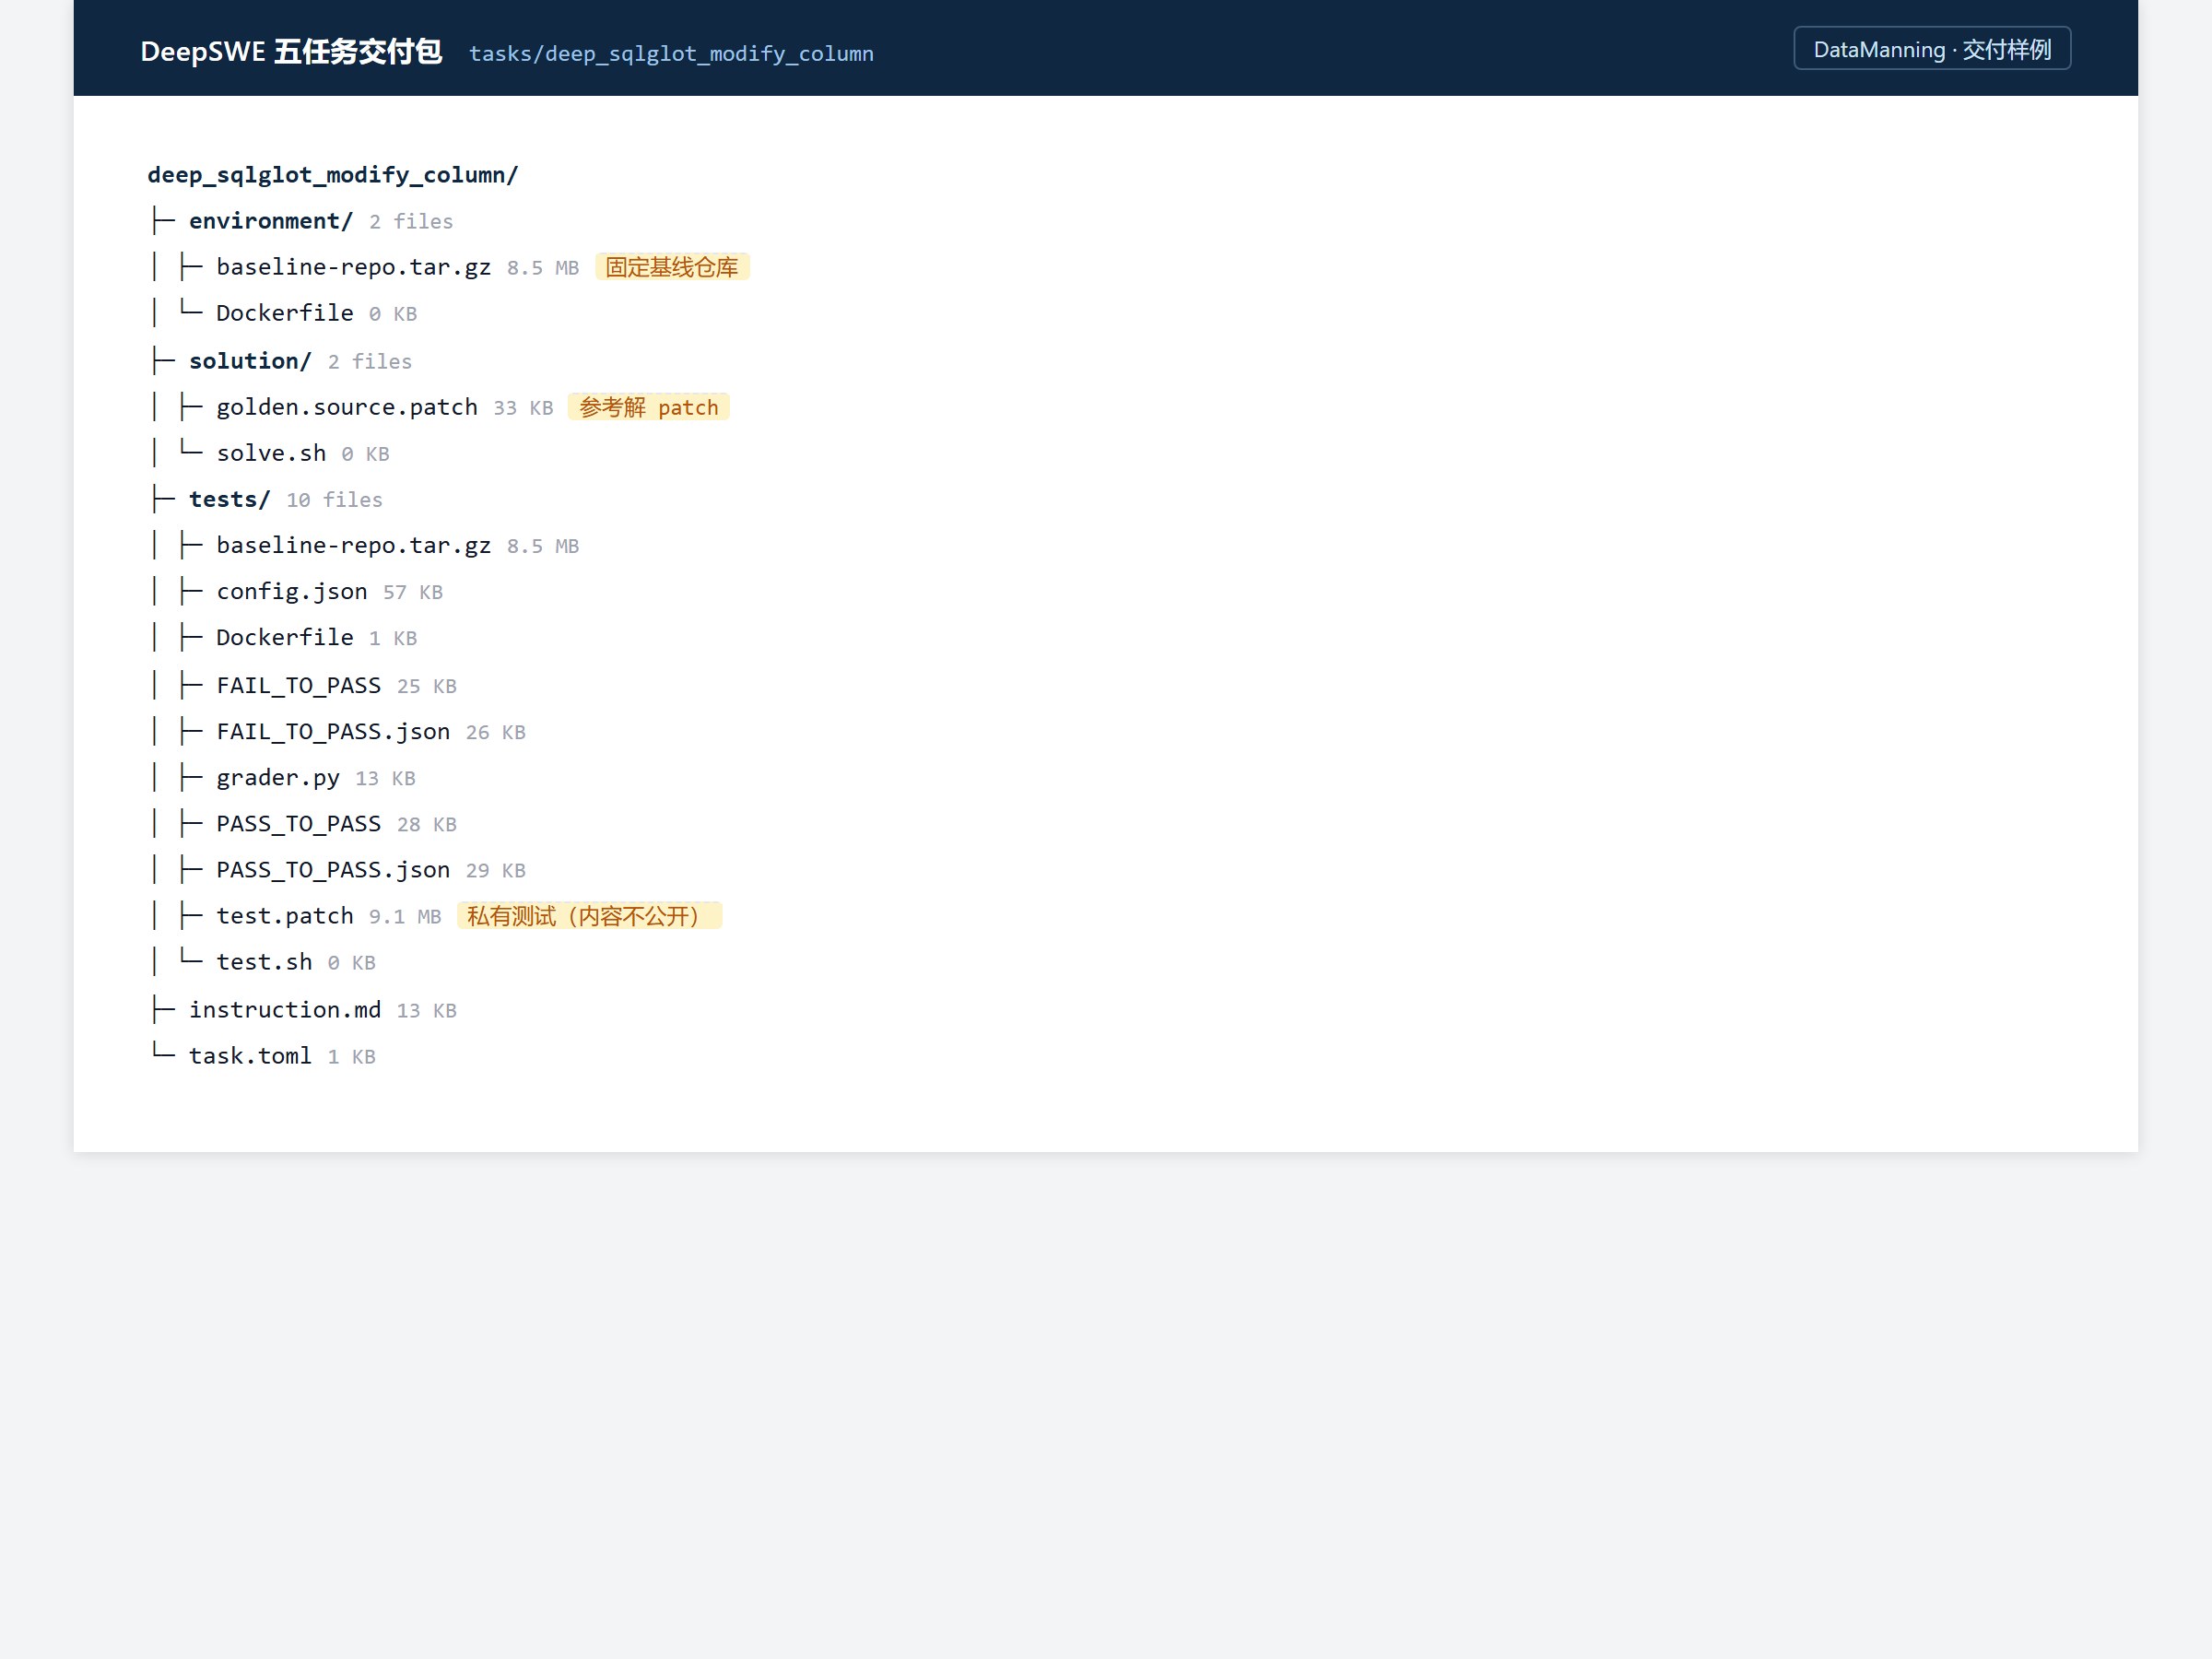
经验之谈:为什么有些模型一进真实工程就熄火。 我们在给头部大厂构建原创代码工程评测集时发现,很多公开基准上的高分模型,一遇到真实未见过的复杂工程沙盒,准确率往往下跌 15 个百分点以上,调试轨迹被拉长 20 轮左右。公开题目的项目结构被模型背过套路;一旦换成完全独立的隔离环境,模型对跨文件符号引用的感知盲区就会彻底暴露。
人类偏好与情商:竞技场与长程智能体
这相当于大模型的面试或综合表现评价。
最经典的代表是 Chatbot Arena。它没有唯一的标准答案,而是盲测:用户输入一个提示词,两个匿名模型同时回答,人类选出更好的那个,再用国际象棋的 Elo 积分算法排出天梯榜。
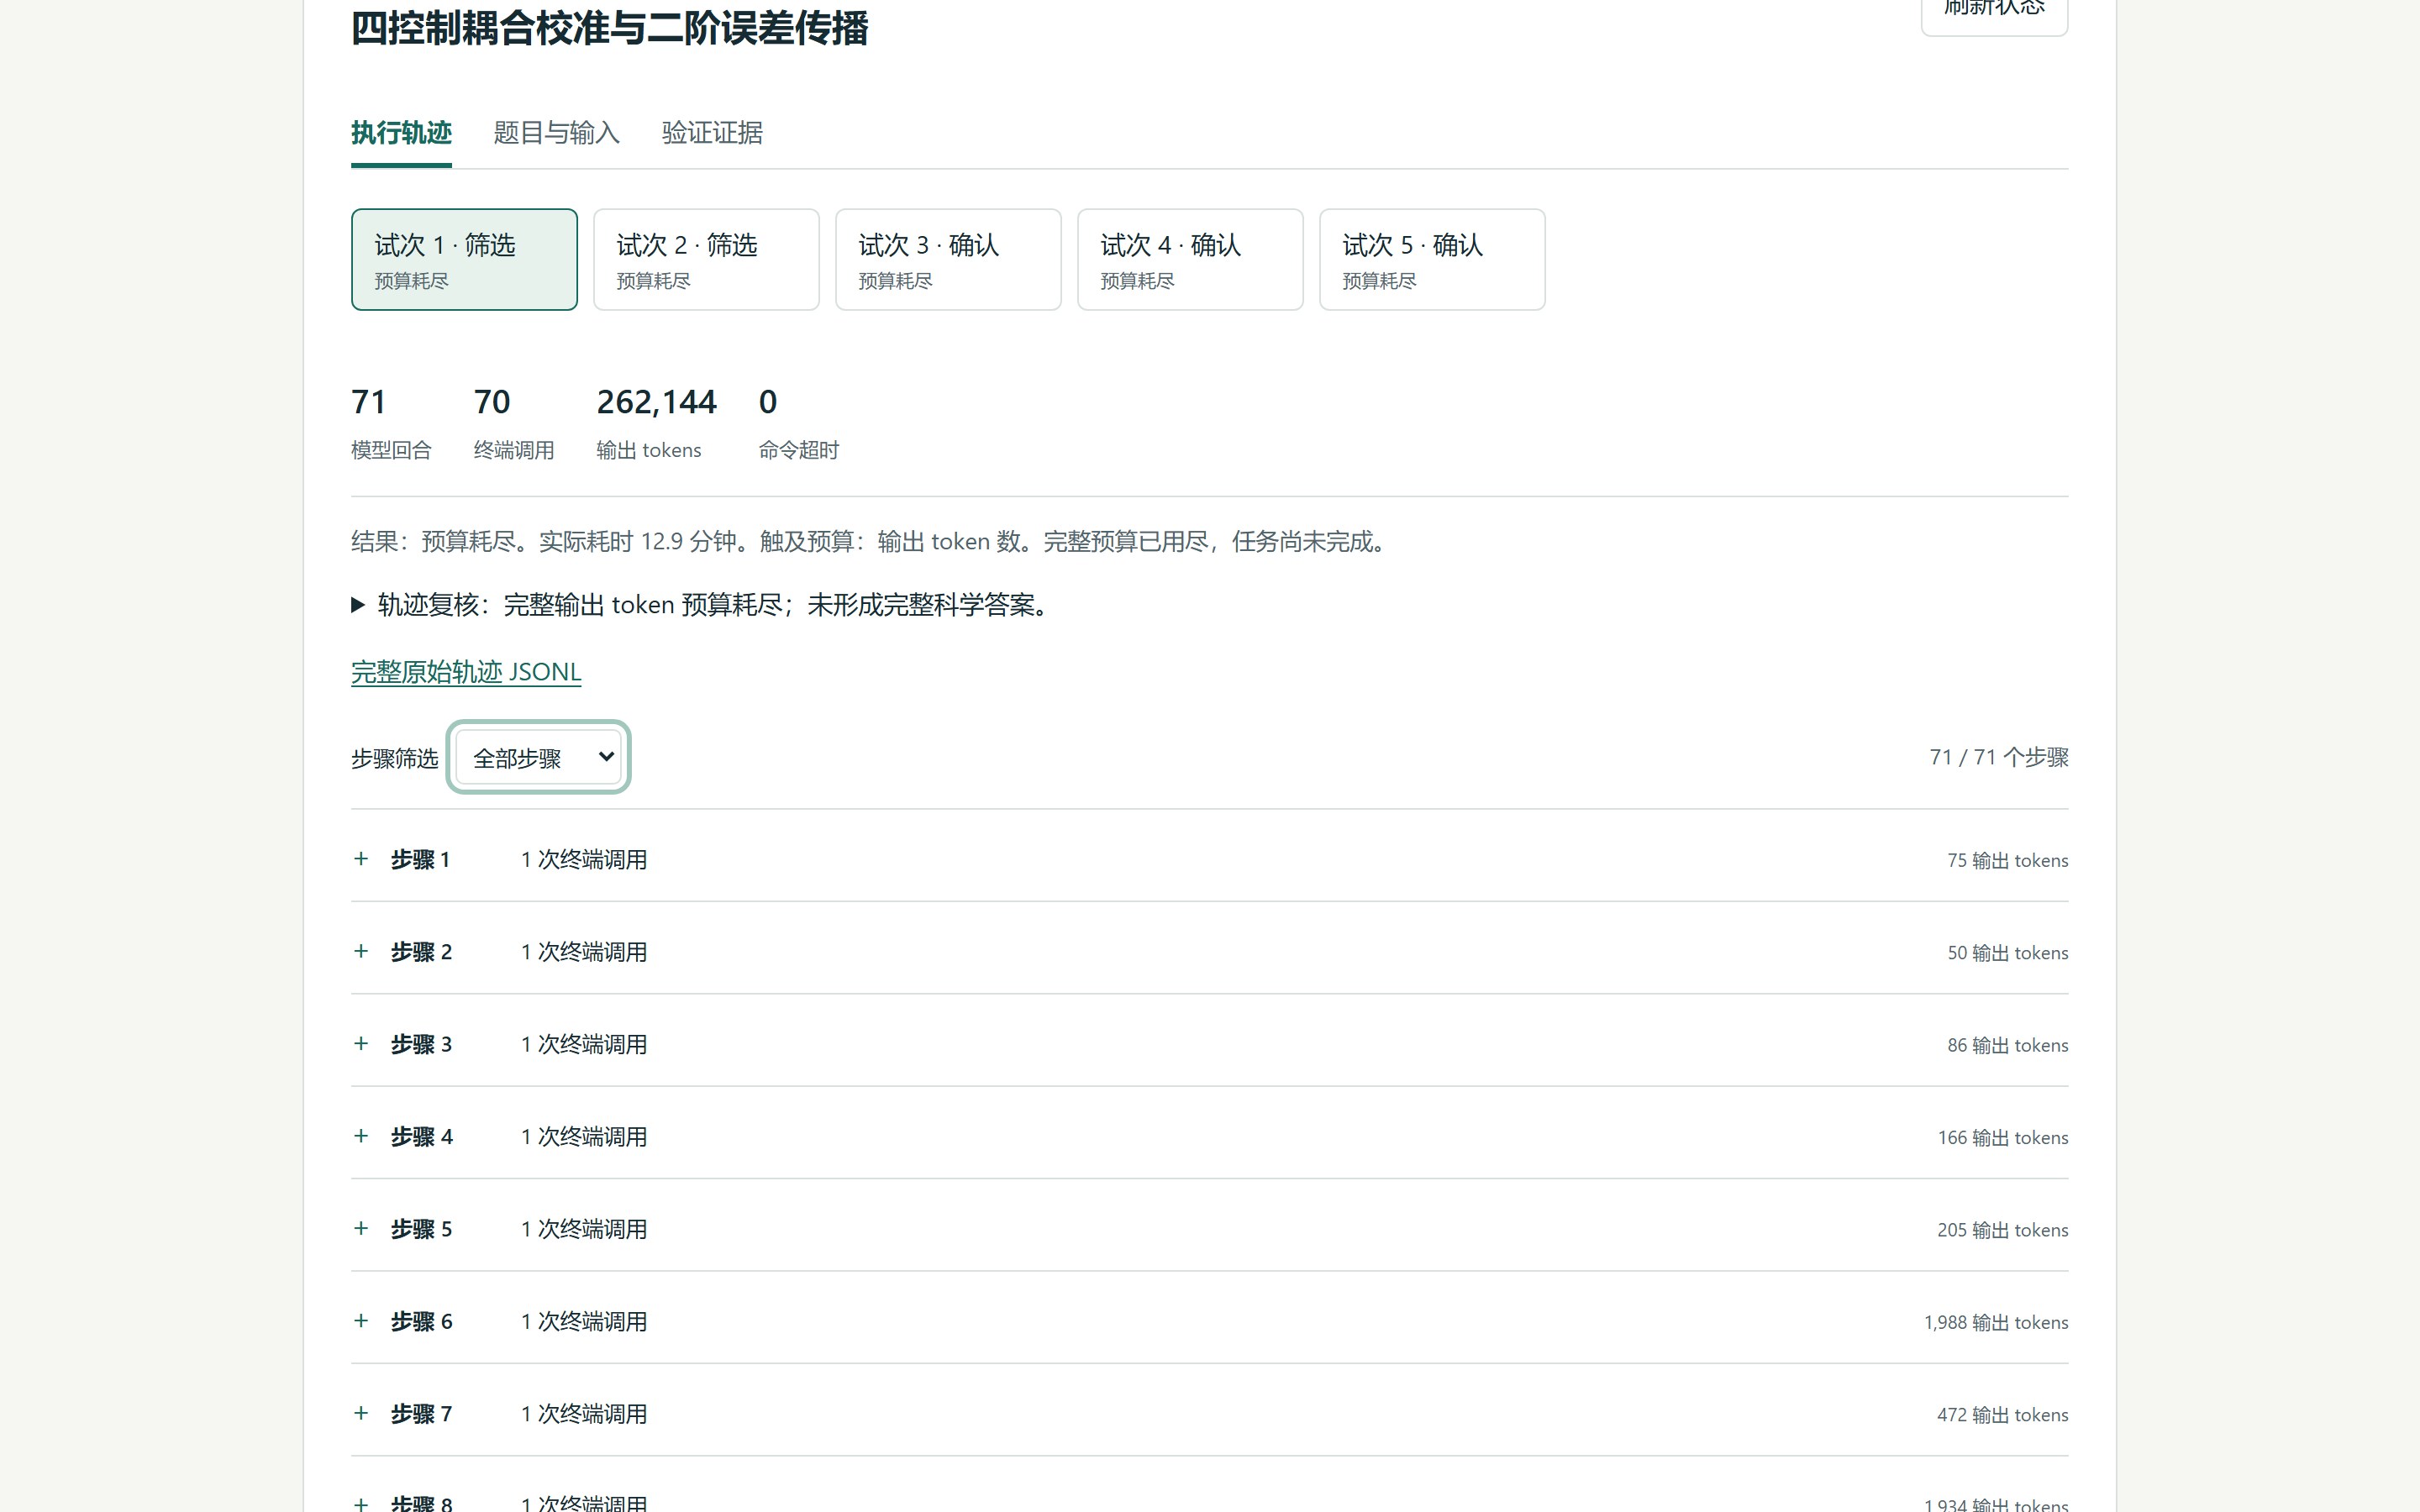
但这种评分机制也有人的弱点:人类非常容易受字数多、格式好看、态度迎合的影响。所以社区后来专门开发了算法去剔除格式带来的虚高加分。更进一步的评测,则直接让智能体进入真实的终端命令行(如 Terminal-Bench)或者办公软件环境,看它能不能一步步把一件长流程工作办妥。
03警惕「刷榜陷阱」:做题家模型与古德哈特定律
经济学里有个著名的古德哈特定律:当一个指标被设定为考核目标时,它就不再是一个好指标。
在大模型行业,这句话体现得淋漓尽致。只要某个公开 Benchmark 变成全行业融资或者发宣传稿的唯一招牌,大家就会使出浑身解数围绕这张试卷定向辅导:
- 直接死记硬背(显式数据污染):公开数据集就在 GitHub 上,有些团队不小心甚至故意把测试集的题目和标准答案清洗进了海量预训练数据池。模型考试时不是现场思考,而是直接调取记忆翻出答案。
- 换汤不换药的刷题(合成数据过拟合):拿现成题库让别的强模型大量改写,换个数字、改个人名、换个变量名再反复喂给模型。模型对特定句式和题型形成极强的肌肉记忆,遇到稍有变动的实际业务场景,解题能力立刻归零。
- 摸透评委喜好(格式迎合):知道自动化评测脚本喜欢某种输出格式,就在系统提示词里写死,分数蹭蹭往上涨,但模型的内在理解能力没有半点实质提升。
结果就是:很多模型在公开榜单上是名列前茅的满分做题家,但一进真实业务,比如帮财务核对一份格式复杂的真实报表,或者在真实系统里查一个冷门的配置错误,立刻漏洞百出。
04总结:怎样看懂一张靠谱的评测
聊了这么多,在平时评估和选择大模型时,该建立怎样的视角?总结起来就是三条大白话常识:
- 不看总分,看单科:永远不要指望一个综合排名能告诉你谁更好用。招文案看语言偏好,招写代码的看 SWE-bench 类真实工程评测,做数据分析看数理逻辑。按真实业务场景对齐具体科目。
- 防范作弊,看环境:一套经得起推敲的评测环境,必须物理断网、环境独立且改卷脚本只读。如果模型能在答题时自己把改卷脚本改了,打出来的分数只是自欺欺人。
- 重视未公开的私有盲测集:公开榜单只能用来做第一轮粗选。真正决定模型能不能上线的,必须是没有任何外部污染、模型训练时从未见过的私有实战试卷。
搞清楚了「大模型考场有哪几门科目」,接下来的问题就顺理成章:这些试卷上的分数到底是怎么算出来的?Pass@1、Pass@k、ELO 积分到底代表什么?遇到没有标准答案的开放式任务,阅卷人又是怎么打分的?下一讲继续:第二讲:分数不是天然存在的,而是由评分规则加工出来的。
关于 DataMining 团队 我们由北京大学计算机学院软件所的博士生团队组建,长期专注于为大模型与智能体研发提供高质量原创任务数据与评测基建,曾为字节跳动、阿里巴巴、腾讯等头部科技企业提供数据服务。 在实际工作中持续构建面向代码工程(Deep SWE / Frontier SWE)、真实环境长程操作(ALE / Terminal-Bench)以及极限数理科学的独立原创评测集与 Docker 防作弊验证环境,帮助企业准确测绘模型边界。 官方网站:datamining.cloud;技术与数据交流:contact@datamining.cloud
05延伸参考
- Hendrycks et al. Measuring Massive Multitask Language Understanding (MMLU). ICLR 2021.
- Wang et al. MMLU-Pro: A More Robust Multi-Task Understanding Benchmark. NeurIPS 2024.
- Jimenez et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR 2024.
- Center for AI Safety & Scale AI. Humanity's Last Exam (HLE). 2025.
- Zheng et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. ICML 2024.