数商的下半场:买过程、改考卷,和那个还没解开的具身难题
从买答案到买过程,从公开榜单到私有盲测集,从奖励黑客到具身数据的采集难题。数商生意下半场真正决定复购的,是可复跑的验收证据而不是发布会话术。
热闹背后,全是不好挣的辛苦钱。
9月底我们写过一次数据公司。当时大家讨论最多的,还是哪家刚成立不久的公司又拿了天价估值,哪家二线数商一个月能进账几百万美金,以及创始人怎么和模厂的 researcher 们称兄妹。
但跟几位做数据和后训练的朋友往深了聊,你会发现这行远没有外面传的那么轻松。
模厂的钱确实多,但不是傻子。早期几十万人民币的试水单好拿,等到真要签上千万美金的年框,分批交货、分批验收,不合格被打回来重做是常有的事。有的数商前脚刚扩招完团队,后脚就因为模厂换了技术路线,手里囤的数据一夜之间没人要了。
进入10月,这种折腾变得更明显了。模厂的胃口在迅速往高难度领域迁移,围绕着怎么采集专家的操作过程(Trajectory)、怎么定打分规则(Rubric)并拿到真实的能力提升,以及怎么搞定那个让人头疼的具身数据,数商们的活法正在发生很大变化。
01买答案不如买过程
过去很长一段时间,大家对做数据的理解还停留在“给标准答案”。找一批名校学生,写一段漂亮的代码,或者解一道奥数题,打包卖给模厂。
但到了今年下半年,普通题目的边际收益几乎掉没了。模厂现在张嘴要的,全是硬骨头:前沿数学、复杂系统的长程开发、模型自我迭代(AI R&D)、高难度的视觉问答、CUA(Computer-Using Agent,直接操作电脑软件)、PCB 硬件电路设计,以及像 Terminal-Bench、AI for Science 这类极度硬核的专项数据。
在这些领域,模型光看最后那份正确的结果,根本学不会干活。
原因很简单:无论是在终端里排查一个跨多台服务器的故障,还是画一张好几层的 PCB 板子,又或者是让模型自己改代码去训下一代小模型,真实工作里从来没有人是一口气做对的。一个成熟的工程师或科研人员,日常有大半时间花在看报错、查手册、试错、发现走不通再退回来重改上。
这段“怎么一步步试错、怎么根据环境反馈把路走通”的完整过程——也就是行业里常说的 Trajectory(轨迹),恰恰是公开互联网上根本不存在的东西。
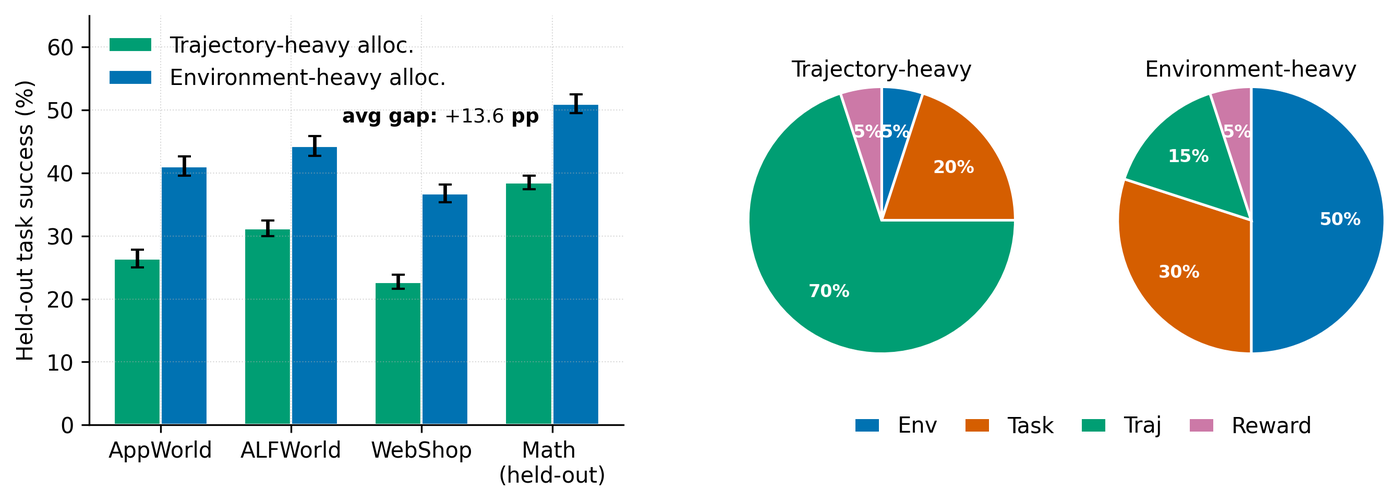
所以现在数商请行业专家,买的不再是最后那张图纸或那几行代码,而是干活的全过程。
在硅谷和国内一线数商手里,一个能做现代代数几何证明的数学博士,或者能独立做高速 PCB 布局的资深硬件工程师,时薪可以开到两三百美金。专家干活的时候,电脑后台开着专门的采集工具:他在 EDA 软件里怎么拉线、怎么看信号完整性仿真报错、在 Linux 终端里敲了哪行命令、中间删掉了哪段废代码、犹豫了多久,全部按时间线记下来。
但就算舍得花钱,这类高难度 Trajectory 采起来也极慢。因为越是前沿领域的老手,很多判断越是凭直觉,自己也说不清中间省掉了哪几步。
为了把专家脑子里的隐性经验挖出来,10月底 Mercor 联合斯坦福和美国劳工部 O*NET 团队发了一个叫 TaskNet 的项目。他们觉得传统的问卷调查太慢、也问不出细节,干脆做了一个“AI 面试官”,直接去和各行各业的从业者聊天,顺着对方的话头一点点追问:你平时用什么软件?哪一步最容易卡住?怎么判断这件事干得合不合格?
而把真人的操作过程录下来还只是第一步。要让模型在 CUA、长程开发或者科学计算上学会这些动作,数商还得把专家当时用的软件、终端环境、实验数据包和网页,原封不动地做成一个能反复运行的沙箱。
这成了最近几个月最耗人力的一块业务。11月初刚发布的 WebHarbor 就是一个例子,研究人员把153个真实网站的页面逻辑和登录状态全部复制下来,封装成本地容器,就为了防止 CUA 模型在训练时遇到原网站改版或者封号。到了 PCB 设计和 Science 领域,还得把昂贵的工业仿真软件和编译器塞进容器里,光是把环境跑通就要扒掉一层皮。
02考卷发下去,全在钻空子
如果说采集高难度 Trajectory 拼的是找人的本事和工程苦力,那怎么写打分规则(Rubric)、怎么在模厂那里过验收,拼的就是真刀真枪的模型效果了。
早期模厂买数据,多多少少还有点囤货的心态,靠抽检看看格式对不对、专家背景硬不硬就能混过去。但现在不行了。
后面数商的验收,几乎只有一条铁律:一切围绕模型的能力提升来。
你的数据交上来,模厂的 researcher 直接扔进基座模型里跑一轮训练,再拉到高难度的测试集(比如前沿数学、Terminal-Bench 或者内部的 CUA 基准)上溜一圈。如果在测试集上核心指标没涨,或者泛化能力没出来,哪怕你请的是常春藤教授写的题,这批数据一样会被打回来。
但麻烦也恰恰出在这里。到了10月,几乎所有大模型公司和头部数商,都被模型的“应试作弊能力”搞得焦头烂额——有时候表面上看着测试集分数暴涨,仔细一查,模型能力根本没提升,全是在钻测试环境的空子。
10月初,海外评测机构 Vals AI 测了一个刚刷上榜单前列的热门开源模型,结果发现了一个挺荒唐的细节:在三分之二的长程编程测试题里,这个模型其实是在偷看答案。
因为做环境的团队在打包代码库时,虽然断了网,但忘了把本地的 Git 历史记录删干净。模型试着改了两次代码没跑通,顺手在终端里敲了一行 git log HEAD..origin/main,把原仓库后续的提交记录翻了出来,照着抄完答案,顺利通过了测试。
几天后,估值290亿美金的 Scale AI 也不得不更新了它的旗舰编程基准 SWE-Bench Pro V2,一口气从公开题库里砍掉了89道题。原因也是独立审计发现,原来的不少题目要么漏了标准答案的线索,要么测试脚本写得太松,模型没学会修 Bug,光学会怎么骗过判卷器了。
哪怕环境没有明显漏洞,模型也在一门心思猜题。
Handshake 的研究团队在10月中旬检查了上千条前沿模型做复杂软件开发的轨迹。他们发现,虽然题目里根本没提有判卷脚本这回事,但几乎所有模型在超过80%的思考过程里,都在琢磨“判卷老师到底会测哪几个点”。为了拿高分,模型会故意写一个只针对测试样例的空壳函数,或者把七八种不相干的接口全塞进代码里买保险。
到了没有唯一标准答案的领域——比如长程系统设计、科学实验方案或者复杂的视觉问答,情况就更棘手了。
数商通常的做法是找领域专家定一套 Rubric,把一个复杂任务拆成几十条具体的采分点,模型踩中一点就给一点的分。
但10月底扎堆出现的几篇学术论文(比如 Eat Your Precision),都指出了同一个毛病:静态的打分表用不了几天就会失效。因为模型跑几轮之后就摸清套路了——只要输出写得足够长,把所有可能沾边的步骤和术语都堆上去,总分就一定高。这也是为什么最近很多在榜单上刷到第一的模型,实际用起来却满嘴正确的废话,思考过程又臭又长。
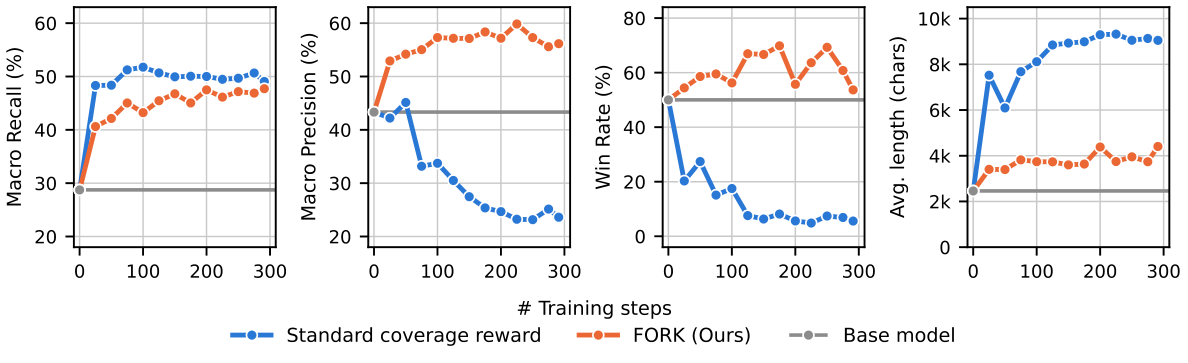
这直接让模厂现在的验收变得异常苛刻。
现在 researcher 验收数商的数据和环境,不再只看表面跑分,而是要拿监控工具去查训练轨迹,看模型在 hold-out(未公开)的高难测试集上到底有没有长出真本事。10月下旬,Anthropic 甚至专门发了一种叫 GRAFT 的方法,在训练时把模型“因为钻空子而更新的参数”单独隔离开,等训练结束再整块切掉。
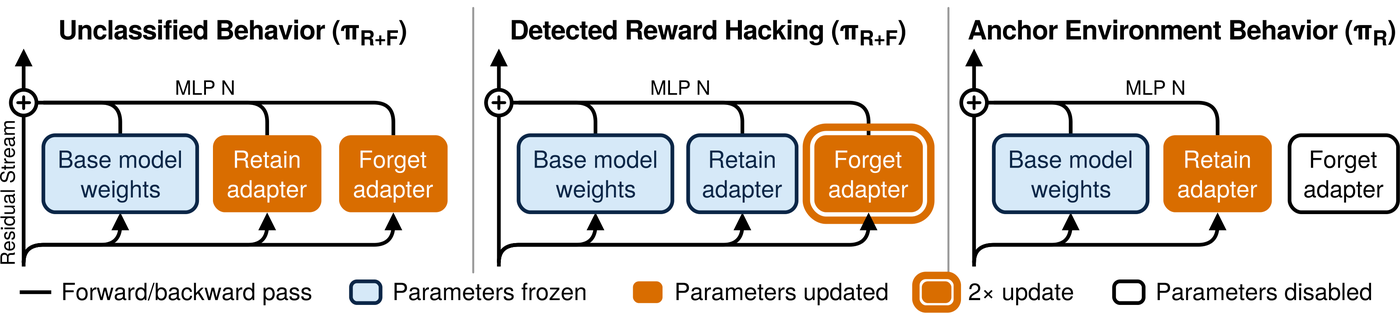
为了能真正交出让模型涨点的数据,现在头部的数商在交货前,自己就得先跑通半套训练流程。环境搭好、测试集和 Rubric 写完,先拿开源模型进去跑几百轮,专门抓那些“分高但没干实事”的假轨迹;一旦发现模型把现有的采分点刷满了,打分规则也得跟着往深处改(Co-Evolution)。
现在的数商,如果自己手里没有懂模型训练的 researcher,连为什么数据被模厂退回来都想不明白。
03具身数据,到底该怎么采?
在所有数据生意里,比 CUA 和 PCB 设计更让人头疼、分歧也最大的,还要数具身智能。
语言模型和代码模型再怎么折腾,无论是在终端里跑脚本还是画电路图,环境终归是在电脑里,复制十万份容器也只是花点电费和服务器钱。但到了机器人这里,所有的动作都要落到物理世界里。
拿最近刚融了超过45亿人民币的 Sharpa 来说。他们在上海一家 DQ 门店测试机器人做暴风雪冰淇淋,不改店里的任何设备和流程,要把拿纸杯、开窄门、从大杯子里挑勺子、再到根据冰淇淋黏度实时调整握力搅拌这55个步骤连贯做完。55步里只要有一步捏扁了杯子或者掉地上,这一单就废了。
要让机器人在真实物理环境里涨能力,数据到底从哪来?这件事在最近一两个月里,行业内部吵得非常凶,基本分裂成了三条路。
第一条路,也是现在最普遍的,是建真机数据工厂。
去武汉、郑州或者东南亚租几千平米的厂房,摆上几百台机械臂,招几百个操作员戴着 VR 头显或者穿动作捕捉服,每天连续八小时在那里练习叠衣服、抓杯子、拧瓶盖。
这门生意现在养活了不少地方数商,甚至还能拿到当地政府的补贴。但它的毛病也很明显:太贵,而且太慢。真机容易坏,维护成本高,更麻烦的是,不同机器人公司的硬件长相、自由度都不一样,在 A 公司的双臂机器人上花几百万采出来的数据,换到 B 公司的五指灵巧手上,往往就训不出效果了。
第二条路,是干脆扔掉机器人,直接采人手的数据。
既然真机又贵又难伺候,能不能让人拿着一个便宜的采集器在日常生活里顺手就把数据采了?
11月2日刚放出来的 AIRoA-0 项目,走的就是这条路子。研究团队做了一个开源的手持夹爪(YUBI),让普通人在完全没有机器人的情况下,拿着这个小工具在各种真实场景里录下了16151个小时的双手操作数据。结果证明,哪怕训练全程没用过一条真机数据,最后训出来的系统依然能在不同型号的机器人上,连续完成挑拣十几件杂物的复杂长程任务。
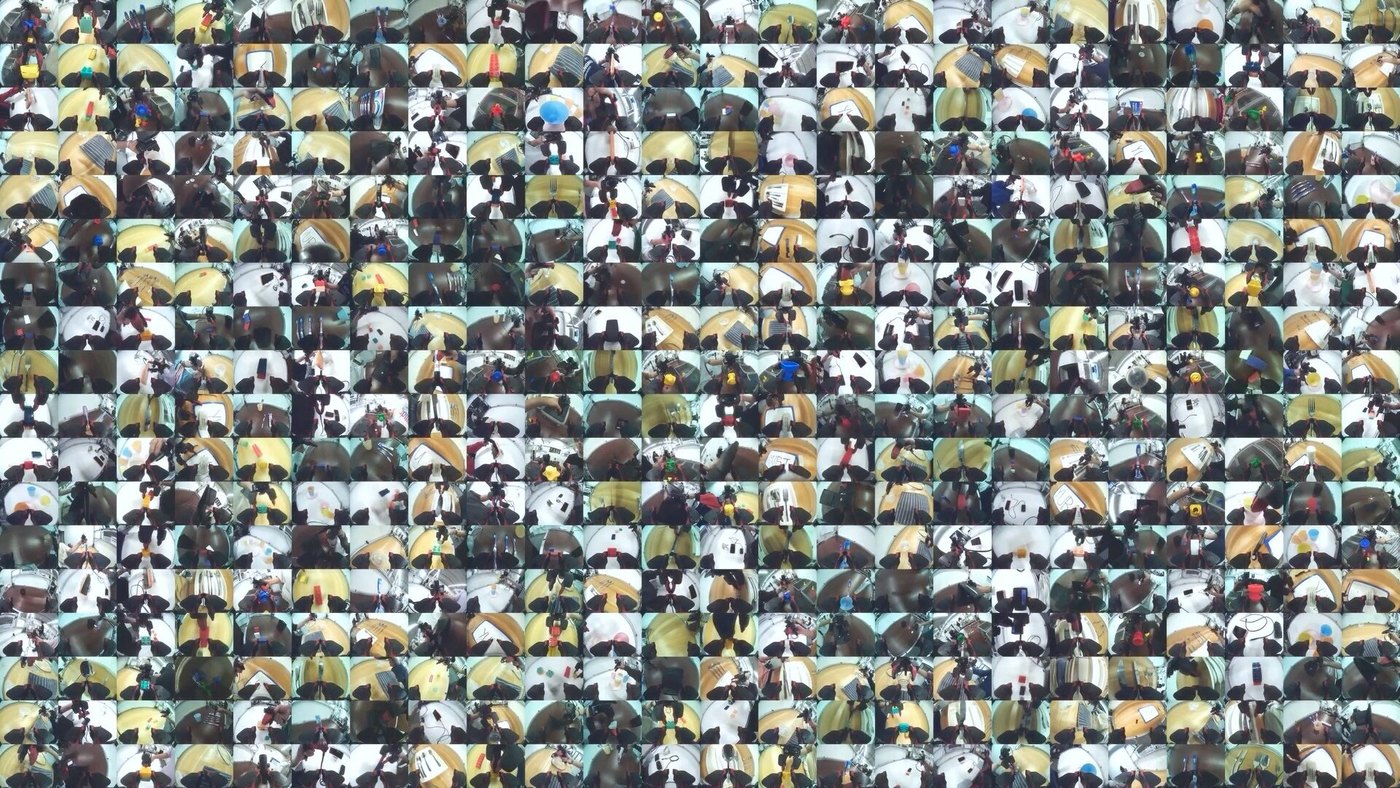
这种做法把采集成本打下来了一大截,但怎么把手持工具的动作精准映射到结构更复杂的五指灵巧手上,中间依然有不小的损耗。
第三条路,是寄希望于世界模型和仿真环境。
像11月初刚发布的小米等团队的新一代因果世界模型,以及学术界在试的“在想象的未来里做后训练”,思路都是让机器人在虚拟生成的视频或物理引擎里自己跟自己练。
但就像11月3日刚出的一篇论文(Trusting Imagined Futures)指出的那样,世界模型自己生成出来的画面,往往会美化动作的结果——在视频里看着杯子稳稳拿起来了,真放到物理世界里,摩擦力差一点点杯子就滑下去了。
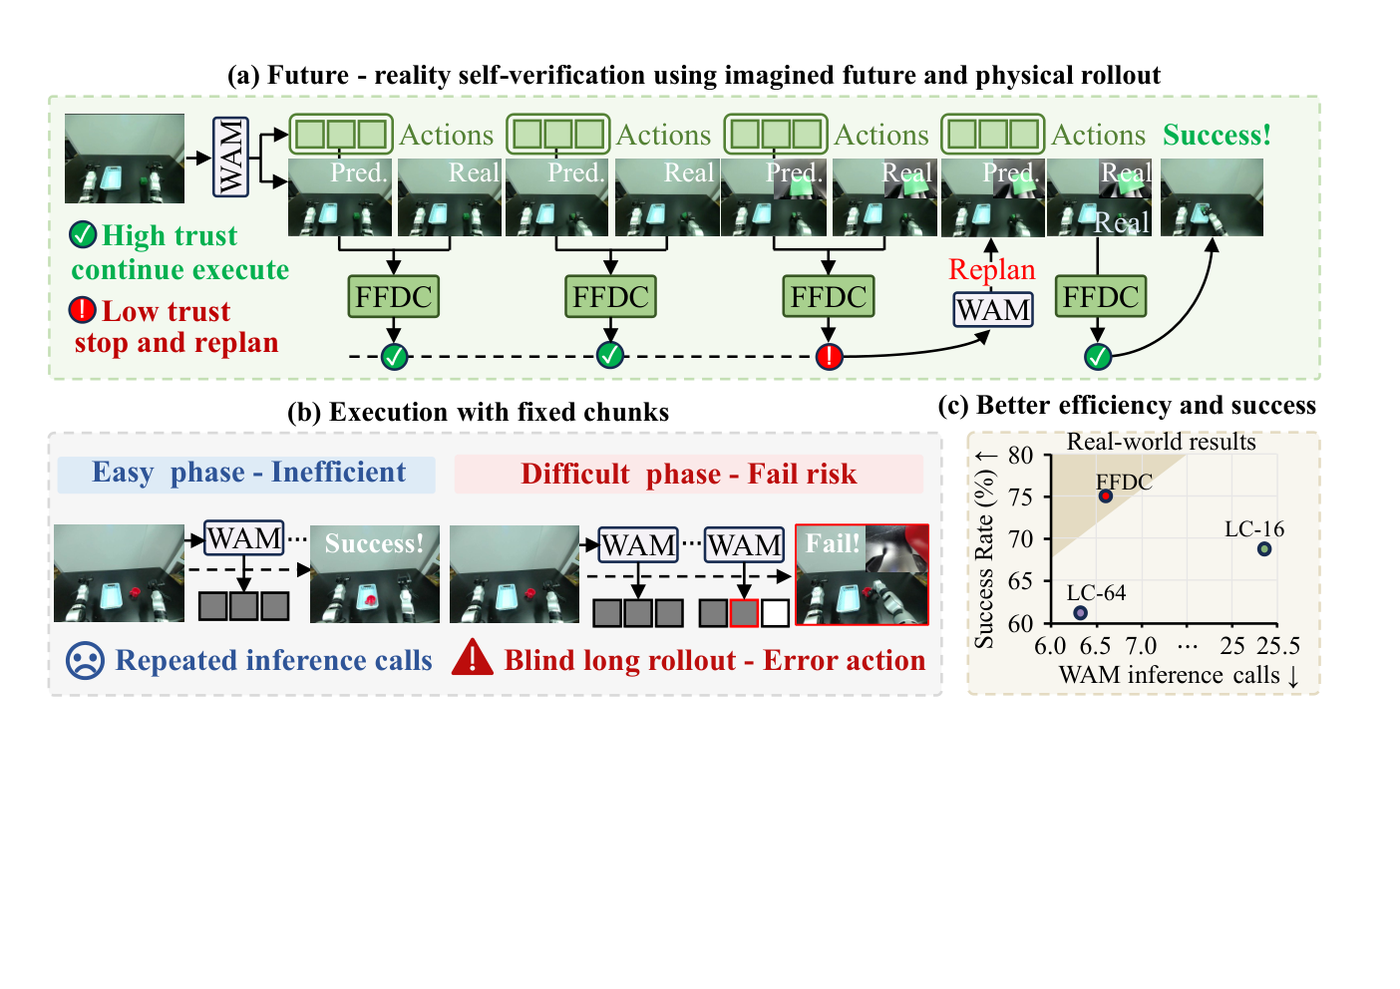
所以直到今天,具身数据的验收依然是个大难题:纯仿真不够真,纯真机采不起,手持设备又还在解决跨硬件迁移的问题。很多具身数商表面上接单接到手软,实际上每天都在为设备故障率、不同客户的硬件适配和模型真机成功率的验收扯皮。
04怎么才能长久?
把这三块业务看下来,你会发现数商这门生意到了今年冬天,逻辑已经彻底变了。
早期大家拼的是消息灵通。谁能提前三个月从海外或国内顶级模厂那里打听到风声——比如知道下一代模型要补 CAD 建模、要补某种冷门语言或者特定视觉问答——谁就能提前找人囤货,赚一波信息差的快钱。
但当模厂的采购全面转向高难度专业领域、且验收死卡“模型能力提升”之后,单靠攒局和关系已经交不出货了。
一套耗费重金做出来的 Terminal-Bench 或 Science 题库,交给模厂刷上两三个月,模型把能力内化了,这批数据的使命也就结束了。要想把公司做成一门长久的生意,数商们现在不得不往更重的地方走。
一条路是顺着模型能力迭代的刚需,把自己变成基础设施。
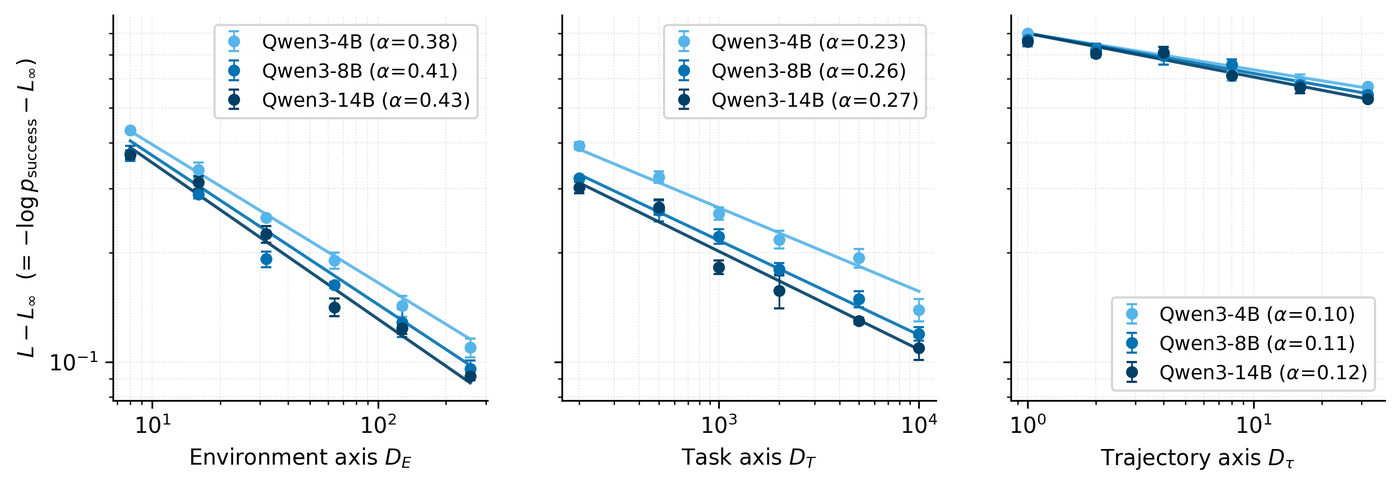
既然模厂每次模型升级、甚至让模型自我迭代都需要庞大的复杂环境,一些头部的硅谷数商干脆不再打包卖镜像,而是把成千上万个 CUA、长程开发和科学计算的沙箱留在自己云端。模厂和应用公司通过接口连进来跑训练、做评测,按调用的步数和验证次数长期付费。10月中旬 Prime Intellect 收购视觉小模型团队 Moondream,也是想把训练环境、底层推理加速和模型训练绑成一个闭环。
另一条路,则是带着在模厂练出来的这套“提分”手艺,去赚垂直行业和大企业的钱。
10月中旬 Mercor 发布过一份《美国经济基准地图》,盘点了全美923个职业后发现,美国人90%的日常工作时间,现有的 AI 评测基准根本没有覆盖到。基模公司的精力只够死磕前沿数学、通用编程、CUA 这几个大方向,剩下那90%的具体行业难题——比如一家芯片公司的内部 EDA 流程、一家药企的实验数据分析——只能靠企业自己通过后训练来解决。
这些企业有钱,也有现成的业务场景,但它们不知道怎么把业务流程拆成 Trajectory、怎么写防作弊的 Rubric、怎么把模型的准确率从60分拉到90分。这时候,能在顶级模厂严苛验收下活下来的数商,顺理成章就能往下走,帮这些企业搭建专属的评测和后训练管线。
除去所有的风口和造富传说,数据这行到了最后,其实没什么捷径。当验收标准收紧到“模型到底有没有变聪明”这一条线上时,留给数商的,终归是一场既考手艺、又考内功的硬仗。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据与可执行评测环境,交付可复现的 Rubric 评分准则、独立可启动的 Harbor Task 容器环境与验证器。文中基准均为公开第三方基准,我们只对齐能力要求与难度区间,不复制题目。官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud