Agent 工程化落地指南:从架构克制到评测双 Loop 的实战拆解
停在 Demo、卡在扩量、缺乏价值证明,是 Agent 落地的三种典型失败。用 Workflow 与 Agent 的边界、上下文工程、离线门控加在线监控的双 Loop,以及可归因的 Trace 基建逐一拆解。
Agent 工程化落地指南:从架构克制到评测双 Loop 的实战拆解
过去三年,基座模型的指令遵循能力与原生工具调用能力持续提升,同时各类 Agent 框架将规划、记忆、状态管理等逻辑抽象为标准组件。搭建 Agent 的工程门槛正在显著降低。然而,在实际业务落地中,多数项目面临三种典型的失败路径:
停在 Demo:演示环境运行正常,接入真实流量后因数据脏乱和场景边界问题导致覆盖率不足。
卡在扩量:小范围试用有效,放量后问题集中暴露,修改 Prompt 或逻辑容易引发已有能力的退化,导致项目在原位反复修改。
缺乏价值证明:模型与 Prompt 迭代多次,但缺乏量化证据证明业务收益,导致项目停止投入。
这些问题的共性在于缺乏可靠的判断机制与工程化规范。本文结合 Anthropic 的 Agent 开发实践与工业级评测体系设计,拆解 Agent 从开发到生产环境的核心工程环节。
01架构设计:工作流与自主代理的边界
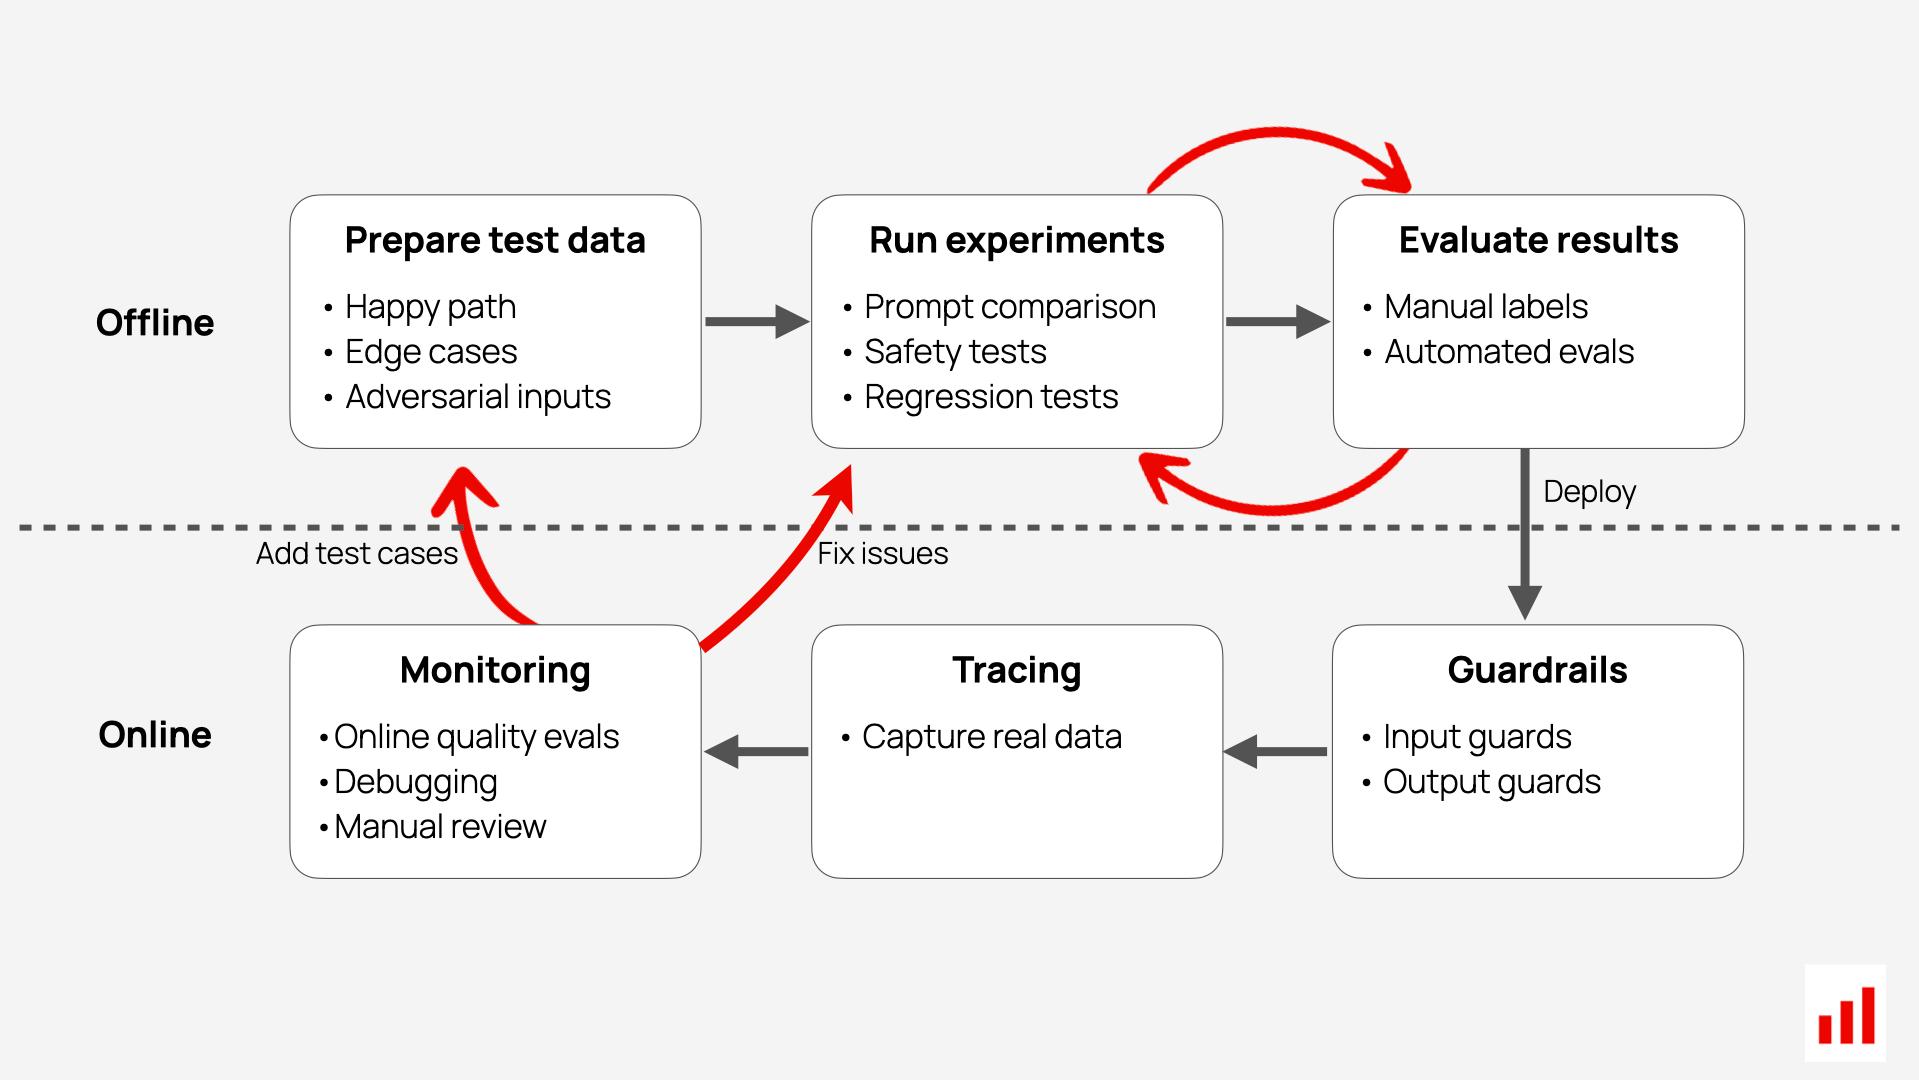
在 Agent 架构设计中,常见的误区是过早引入复杂的多智能体(Multi-Agent)协作系统。Anthropic 在《Building effective agents》中明确了 Workflow(工作流)与 Agent(自主代理)的区别:
Workflow:通过预定义的代码路径和提示词,控制大模型与工具的执行顺序。适用于步骤明确、容错率低的业务场景。
Agent:由大模型自主决定执行路径、工具调用和规划策略。适用于需要动态探索和长程推理的场景。
工程实践表明,多数业务场景仅需定义良好的 Workflow 配合 Tool Use 即可满足需求。在工具设计方面,工具的描述(Description)直接决定模型的调用准确率。对于需要复杂推理的任务,引入“Think Tool”(思维链工具化)可以让模型在执行动作前输出中间推理过程,显著提升多步任务的成功率。
02上下文工程与长任务执行框架(Harness)
当任务执行时间从数秒延长至数小时,系统的挑战从“单次生成质量”转变为“状态管理与容错”。
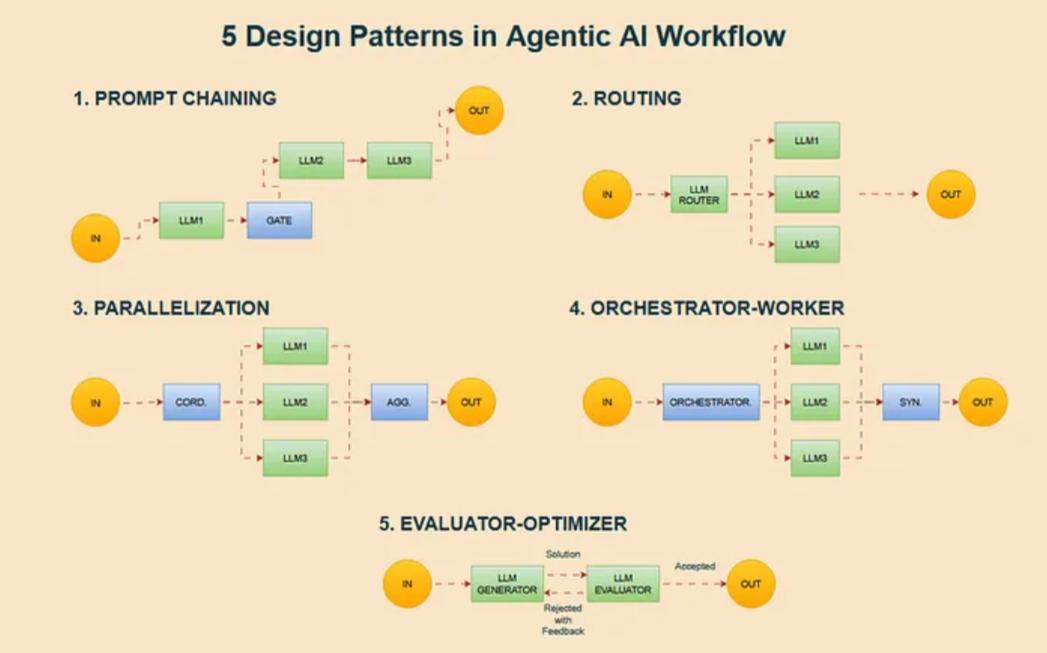
上下文检索(Contextual Retrieval):传统的 RAG(检索增强生成)在文本切片时容易丢失上下文信息。通过在切片前让模型生成解释性上下文,可以提升检索的准确率。
长任务执行框架(Harness):针对长时间运行的 Agent,需要设计可靠的 Harness。核心功能包括:任务中断后的状态恢复、中间结果的持久化存储、以及死循环检测与退出机制。
安全沙箱(Sandboxing):当 Agent 具备代码执行或系统操作权限时,必须通过沙箱隔离和 MCP(Model Context Protocol)等协议限制其操作边界,防止对生产环境造成破坏。
03评测体系:驱动演进的双 Loop 机制
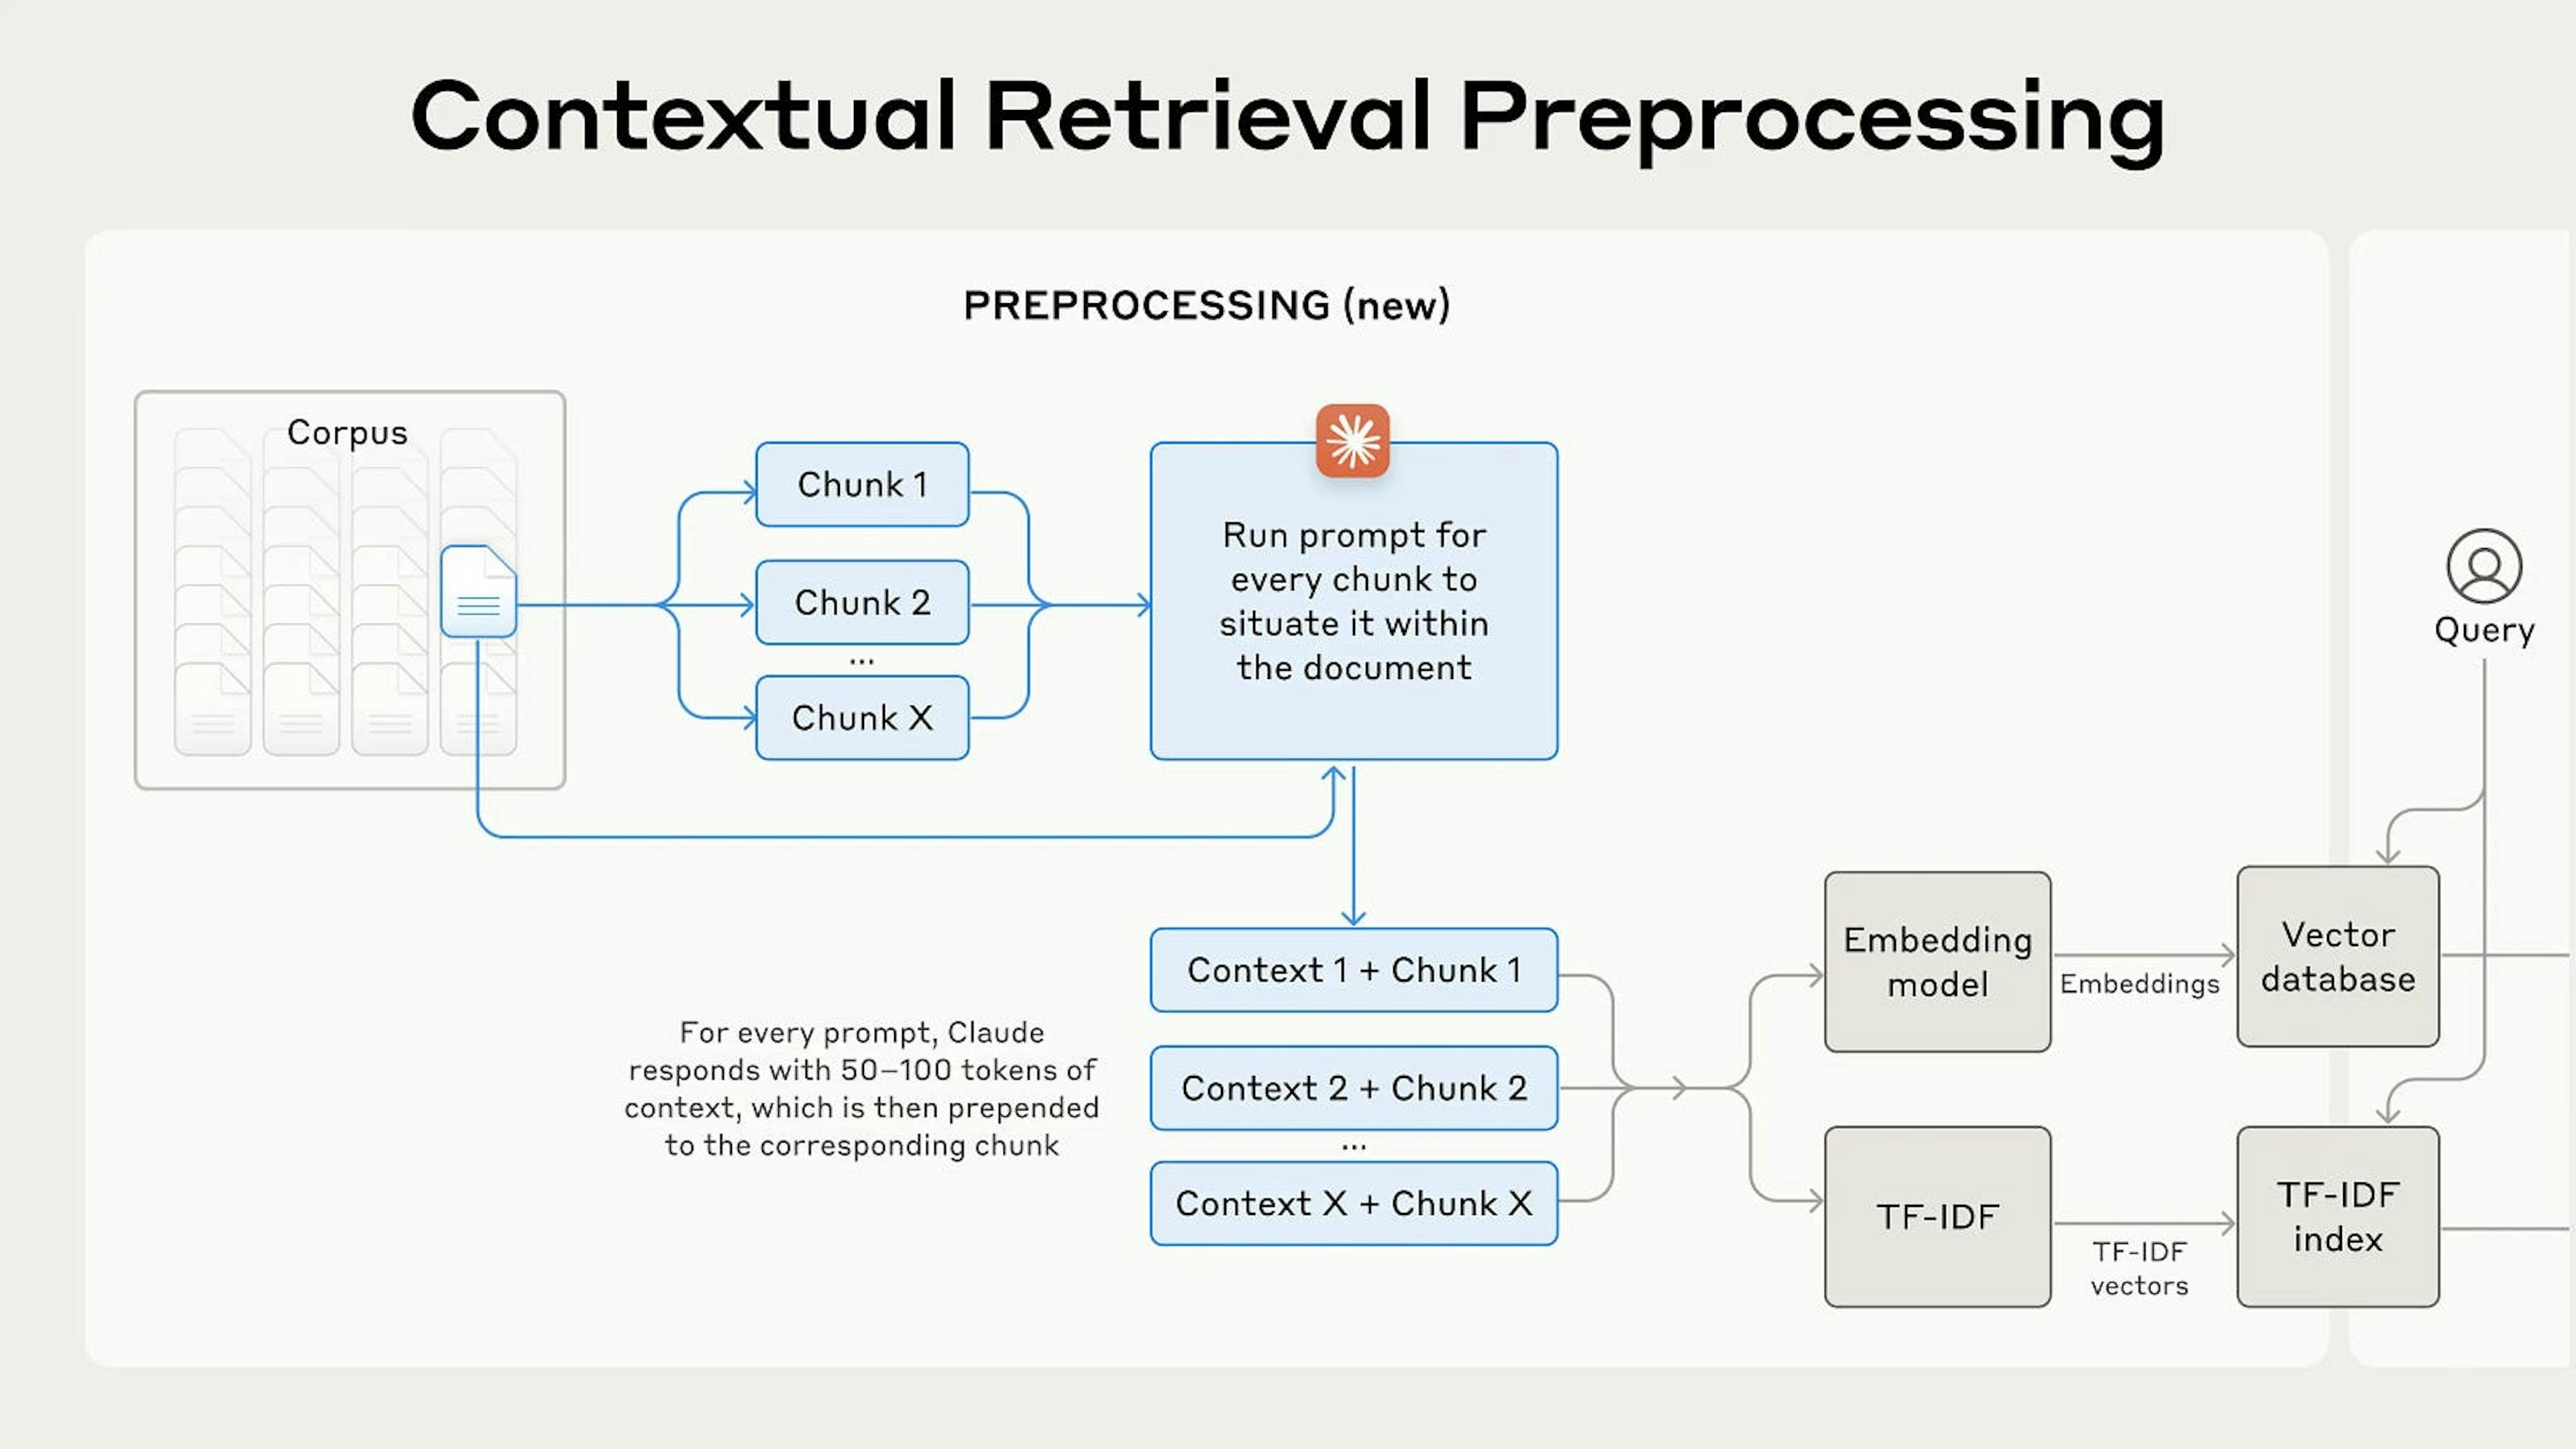
Agent 评测的核心目的是回答“系统当前状态如何”以及“问题发生在哪个环节”。一套完备的评测体系由两条相互咬合的循环(Loop)构成:
Agent 迭代 Loop:通过线上真实样本和离线评测集,定位 Agent 流程中的问题(如 Prompt 缺陷、工具路由错误、上下文丢失),进行修复并回测,确保变更不引入退化。
评测体系迭代 Loop:当线上暴露出评测集未覆盖的新场景,或现有评分标准(Rubric)判断错误时,将这些样本和修正后的标准补充进评测集,使评测体系持续逼近真实业务分布。
这两条 Loop 的枢纽是 Case 挖掘与归因。
Case 挖掘:通过线上反馈、在线监控(如 Token 消耗异常、工具调用失败率上升)和随机采样,收集真实运行样本。
归因:基于 Trace(全链路追踪)日志,将问题定位到具体环节(如意图理解、任务规划、工具调用、环境交互)。归因结果决定该问题是进入 Agent 迭代 Loop 修复代码,还是进入评测体系迭代 Loop 补充评测集。
04离线评测与在线监控的工程实现
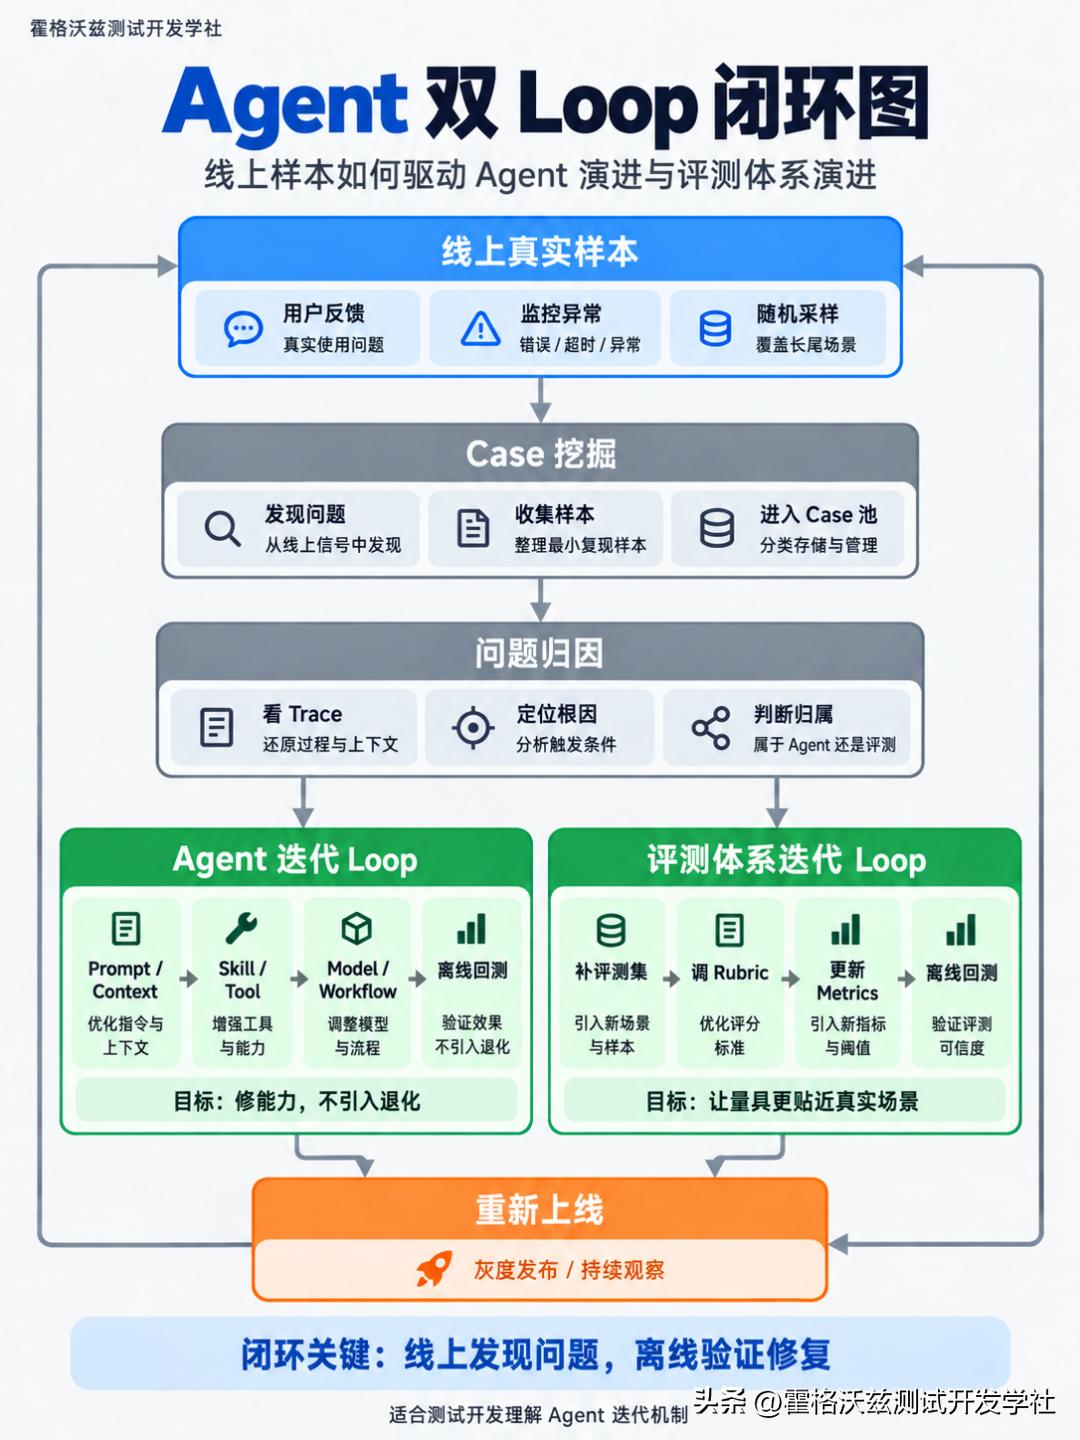
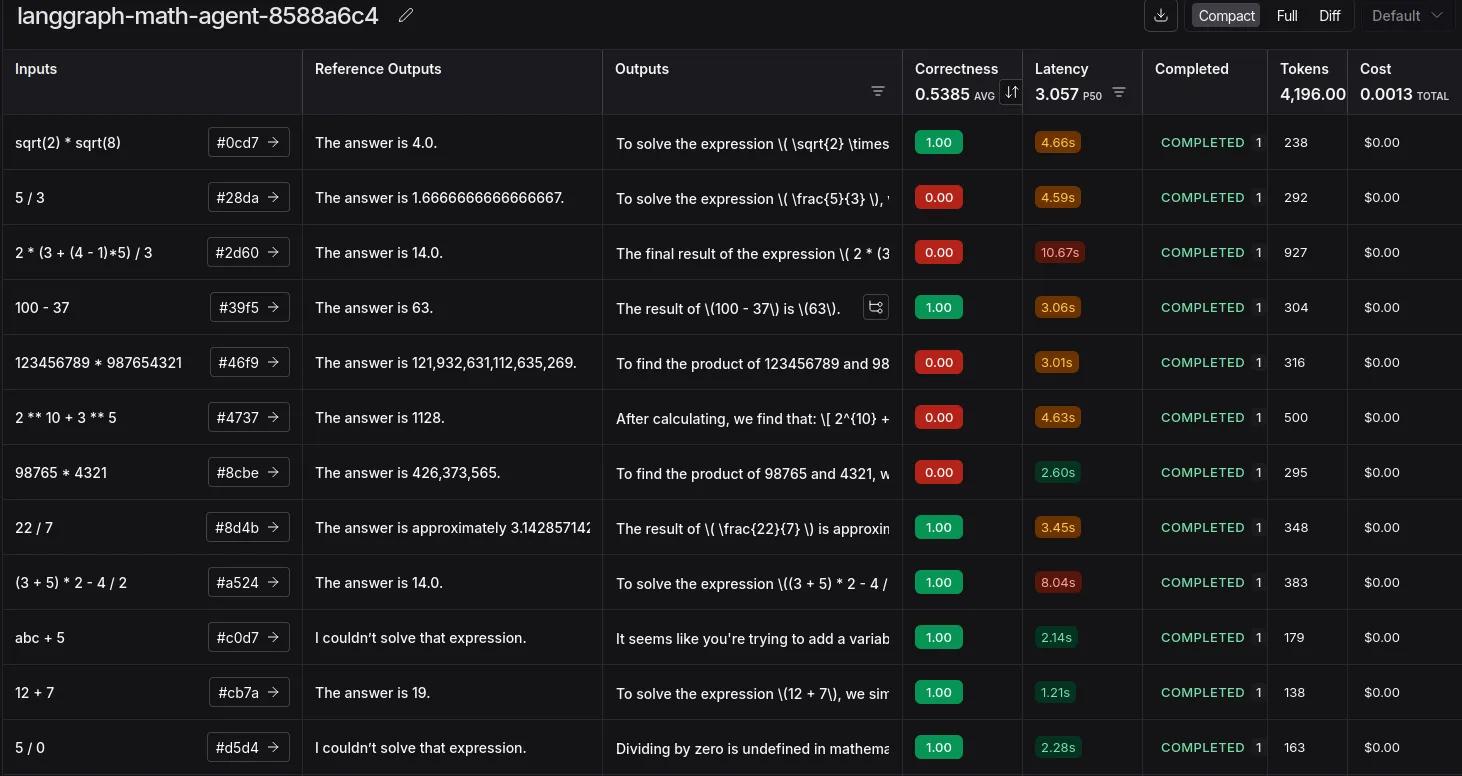
1. 离线评测(门控机制)
依赖固定的评测集(问题、参考答案、评价标准)和固定的执行环境。在 Agent 版本变更(如模型升级、Prompt 调整)时进行回测。
端到端评测集:验证最终交付物是否符合业务目标。
过程评测集:验证中间步骤(如特定 Skill 调用成功率、数据合并正确率)是否符合预期,用于快速定位问题环节。
评价标准(Rubric):采用二元化(是/否)的原子检查项,结合加权求和或一票否决(All-Pass)机制,消除评估的主观方差。
2. 在线监控与巡检
监控系统的运行指标(工具成功率、超时率、Token 消耗)和行为分布(任务类型占比、对话轮次)。当监控指标异常时,触发 Case 挖掘流程。稳定性指标和行为监控类指标需要结合分析:如果任务完成率下降,同时某个 Skill 的失败率上升,通常是工程问题;如果 Skill 正常但某类新任务占比上升,则说明用户结构变化,需要扩充评测集。
05观测基建(Trace):评测与归因的地基
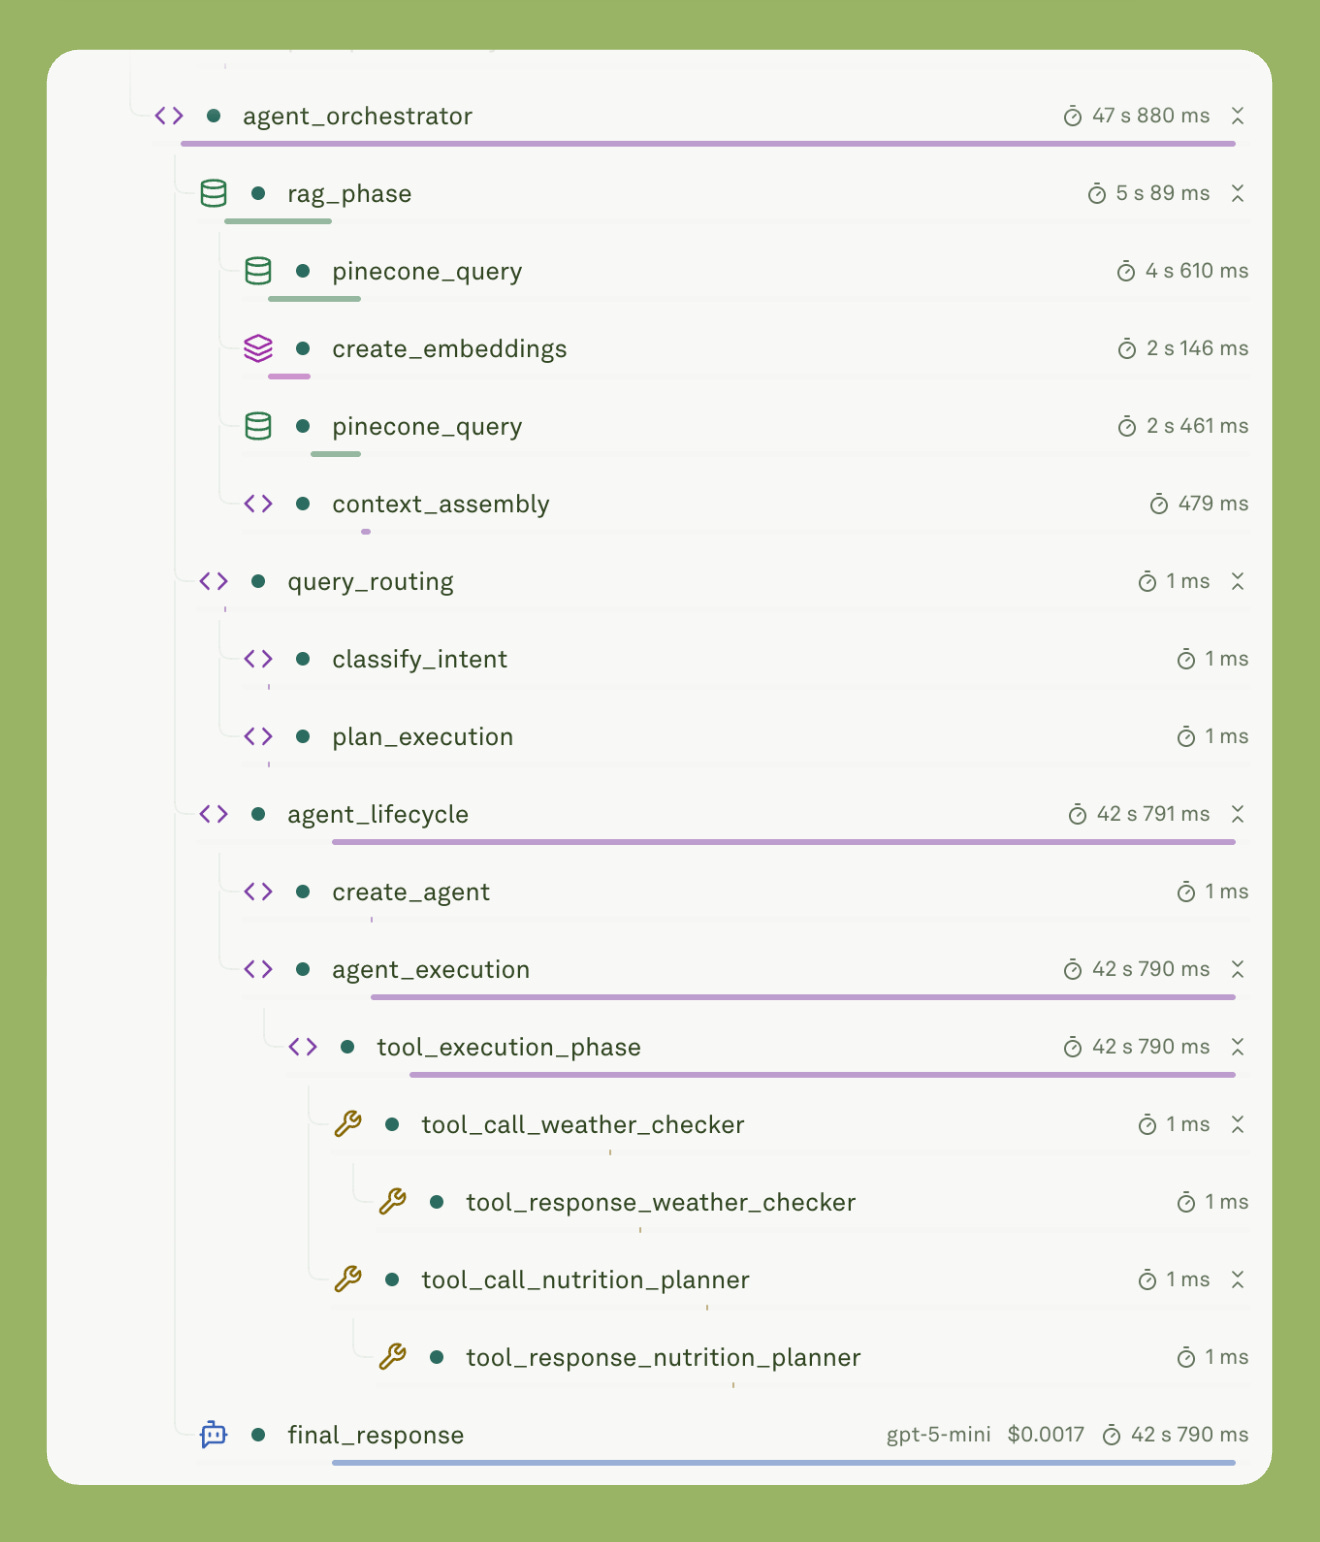
Agent 的执行是一条包含意图理解、规划、工具调用和环境交互的长链路。如果系统仅记录输入和最终输出,将无法进行有效归因。
观测基建的核心是 Trace 系统,它需要记录:
每次大模型调用的完整输入(Prompt、上下文)与输出。
每次工具/Skill 调用的参数、返回值及耗时。
环境状态的变更历史。
具备完整的 Trace 数据,是复现 Bad Case 和自动化归因的前提。在冷启动阶段,至少需要保证“最小可归因”能力,即能够凭 Trace 复现一个失败案例的具体发生过程。
06datamining.cloud 的工程交付标准
在 datamining.cloud,我们为 Agent 研发提供符合上述工程规范的评测资产与执行环境。我们的交付标准包括:
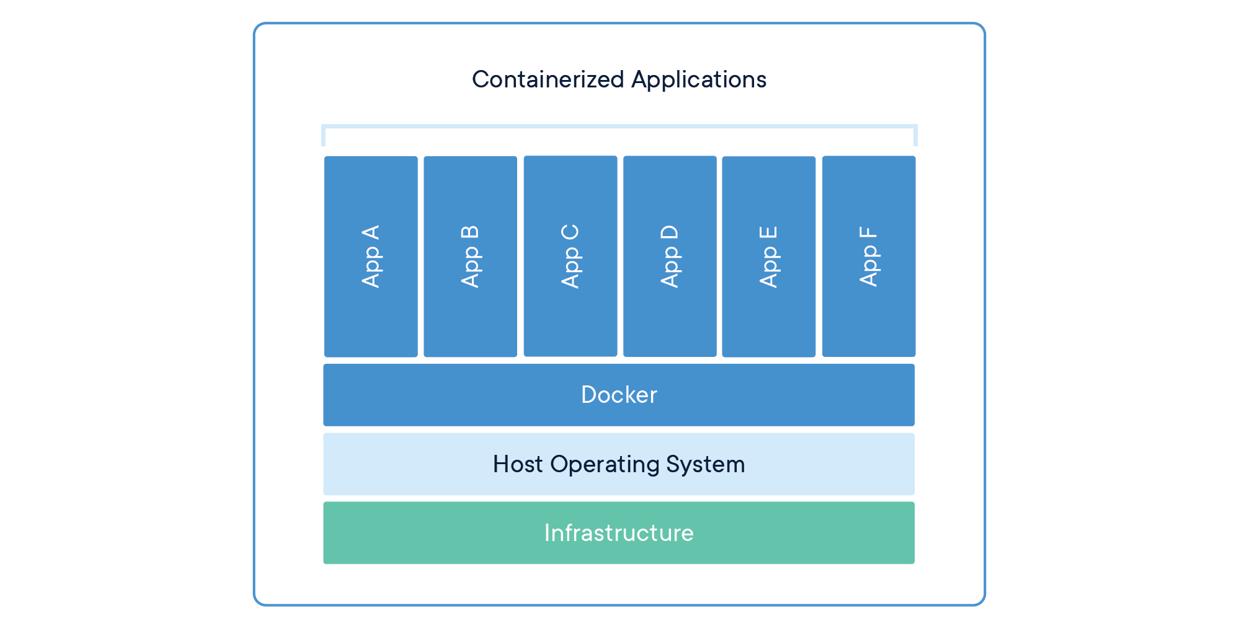
标准化的任务容器(Harbor Task):将业务场景的输入文件、环境依赖封装为独立的 Docker 容器,确保离线评测与线上执行环境的一致性,避免环境差异导致的评测失真。
原子化 Rubric 配置:为每个长程任务提供 35 至 60 条二元化检查项,明确证据锚点与负向惩罚规则,支持自动化评分与门控拦截。
Trace 友好的执行环境:在沙箱内预置标准化的日志采集接口,确保 Agent 执行过程中的工具调用和环境交互可被完整记录,支持后续的 Case 归因分析。
过程与端到端评测集分离:交付包中同时包含验证最终交付物的端到端评测集,以及验证中间 Skill 调用和数据合并的过程评测集,协助团队在指标下降时快速定位问题层级。
总结
Agent 的工程化落地不依赖于复杂的架构设计,而依赖于克制的系统边界、可靠的执行框架以及持续运转的评测闭环。通过明确 Workflow 与 Agent 的适用场景,建设长任务 Harness,并建立基于 Trace 的双 Loop 评测体系,团队可以将 Agent 从 Demo 阶段推进至稳定的生产环境。评测体系建设的本质,是将团队对业务质量的隐性认知,转化为可量化、可复用、可自动执行的显性资产。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据与可执行评测环境,交付可复现的 Rubric 评分准则、独立可启动的 Harbor Task 容器环境与验证器。文中基准均为公开第三方基准,我们只对齐能力要求与难度区间,不复制题目。官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud