公开榜单是广告牌,内部测试集才是收银台
数据商卖的不是「连接智能与现实」,是给模型出模拟题、造可验证奖励信号。真正决定复购的,是能不能在大厂藏着的测试集上打出信号,而不是公开榜单的分数。
去年这个时候,几家明星AI应用公司还饱受质疑。大家觉得它们起得太快、太高,成立刚一年估值就大几亿美金。简直夸张。
但今年,那些公司突然显得有些清心寡欲了。一批成立不到一年的数据商,已经跑出了几十亿美金估值的独角兽,还有好几家卡在几千万美金的估值。Scale被Meta砸了140多亿美金拿49%股份,Surge去年营收过十亿美金,Mercor估值冲到100亿。这些数字背后,真正让人上瘾的不是公开榜单,而是大厂愿意为“能在自己藏着的测试集上打出信号”的数据和环境持续买单。
过去几个月,无论是聊AI应用、具身智能还是世界模型,我在无数个小群里都嗅到了一丝“与我无关”的乏味感。但只要一提到“刷榜”和“评测”,所有人的耳朵瞬间都竖了起来。
各种都市传说满天飞。等这些数据商再搞出点大动静,我们再来扒一扒具体的细节。
01评测和数据,是一门野蛮生长的 ToB 生意
剥掉所有宏大叙事和技术神秘主义,评测和数据其实更像是一门野蛮生长的ToB生意。数据商们就像手工作坊,各凭本事吃饭,目前还没跑出绝对的寡头。Scale、Surge、Mercor是最显眼的几家,但真正能持续拿到第二单、第三单的,往往不是榜单做得最漂亮的,而是能对上大厂内部失败案例的。
很多数据商把自己的生意包装成“连接智能与现实”、“加速AGI到来”等宏大词汇。但扒开底裤就一句话:他们给模型出模拟题,造可验证的奖励信号。
你可以把他们理解为AGI时代的“猿辅导”。
预训练吃的是公共、静态的互联网数据。但在真实工作场景中,模型依然达不到一个合格专业人员的水平。它们需要向行业专家学习,或者大量刷题。数据商干的事,就是找问题、定方案、搭环境。要么给模型找名师——收集领域专家真实的人类解题轨迹;要么给模型出题库:包含任务、运行环境和评分标准的RL环境。然后打包卖给大模型实验室,做专项单科训练。
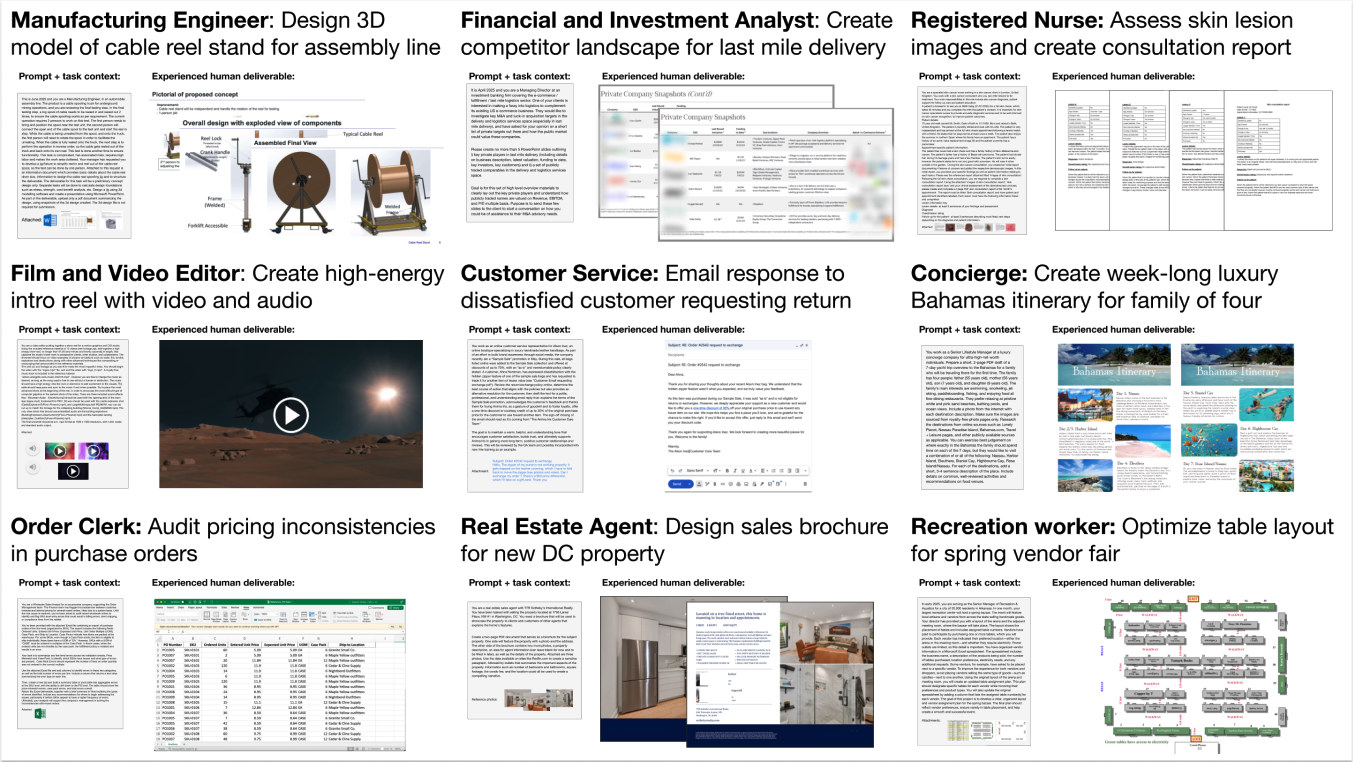
国内的数据商们还发展出了一套颇具创新的玩法:发Benchmark。但这可不是普通的学术评测,本质上它是面向大模型实验室的精准营销车:“你看,你家孩子在‘终端工程’这门课上挂科了知道吗?你看隔壁家考第一,就是因为做了我们家的题库。”
过去两年,模型公司拼算力、拼算法。到了今年,这两者的边际收益都在递减。当流水线建好后,唯一的壁垒就是原材料——数据。这几乎是眼下对模型后训练最有用的东西。
02发 Benchmark,本质是精准营销车
看看他们现在兜售的那些标尺(2026年11月的真实状态):
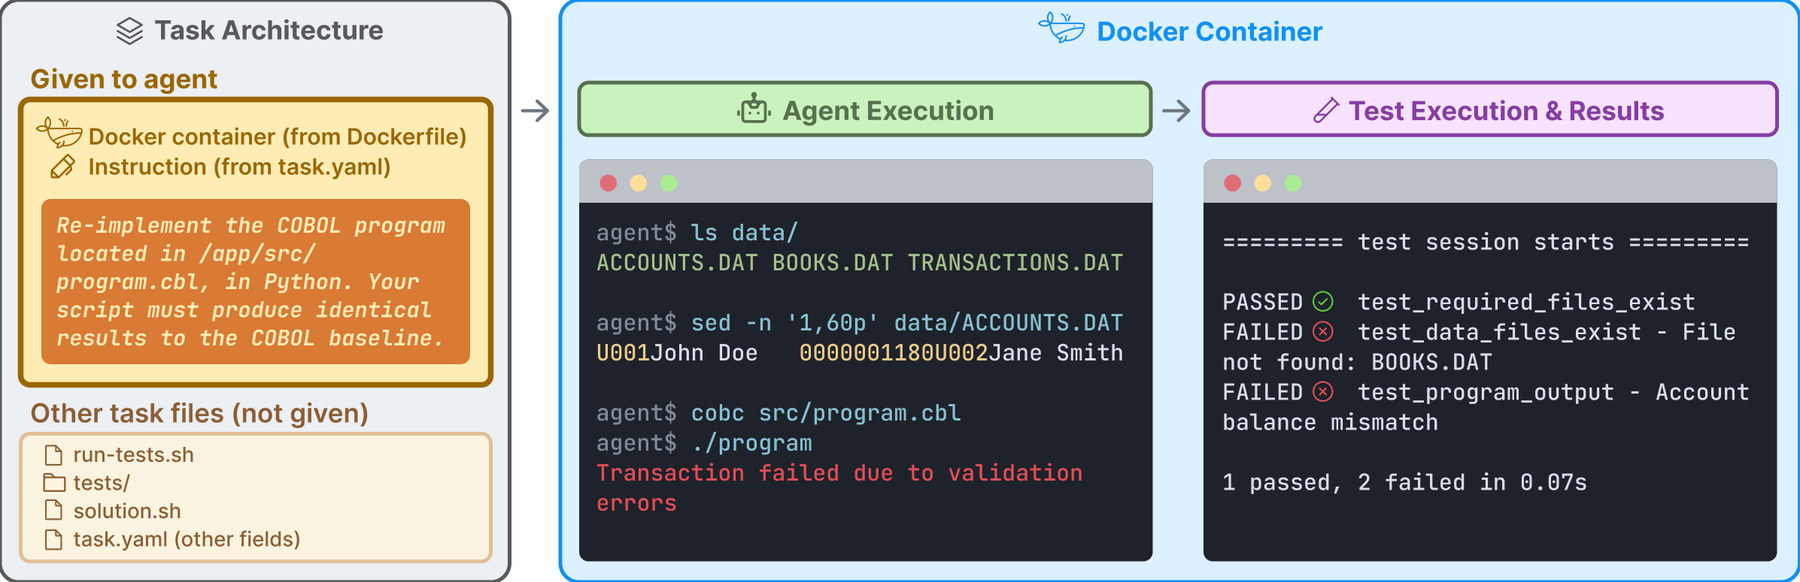
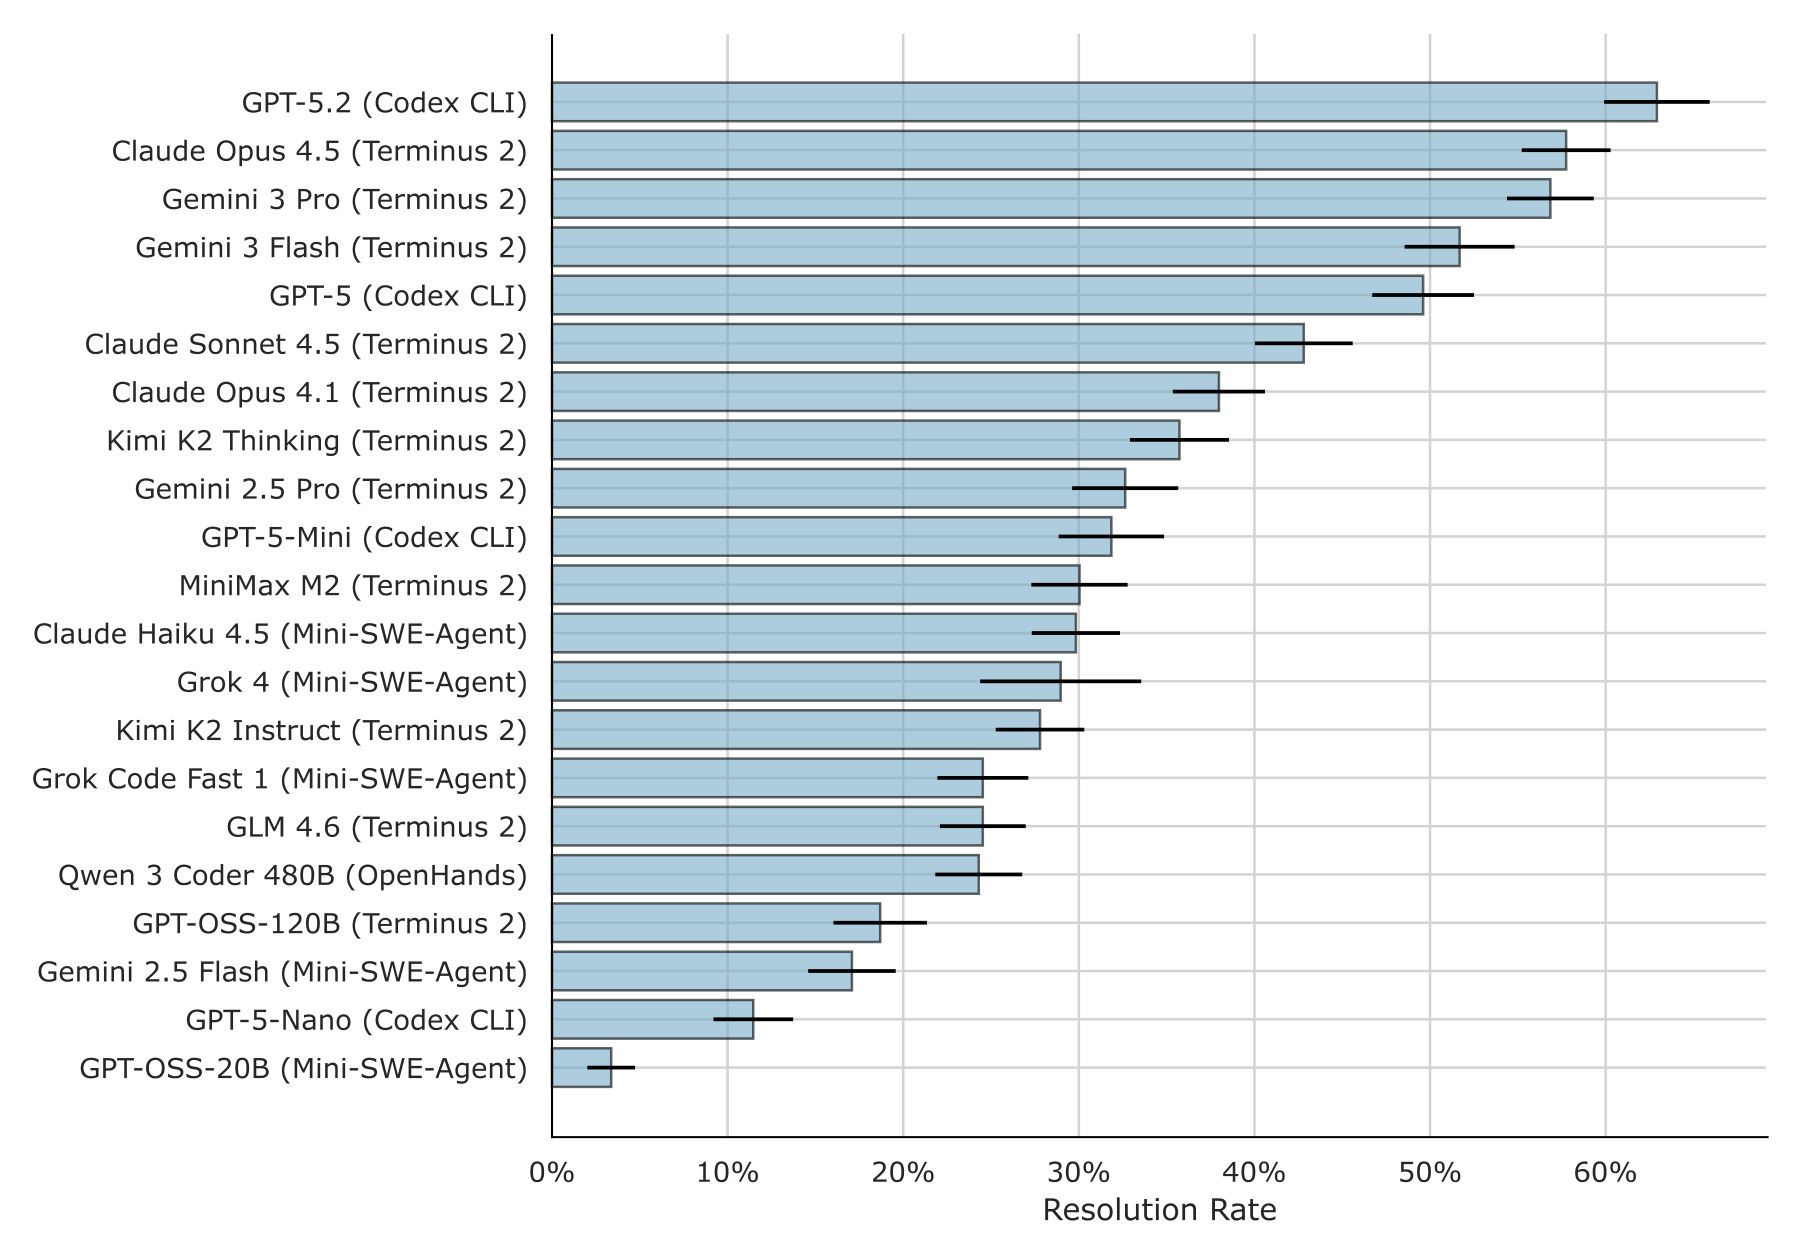
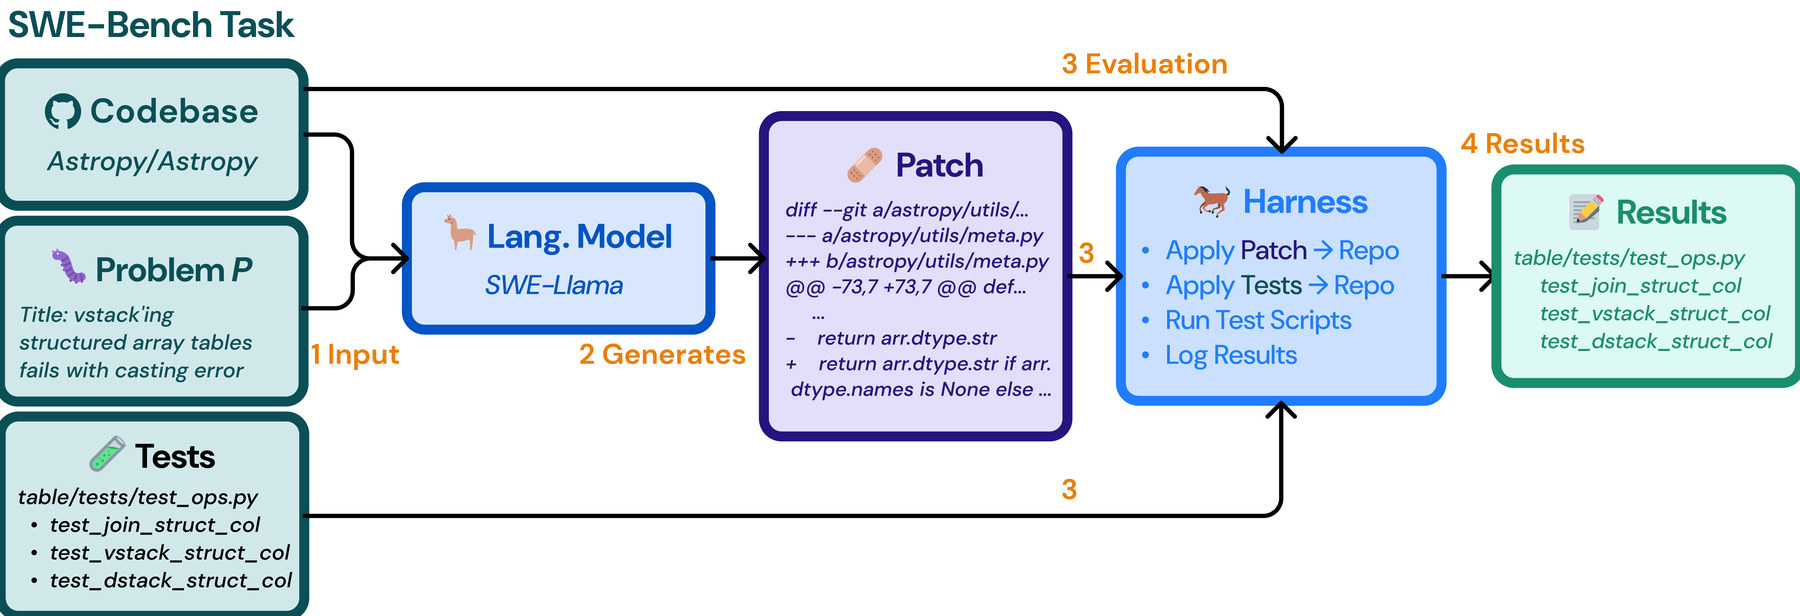
Terminal-Bench(TB3、TB4)是目前通用终端Agent最主流的标尺。 它把模型放在真实Docker沙箱环境中运行,评判标准不看模型输出的文字回答,只看系统最终的文件状态、执行结果。但它的定位是通用终端实操,任务偏向工程通用场景,并没有针对科研领域做深度定制。10月中旬Preference Model和Epoch AI做了深度审计后,发现大量任务存在reward hacking、未说明的评分规则和指令歧义。修复后有模型直接从60%多跳到接近90%。Epoch直接把TB4标成“Flawed”。同一模型换个harness能差十几到二十分,这已经不是秘密。
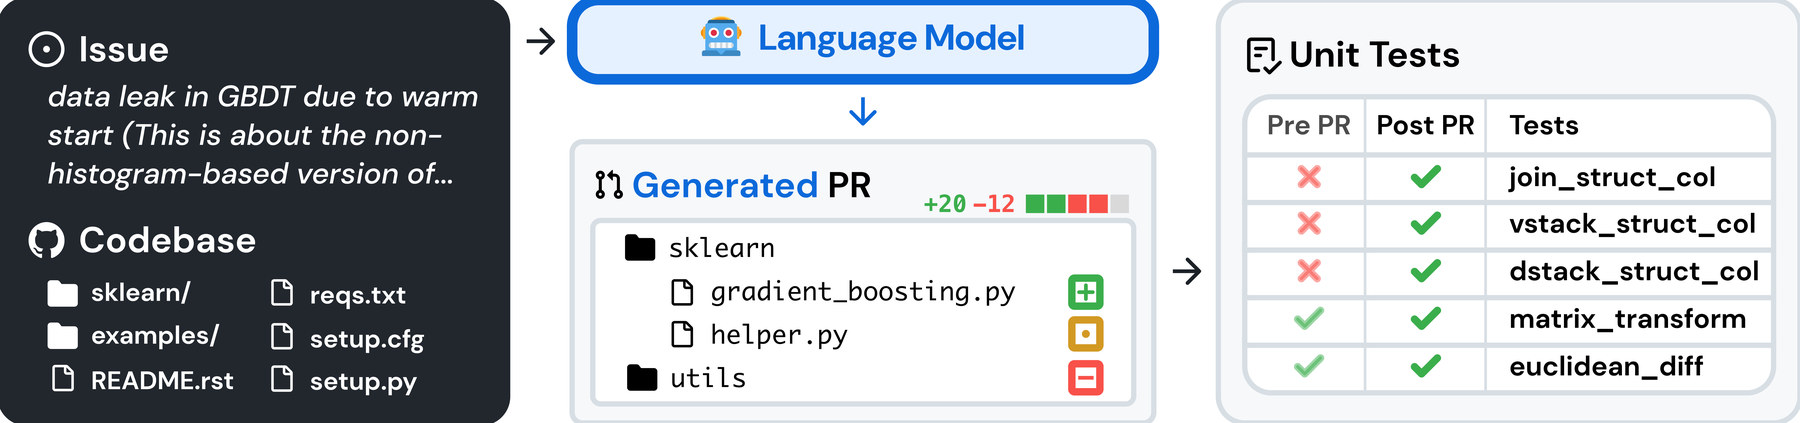
SWE-bench聚焦软件工程场景,任务来自真实开源项目的bug修复。重点检验模型读懂项目代码、搭建运行环境、定位问题、产出可提交补丁的工程能力。它擅长衡量代码工程能力,但并不适配科研数据分析类工作。Verified版本早就饱和到很多实验室自己都不怎么报了,OpenAI之前还公开说过里面有大量测试缺陷和污染问题。行业现在转向Pro版本、private split或者滚动新鲜问题。
TBScience则是AI4S赛道里,门槛很高的一套评测体系。 任务不是简单的选择题或者零散代码题,而是由各学科科研人员亲自设计的完整科研工作流。Agent需要独立完成数据获取、代码计算、结果解读、假设校验整套闭环。发布时头部模型整体解决率大概三成左右,现在独立跑分能到60%区间,但仍有明显headroom。它考察的不是模型记住多少公式定理,而是长链路的科研执行能力:任务规划、工具调用、出错排查、根据实验结果迭代思路。
AutoResearch则偏向科研调研维度,聚焦文献检索、多文献交叉研判、科研问题溯源。它不做代码运算,核心考察Agent做文献调研、信息整合的能力。
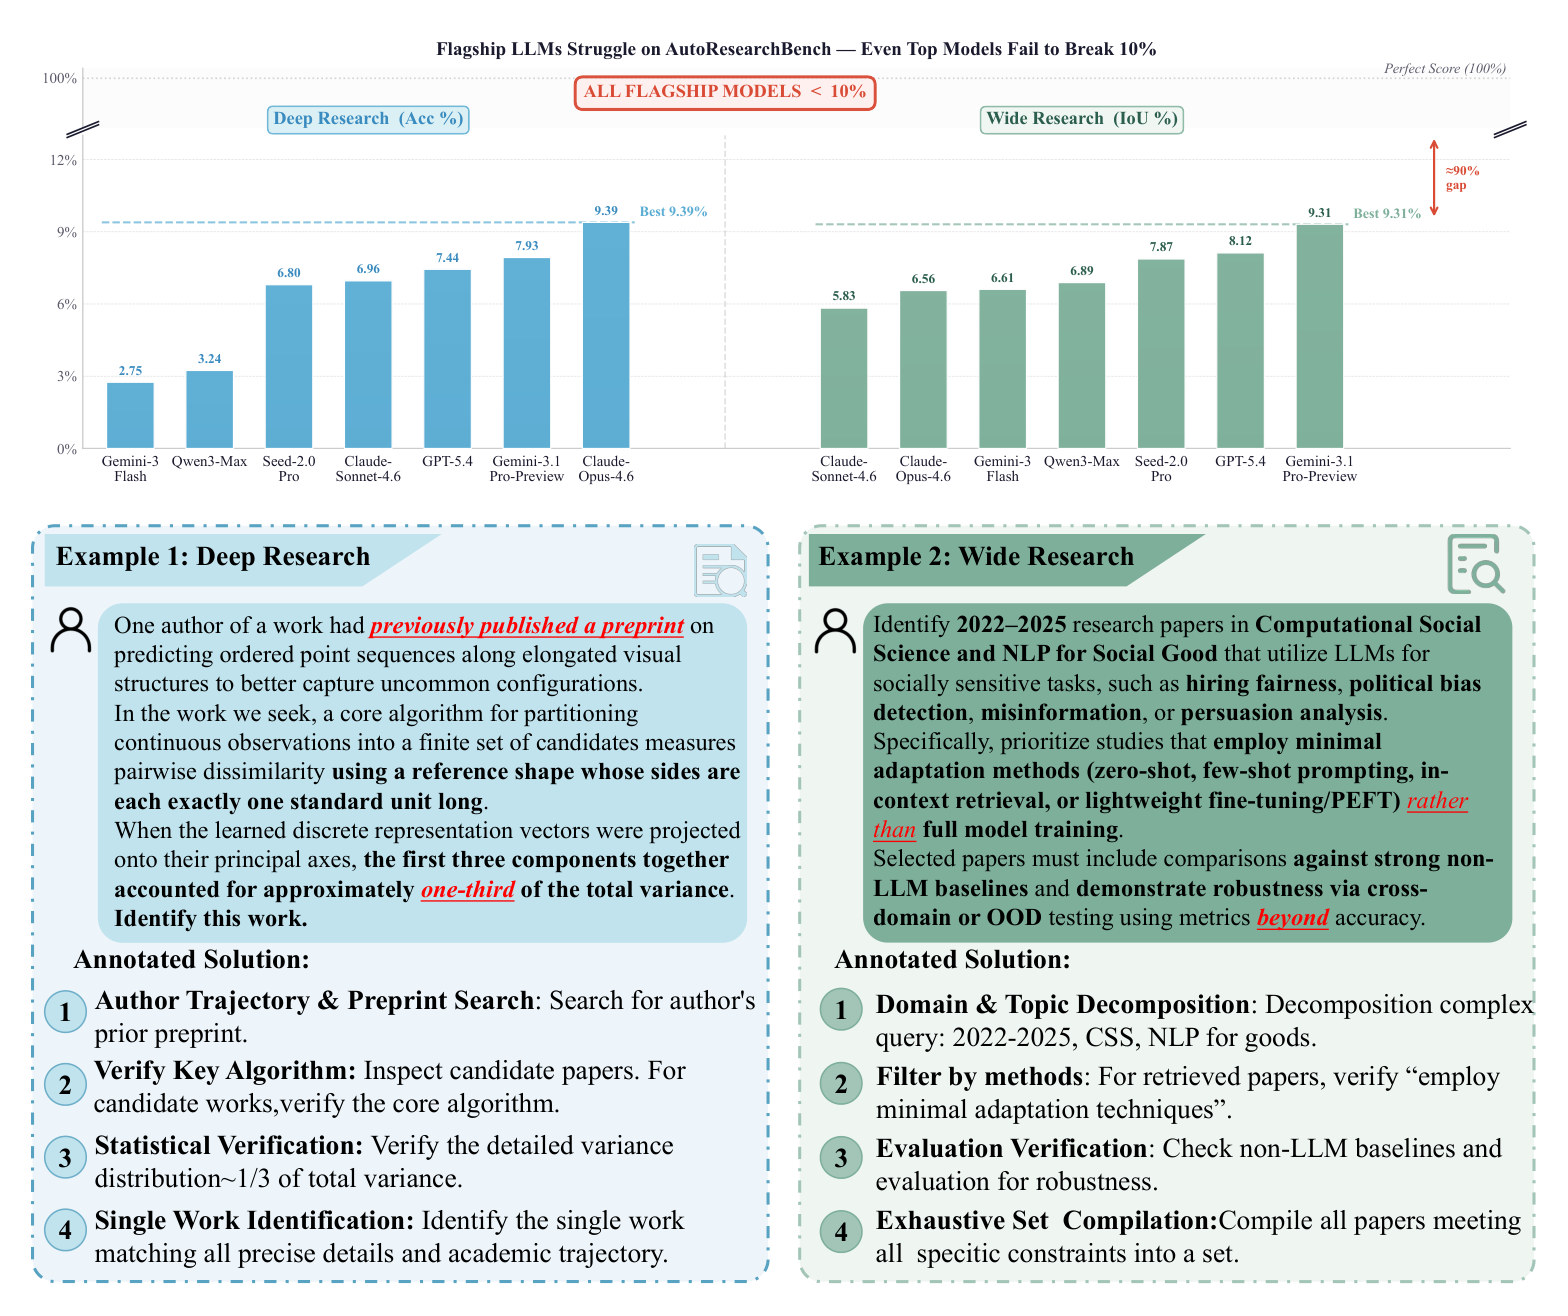
「这几套基准,各有侧重,互不替代。」
SWE-bench拿高分,不代表能处理科研数据分析;TBScience表现优秀,也不等于擅长修复工程代码bug。现实中不少团队为了刷榜,只针对单一评测做定向优化,就会出现榜单亮眼,但实际落地场景表现拉胯的情况。真正想要落地的科研Agent,需要同时具备工程调试能力、完整科研工作流执行能力、文献调研分析能力。只靠单一榜单无法完整衡量真实实力,必须多基准交叉验证。
03算力与算法的边际收益递减之后
这是一个信任市场,目前还没有被广泛认可的验收标准。
鉴于极高的专业度和庞大的体量,模型实验室早期只能抽检。更靠谱的方法是事后验证:喂给模型跑一跑,看指标涨没涨。但这依然会产生玄学:比如SWE-bench的“污染(Contamination)”和“作弊(Gaming)”早已是行业内心照不宣的秘密。因为训练数据的泄露和非标准化的脚手架,SWE-bench Verified上的顶级高分早已不能代表真实的代码前沿能力。有些评测机构把同一批数据卖给两家模型公司,一家的效果提升了,另一家却毫无波澜。
大厂实际的验收比公开文章里写的硬得多。几乎所有一线实验室都会留一套供应商完全看不到的held-out测试集(通常是从生产日志里聚类出来的真实失败案例)。数据进来先跑这个,公开bench分数只是参考。他们还会做ablation:同样算力下,加了这批数据后,在相关任务上有没有可测量提升,且能不能迁移到没专门针对的相近任务。
只在供应商自己的bench上亮眼、内部没动静,第二单直接停。环境必须难被hack,实验室会专门派人找漏洞;找到简单作弊路径就退货或要求重做。好的RL环境还要能持续产出新轨迹,而不是一次性静态数据集。
专家轨迹的质量也会被抽查——不只是答案对,还要有真实专家的决策路径和出错排查过程。
这同时也是一个信息市场,手眼通天的能力远胜于技术优越。
什么时候需要什么数据的判断,是从金字塔尖一层层传下来的:国内一线模型公司盯着OpenAI和Anthropic,二线公司盯着一线公司。如果数据商能比同行更早、更准确地嗅到这种需求,那就等于在交易内幕信息。比如,当大厂内部决定猛攻SWE-bench或Terminal-Bench时,数据商们早就开始疯狂爬取和清洗相关的开源代码库。等到榜单更新,数据商们的“密卷”早就卖得盆满钵满了。
「这更是一个利润惊人的市场。」
04研究员圈子:信任如何分发
但真正的一线大厂在干嘛?到了2026年11月,OpenAI和Anthropic早就看透了这种刷榜游戏的虚无,但并没有彻底抛弃公共榜单——他们依然会报Terminal-Bench和SWE-bench的分数,主要是为了发布和对比。真正驱动训练的是内部eval。
Anthropic在今年初发布了《Demystifying evals for AI agents》,明确指出公共排行榜的脆弱性,呼吁设计更严谨、更有用的真实部署评测。他们内部发现,真实工作流的产出提升,绝不是靠在公开榜单上刷分刷出来的。他们靠skills(领域参考文档+高级分析师的runbook)把内部分析agent从很低的成功率拉到很高。
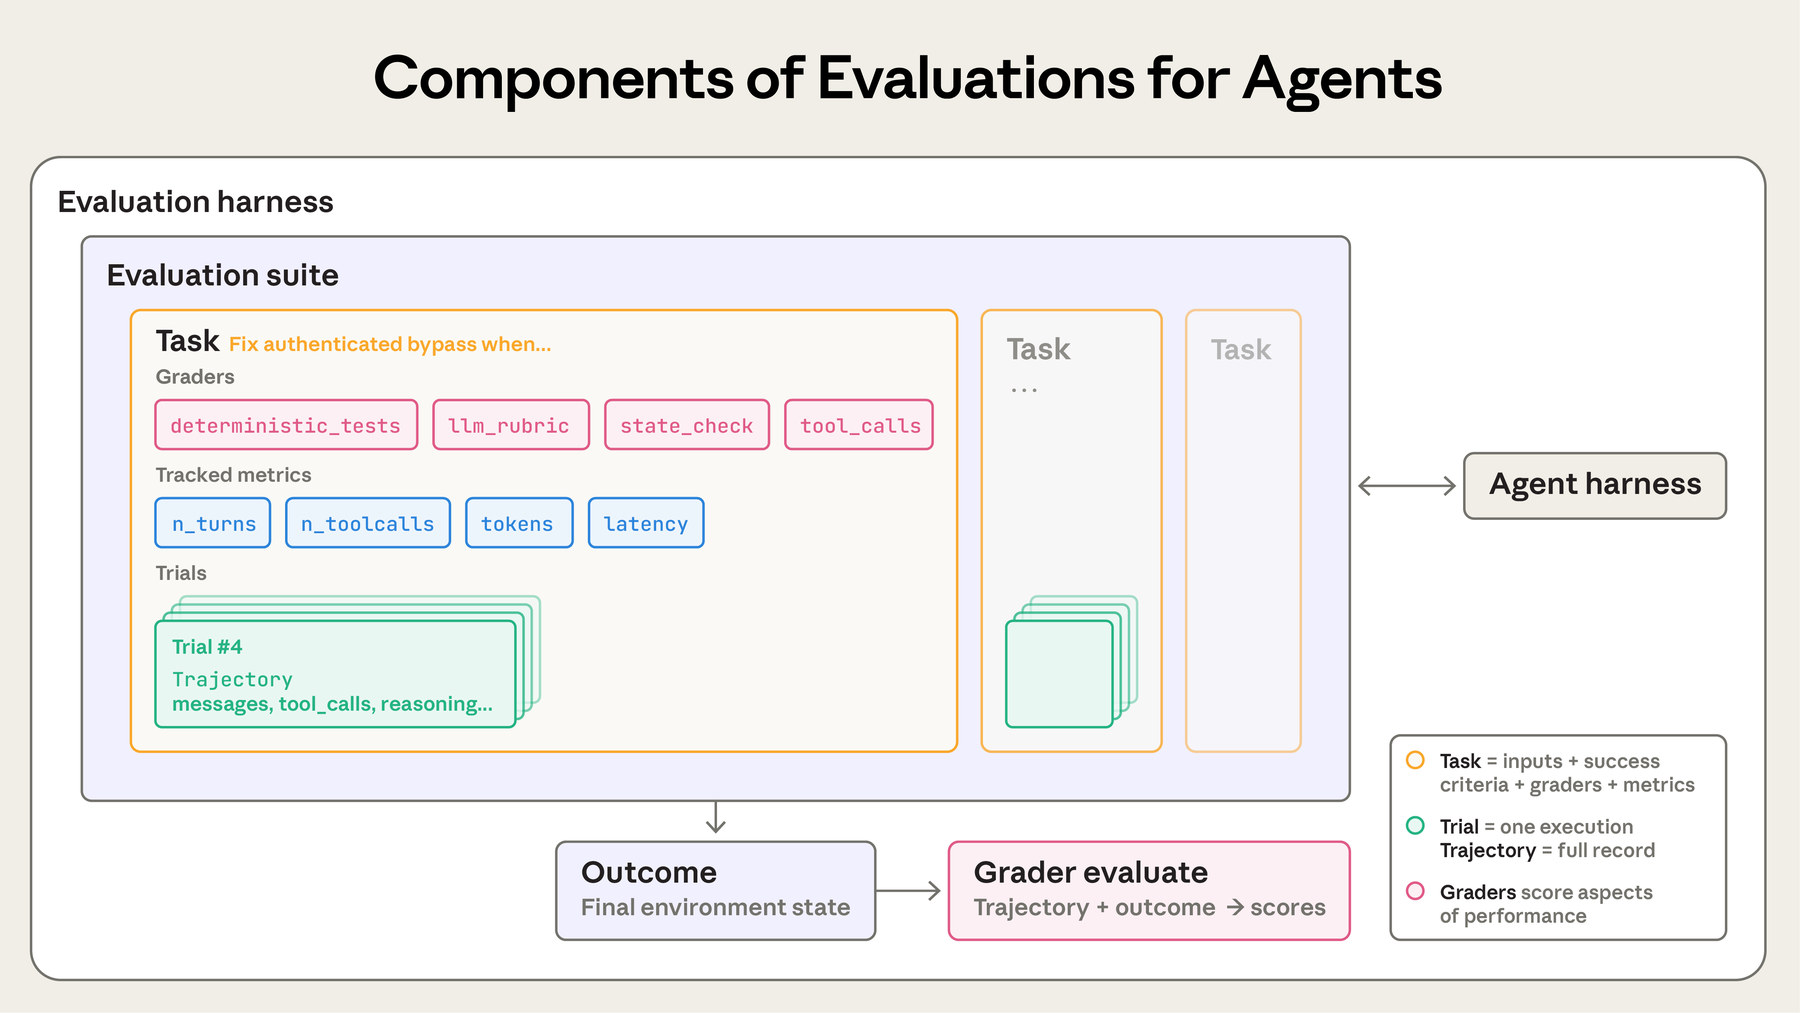
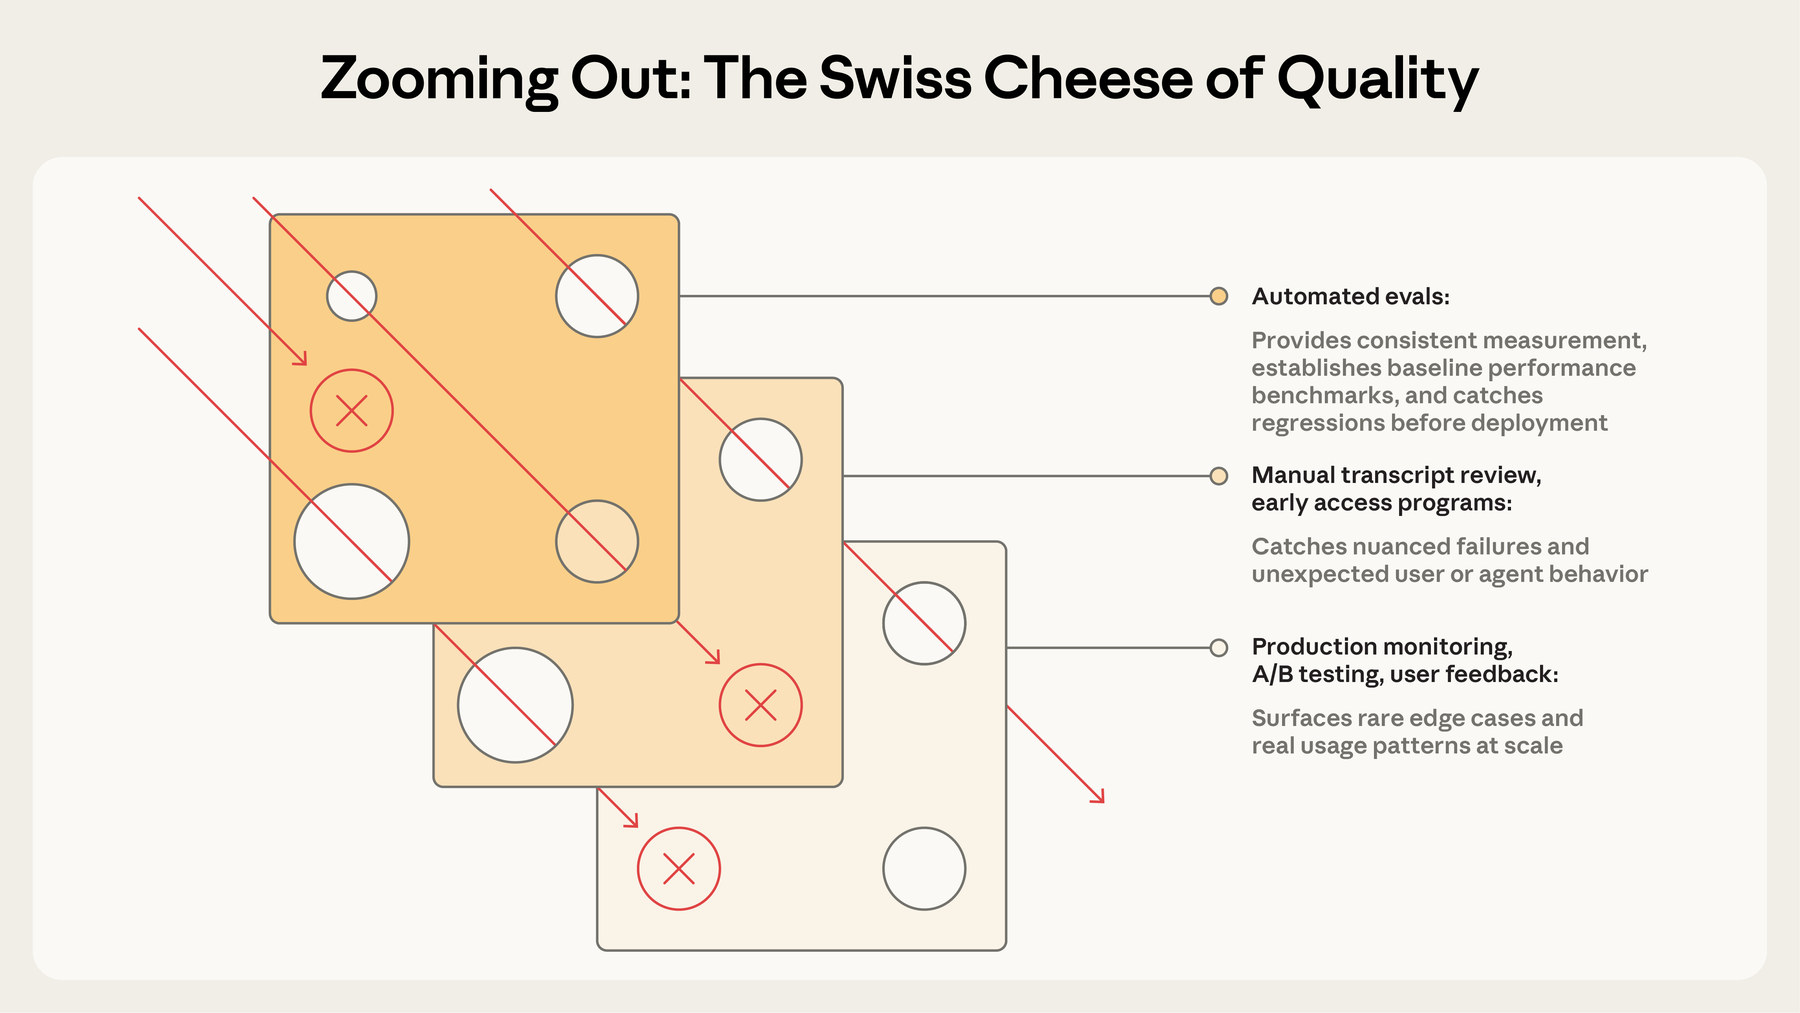
OpenAI更是推出了GDPval,专门衡量模型在44种真实职业、具有经济价值的现实任务上的表现(专家盲评,不是自动打分)。他们还有持续跑的内部测试。他们知道,如果一个模型只是学会了如何在特定的Docker沙箱里“走捷径”拿高分,到了真实商业环境里只会一塌糊涂。
对于大模型的后训练而言,强化学习(RL)确实成了2026年新的护城河。但RL的燃料,必须是高度贴合真实业务场景的私有反馈(Private Evals)和难被hack的环境,而不是那些已经被各大模型公司翻烂了的公开Benchmark。公共榜单的使命没有完全终结,但它们的权重已经被大幅下调,主要用来做营销和粗筛。真正决定后训练方向的,是内部held-out和定制环境。
05公开榜单只是冰山一角
我曾经问过一位做数据评测的朋友:干这行成功的最关键因素是什么?他不假思索:当然是和模型实验室的研究员搞好关系。
听起来很像SaaS行业那种销售驱动的套路。但他打了个更绝的比方:大厂研究员手里握着最终解释权——什么数据算有效、什么环境算过关、什么提升算真实。数据商再能包装,也得先让对方点头。公开榜单是广告牌,内部测试集才是真正的收银台。
现在我懂了。那些发各种Benchmark的数据商,本质上是在做高级销售。榜单是他们自己印的宣传册,真正成交靠的是能不能钻进大厂那套不对外的验收流程。
研究员周围的圈子极其封闭。大模型实验室的研究员大多出自清北、港科大、北航等少数几所目标院校,同学、实验室师兄妹互相提携。数据商和模型实验室之间,往往就是前同事、校友、同门的关系。这也解释了为什么头部数据商的创始人,大多出自大模型实验室。Meta入股Scale后,一些实验室开始更明显地分流到Surge和Mercor,也是这个逻辑在起作用。
06收银台在大厂内部的测试集
最后,如果你以为这就是评测和数据生意的全部,那你还是太低估了这条产业链的纵深。
公开的榜单竞争,不过是冰山露出水面的一角,是给VC和媒体看的体面戏码。在那些没有摄像头、不写进论文、甚至连合同都不会留下白纸黑字的灰色地带,一个围绕着模型蒸馏、私有数据洗白、以及用虚假评测套取资源的庞大暗网,正在这片繁荣的泡沫下野蛮生长。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据与可执行评测环境,交付可复现的 Rubric 评分准则、独立可启动的 Harbor Task 容器环境与验证器。文中基准均为公开第三方基准,我们只对齐能力要求与难度区间,不复制题目。官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud