数据配比:是固定算力约束下的零和博弈与工程手艺
数学语料只有约 54B tokens,多语言 628B 对英语 5.1T,代码占比 25% 反而拉低综合基准。从库存约束、分阶段课程、退火消融到自动配比算法的边界,拆开固定算力下的配比手艺。
大模型训练前,团队已经做了两件事:清洗数据(去重复、去掉被污染的题目、过滤低质量网页)和合成数据(能自动判对错的任务、带标准答案校验器的生成题)。这两步解决的是 "手上到底有哪些能用的数据"。
但真正决定模型最终能力高低的,是另一件事:在总 token 预算固定的情况下,各类数据各占多少比例—— 这就是数据配比(data mixture)。
它本质上是一道零和分配题:数学数据多占 1%,其他类别就要少占 1%。而且能配比上去的上限,不是你愿望清单里想让模型会什么,而是三个现实条件:
- 手里到底有多少不重复、质量过关的数据库存;
- 跨领域之间知识能不能互相迁移,同一批数据反复训练带来的收益会不会越来越小;
- 训练后期学习率(可以理解为 "模型调整自身参数的步长")降下来之后,模型进入定型阶段,新数据的影响变弱。
01为什么配比受限制:高质量数据就是不够用
数学:用多了会背答案,不会推理
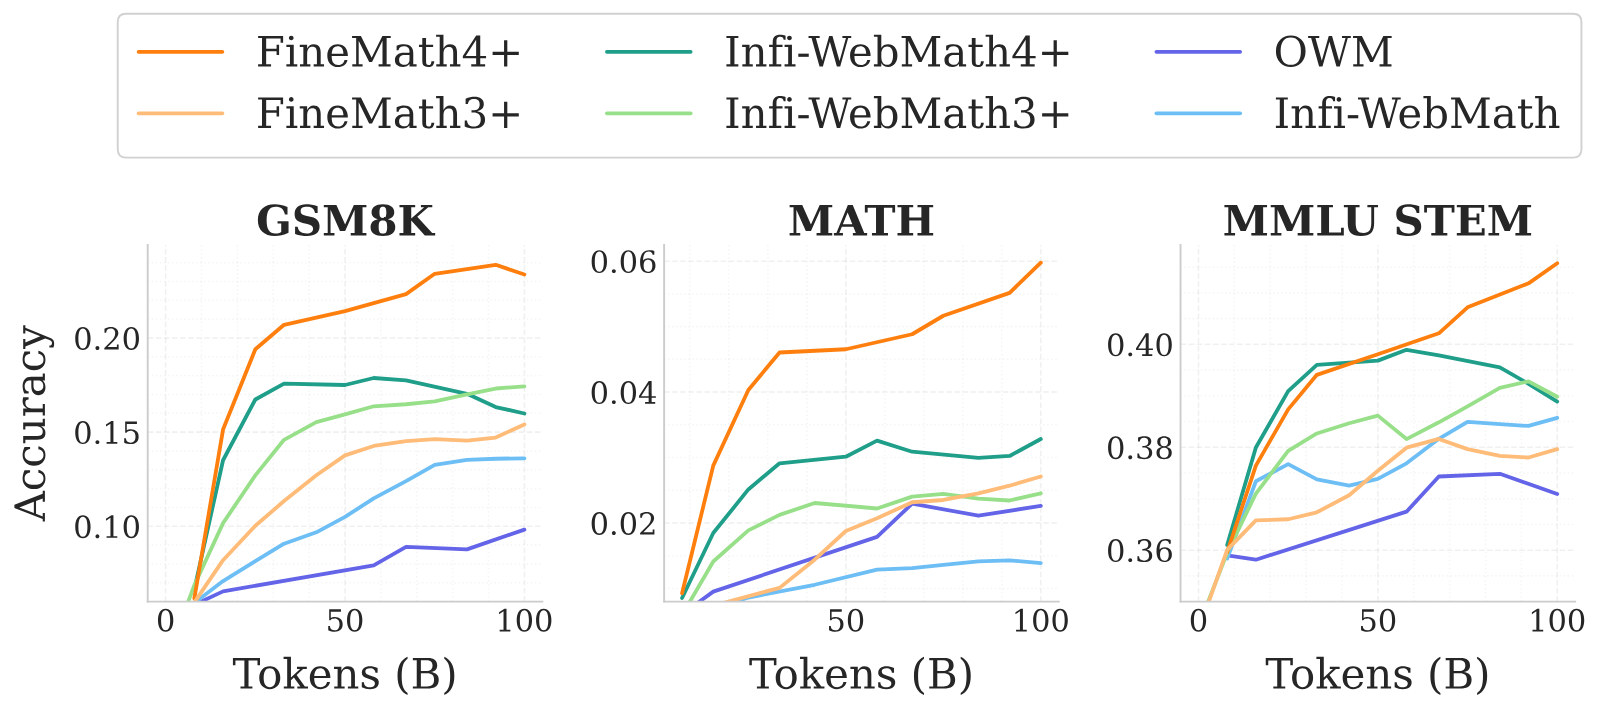
高质量数学语料是稀缺资源。FineMath3+ 加 InfiWebMath3+ 两份数据合计只有约 54B tokens。在训练最早期 8–9T tokens 的阶段,如果数学占比超过 3%,这批题会被模型反复看 5 遍以上。
这时模型学到的不再是推理方法,而是记忆题面和选项分布—— 比如记住 "通常选 C 的概率最高"。换一道新题就不会做。
多语言:英语太多,小语种只能挤出份额
法语、西班牙语、德语、意大利语、葡萄牙语这五种欧洲语言的高质量语料合计约 628B tokens,而英语有 5.1T,量级差了近一个数量级。消融实验(即每次只改一个变量、对比效果的实验)表明,多语言数据放到 12% 左右,是 "保住英语能力" 和 "覆盖其他语言" 之间的平衡点。
代码:占比高不一定全是好事
代码数据有个更微妙的取舍。有些论文声称代码占比高可以提升推理能力和世界知识,但在 3B 小模型上的实际消融中,代码占 25% 会明显拉低 HellaSwag、ARC、MMLU 这些英语综合基准的成绩;最终稳定在 10–12% 比较合适。
这不是 "团队不重视数学、代码或小语种",而是库存数量和重复训练的代价共同构成的硬约束,绕不过去。
几个公开配方参考
- Llama 3(Meta)最终混合大约是:50% 通用知识、25% 数学与推理、17% 代码、8% 多语言。团队还用知识分类器把娱乐这类占比过高的类别降下来采样,再通过 scaling law(规模定律)实验反复调整。SmolLM3 的结论方向一致,但具体比例会因为数据源质量和模型目标不同而变化。
- OLMo 2(AllenAI)采用明确的两段式课程:第一阶段以大规模网页数据为主(OLMo-Mix-1124);到后期退火阶段切换到质量更高的 Dolmino-Mix(高质量网页 + 学术资料、问答、数学、合成数据),最后再通过 model soup(多个模型权重平均合并)提升效果。
合成数据同样不能乱加
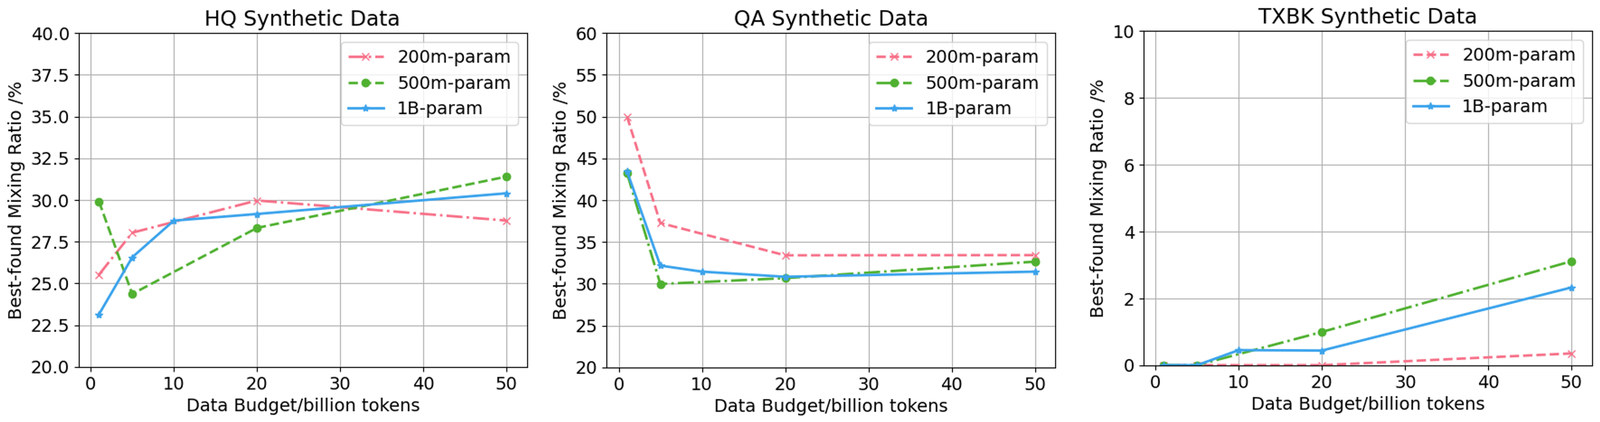
一项覆盖超过 1000 个模型的大规模实证研究发现:重写型合成数据(把已有题目换个说法重新写一遍)和自然真实数据混合时,最优比例通常收敛在 30% 左右。
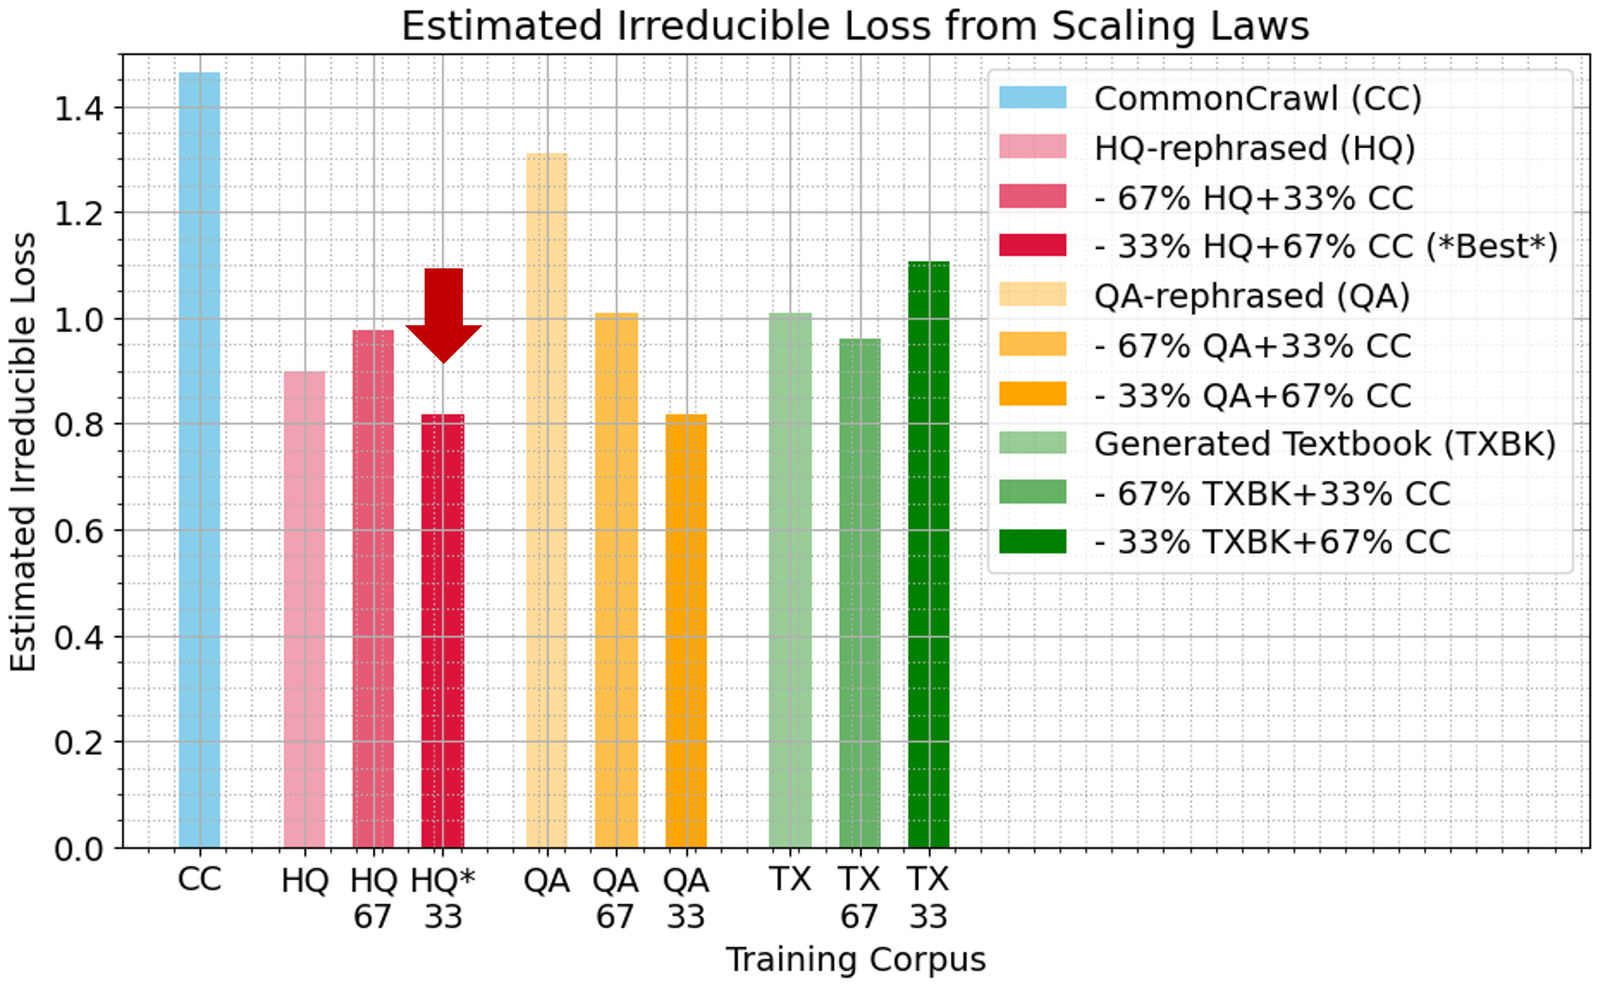
而纯教科书风格、从零生成的数据如果单独使用,在数据预算不大的情况下,多个领域的下游任务表现更差,会出现接近 model collapse(模型退化:越训练越像自己生成的样本、多样性下降) 的特征。真实数据带来的知识多样性和分布覆盖,目前仍然无法被合成数据完全替代。
02分阶段喂数据:先打基础,再磨细节
训练不是把所有数据一次性均匀混好从头跑到尾。更有效的策略是 "先铺覆盖面,后精修能力",类似课程设计:

- 早期阶段(前 8–9T tokens):以基础网页、适量代码、低比例数学和多语言为主,先把知识面铺开。
- 中期:引入质量更高的数学和代码数据(FineMath4+、MegaMath、Stack-Edu 等),向上拓展能力上限。
- 学习率衰减期(最后约 1.1T tokens):再投放高精度推理题和指令数据(OpenMathReasoning、OpenCodeReasoning、OpenMathInstruct 等)。
原因是:模型最终表现很大程度上由训练末尾看到的数据决定。学习率高的时候,模型学得粗、改得快;收尾阶段学习率低,调整得更精细,这时投放 "接近真实考题水平" 的数据,能最大幅度校准模型的任务手感。如果一开始就把稀缺的高质量数据消耗掉,后面只能反复刷低质量内容,性价比很低。
便宜的验证方法:退火消融
为了控制实验成本,行业通用做法是退火消融(annealing ablation):
- 取训练到约 7T 附近的中间 checkpoint(模型存档点);
- 用原来配方的 40% 数据 + 60% 待验证的新数据集,继续训练 50B tokens;
- 几天之内就能看出这批新数据值不值得进入正式主训练。
MegaMath 数据集就是用这个方法验证出来的。这种方式相比从头跑完整 11T 训练,成本低了约两个数量级,同时仍然能保留足够清晰的效果信号。

03自动配比算法:看起来很美,暂时还替代不了人工调参
DoReMi、RegMix 这类方法在论文里表现得很优雅:用小模型或者回归模型去预测最优的数据类别权重。
- DoReMi:用分布鲁棒优化,重点提升表现最差的领域,在 The Pile 数据集上能明显加快下游任务收敛。
- RegMix:训练大量小规模代理模型,拟合 "数据混合比例 → 损失值" 的关系,再把结果外推到大模型上。


但在 SmolLM3 这个量级的实际工程中,这些方法算出来的权重高度接近数据集本身的自然大小分布—— 说白了就是 "哪类数据多就多用哪类",最终效果没有超过人工精心设计的消融实验。
背后原因有三点:
- 代理模型和目标模型存在偏差:规模、训练长度、评估指标都不一样,小模型上学到的规律不能直接套到大模型上;
- 跨领域之间的相互影响、重复训练效应,简单回归公式无法完整刻画;
- 高质量数据的边际收益随重复次数非线性下降—— 第一遍很有用,第二遍收益减半,第五遍基本只剩记忆,这个曲线很难被模型提前拟合出来。
所以目前万亿 token 级训练的配方,仍然更像一门实验室手艺:跑一组小规模实验 → 看关键基准分数 → 调整比例 → 再验证。自动算法可以作为辅助参考,还不能完全取代经验判断和消融实验。
04配方对了,加载细节也可能把训练搞崩
即使配比方案本身没问题,数据加载的工程细节处理不好,同样会造成训练不稳定。
最典型的问题:shuffle(打乱)粒度不够。 很多团队只做了文档级打乱,但同一个 batch(一批同时喂给模型的数据)内部的序列仍然按原始文档顺序读取。如果有一个质量较差的长代码文件,它的内容可以填满整个 batch,导致模型连续学一大批来源相同、质量低的数据,训练损失(loss)出现尖峰。

解决办法:
- 在分词之后,先离线把序列提前打乱;每个训练 epoch(一轮全量遍历)更换随机种子;
- 删除内部重复 n-gram(连续重复词组)特别多的文档。OLMo 2 团队也验证过,这类处理能明显减少 loss 尖峰出现的频率。

其他容易被忽略的约束还有:
- 去重和污染检查必须在配比之前完成,否则配比方案再优,也会被脏数据稀释;
- 质量过滤和配比是相互影响的:过滤太狠,有效数据库存会缩小,后面可调配的余地反而变小;
- mid-training(训练中段)以及长上下文扩展阶段的数据上采样,需要单独做实验验证,不能沿用前期比例,否则可能破坏已经建立好的基础能力。
05给实际团队的结论
- 配比上限由 "不重复的高质量库存" 决定,不是由你想让模型会什么决定。 稀缺数据要谨慎上采样,并且先用退火消融低成本验证。
- 分阶段课程 + 训练末尾投放精细数据,是目前最稳妥的落地路径。
- 自动配比算法有参考价值,但在大规模工业化训练中,系统性消融实验和跨领域权衡判断,仍然是核心竞争力。
- 洗数据、造数据、配数据三步都不能省:前两步保证数据 "能用",最后一步决定模型 "按什么比例、在什么时机学会什么"。
公开技术报告通常只披露最终成型的配方,真正有价值的 Playbook(操作手册)类材料会还原失败路径和工程约束。对实际训练团队来说,更务实的做法是:先搭一套可复用的小规模消融实验框架,明确自己的数据库存、重复训练阈值和关键评估指标,再把方案落到主训练的各个阶段。这比追求 "一键生成最优配比的算法",更接近当前真实的工程现状。
关于 DataMining 北京大学计算机学院软件所博士生团队组建,为大模型与智能体研发提供原创任务数据与可执行评测环境,交付可复现的 Rubric 评分准则、独立可启动的 Harbor Task 容器环境与验证器。文中基准均为公开第三方基准,我们只对齐能力要求与难度区间,不复制题目。官网:datamining.cloud。样例申请与技术对接:contact@datamining.cloud